15 września 2026 roku firma TypeSafe AI zakończyła dwa lata pracy w ukryciu i pokazała Jeva, pierwszy model z kategorii, którą nazwała System One. Ogłoszenie wywołało na Hacker News jedną z żywszych dyskusji tego miesiąca, wątek zbliża się do dwóch tysięcy punktów. Za firmą stoi Diogo Almeida, wcześniej w OpenAI, gdzie zajmował się metodami podążania za instrukcjami; TypeSafe przedstawia tamtą pracę jako badania stojące za ChatGPT.
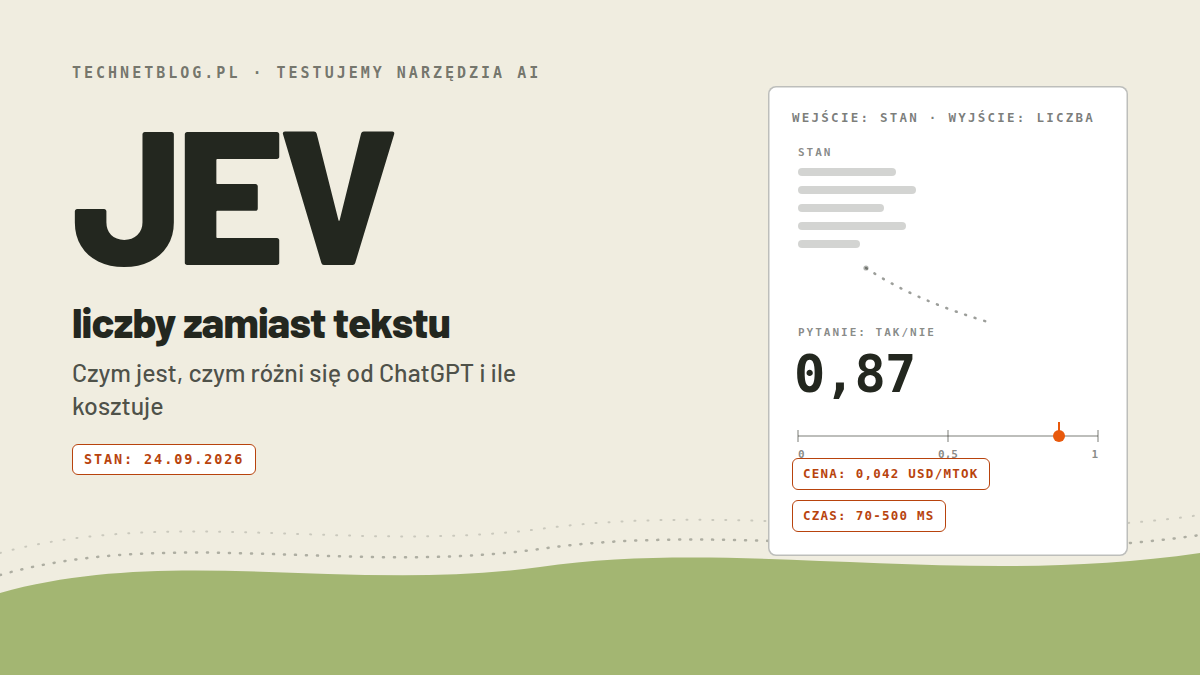
Jev nie generuje tekstu. Wysyłasz mu stan, na przykład artykuł albo zgłoszenie klienta, wraz z pytaniami zdefiniowanymi z góry, a w odpowiedzi dostajesz wyłącznie liczby: prawdopodobieństwa, poziomy pewności, oceny na skali. Formuła z materiałów firmy brzmi: nieustrukturyzowany stan na wejściu, typowane decyzje probabilistyczne na wyjściu.
Tego modelu jeszcze nie testowaliśmy, dostęp rozdawany jest stopniowo z listy oczekujących. Poniższy tekst to zestawienie źródeł: oficjalnych materiałów TypeSafe z 15 września, notki Simona Willisona z 21 września, analizy Johna Berrymana i dokumentacji biblioteki jevals. Stan wiedzy: 24 września 2026. Gdy dostaniemy dostęp i przeprowadzimy własne pomiary, dopiszemy je tutaj.
Spis treści:
- Model, który nie pisze, tylko decyduje
- Jev a ChatGPT
- Ile kosztuje Jev
- Czarna skrzynka z uprzedzeniami
- Co z tego dla Polski
- Źródła
Model, który nie pisze, tylko decyduje
Nazwa kategorii wzięła się od podziału, który Daniel Kahneman opisał w książce „Pułapki myślenia”: szybki, intuicyjny System 1 i wolny, analityczny System 2. Modele System One mają być tym pierwszym, czyli mechanizmem decyzji na poziomie odruchu, z którego program korzysta bezpośrednio, bez czytania i parsowania zdań. Czat LLM generuje tekst token po tokenie; Jev w jednym przebiegu zwraca wartości o typach ustalonych wcześniej przez programistę.
Praktycznie przesyłasz stan i zestaw pytań, a pytania rozliczane są równolegle: czterdzieści pytań w jednym zapytaniu wraca w czasie zbliżonym do jednego, podaje dokumentacja biblioteki jevals. Są trzy typy pytań:
- tak/nie (typ Noul): zgłaszasz tezę, na przykład „ta wiadomość prosi o zwrot pieniędzy”, i dostajesz prawdopodobieństwo od 0 do 1; nazwa Noul pochodzi od rozkładu Bernoulliego, co potwierdził szef TypeSafe w dyskusji na Hacker News;
- wybór: podajesz do 255 opcji, model wskazuje jedną i zwraca rozkład prawdopodobieństwa na wszystkie;
- ocena: definiujesz skalę z opisanymi poziomami, model zwraca liczbę wewnątrz tej skali.
Trening idzie metodą, którą firma nazwała RLCD, od Reinforcement Learning for Calibrated Decisions, zamiast znanego z czatów RLHF. Skutek dla praktyka: każda odpowiedź niesie prawdopodobieństwo i poziom pewności, a wyższa pewność ma się łączyć z wyższą trafnością. TypeSafe reklamuje też brak halucynacji w klasycznym sensie: model nie zwróci kategorii spoza schematu, bo poza schematem nie ma czego zwracać.
Skąd nazwa Jev? Od ekonomisty Williama Stanleya Jevonsa, tego od paradoksu Jevonsa: gdy zasób staje się tańszy i efektywniejszy, jego zużycie rośnie zamiast spadać. TypeSafe zakłada, że z tanią inteligencją będzie tak samo, stąd imiennik. W polskim Google fraza „jevons paradox ai” żyje od dawna; jej bohater właśnie doczekał się modelu swojej nazwy.
Jev a ChatGPT
Pierwsza różnica siedzi w wyjściu. ChatGPT odpowiada tekstem, więc każdy system, który ma dalej działać na tej odpowiedzi, musi ją parsować i ufać, że model nie ubarwił rzeczy, których nie wie. Jev zwraca liczby o znanych z góry typach, więc program dostaje wartość gotową do użycia: próg spamu albo priorytet zgłoszenia. Cena za to jest realna: z Jeva nie wyczytasz uzasadnienia, bo nie ma czego czytać. Model czatowy, na którym opierają się też agenci tacy jak Muse, choć spróbuje się wytłumaczyć, bywa, że zmyśla, ale zawsze dostajesz zdanie do oceny. Przy Jevie zostaje liczba i zewnętrzne testy.
Druga różnica to czas. TypeSafe podaje czasy odpowiedzi 70-500 ms od końca do końca, wobec 3-329 s dla modeli frontier, i z tego wylicza przyspieszenie 40-200 razy przy porównywalnej inteligencji na zadaniach decyzyjnych. To liczby z własnego benchmarku firmy, więc traktowałbym je jako kierunek, nie gwarancję. Nawet z zapasem na optymizm decyzja wracająca w ułamku sekundy nadaje się do wstawienia w pętlę działającą na żywo, na przykład filtrowanie treści w strumieniu wiadomości albo sterowanie botem. Na demo Jev gra w Doom w czasie rzeczywistym, wysyłając około dziesięć zapytań na sekundę.
Właśnie w takich rolach Jev zaczyna być używany. Simon Willison opisał eksperyment z rerankingiem wyszukiwania: BM25 zbiera stu kandydatów, a Jev punktuje dopasowanie każdego do zapytania. Firma Openlayer wydała jevals, bibliotekę ewaluacji i zabezpieczeń dla agentów, która zamiast sędziego LLM wysyła do Jeva całą paczkę pytań w jednym zapytaniu, 37 gotowych kontroli w trzech grupach: jakość, bezpieczeństwo, zachowanie agenta. Ich porównanie: pełny przebieg kontroli dla tysiąca próbek w 0,8 s za 0,03 dolara, podczas gdy metryki Ragas na sędziach LLM brały 22-35 s i 2,60 dolara. Autorzy zmierzyli też 92 do 913 razy mniejszy rozrzut ocen niż u sędziów GPT i Claude. To benchmark dostawcy biblioteki, ale skala różnicy wytrzymuje, nawet jeśli jest przesadzona dwukrotnie.
Trzecia różnica: rzeczy, których Jev nie robi. Dokumentacja Jeva 1.13 ma sekcję o poszarpanych brzegach: gorzej radzi sobie z liczbami, datami i treściami pisanymi tak, żeby go zmylić. Nie zastąpi modelu do wieloetapowego rozumowania ani pisanej krytyki. Na benchmarku JevBench klasyfikacja wychodzi mu na poziomie 83-87% na zbiorach Banking77 i CLINC150, czyli w klasie mniejszych LLM-ów, a kalibracja różni się między zadaniami.
Pytanie, ile z tej przewagi jest trwałych, zadał sobie John Berryman z Arcturus Labs. Jego lektura: mechanika Jeva to najpewniej wyciąganie prawdopodobieństw z tokenów kandydackich zwykłego LLM, technika znana od dawna, więc przewaga musi siedzieć w danych i treningu, a TypeSafe twierdzi, że wszystkie ich dane treningowe są syntetyczne. Gdy fosa jest płytka, OpenAI wchłonie taką klasyfikację do własnych modeli; gdy głęboka, TypeSafe zyskuje pozycję, może nawet na przejęcie. Na razie rynek głosuje nogami: Vercel podaje, że Jev przyjęty został szybciej niż jakikolwiek model w historii ich AI Gateway.
Ile kosztuje Jev
Cennik jest krótki: 0,042 dolara za milion tokenów wejściowych, wyjście darmowe. Liczby na wyjściu faktycznie nic nie kosztują, bo nie generuje się ich token po tokenie. Dla skali: wejście GPT-5 Nano kosztuje 0,05 dolara za milion, ale przy modelach czatowych płacisz także za wyjście, zwykle około pięciokrotnie drożej niż za wejście. Przy zadaniach klasyfikacyjnych, gdzie wejście jest długie, a wyjście to jedna liczba, rachunek wychodzi więc zupełnie inny.
TypeSafe reklamuje na stronie głównej model 193,6 razy szybszy i 444,6 razy tańszy od referencyjnych LLM. Sami przyznają, że to raczej górna granica realnych zysków: benchmark budowała ich ekipa, a modele referencyjne, GPT-6 Astra i Fable 5.1, dostawały pytania przez adapter. Doom z pokazu kosztuje około 7 dolarów na godzinę gry, więc luźne eksperymenty mieszczą się w cenie kawy. Ceny mają schodzić w dół, a serwery stoją dziś na zachodnim wybrzeżu USA, więc do podanych czasów odpowiedzi dolicz z Polski jeszcze podróż przez ocean.
Czarna skrzynka z uprzedzeniami
Brak uzasadnień ma też ciemniejszą stronę. Willison zadał modelowi proste pytanie tak/nie „dobre miasto?” i Jev wystawił najwyższy wynik Cupertino, najniższy East Palo Alto, czyli bogatsze i biedniejsze sąsiedztwa tego samego rejonu Zatoki. Model wchłania świat ze swoich danych treningowych i zwraca go jako liczby z poziomem pewności, które wyglądają obiektywnie. Willison ostrzega wprost przed używaniem takich ocen do rankingu ludzi, na przykład kandydatów do pracy.
Jedyny ratunek to ewaluacje, i tu tania praca Jeva gra na korzyść: przebiegnięcie tysięcy pytań testowych kosztuje grosze, więc zanim podepniesz model pod realny proces, możesz go sprawdzić na własnych danych dziesiątki razy. Kalibrację trzeba jednak mierzyć na każdym zadaniu osobno, bo różni się między nimi, o czym piszą i Willison, i autorzy jevals, a Berryman trafił już na dziedziny, w których prawdopodobieństwa Jeva się nie bronią.
Co z tego dla Polski
Formalnie Jev jest we wczesnym dostępie: zapisujesz się na listę oczekujących w konsoli TypeSafe i czekasz, aż firma będzie wpuszczać kolejne grupy. Krótsza droga prowadzi przez Vercel AI Gateway, który według dokumentacji jevals obsługuje Jeva bez kolejki. API i dokumentacja są po angielsku, ceny w dolarach, polskiego interfejsu nie ma i nikt go nie zapowiedział.
Do zabawy w kodzie wystarczy kilka ścieżek. Wtyczka llm-typesafe Willisona, wydana 22 września, wpina Jeva w jego narzędzie LLM. Biblioteka jevals leży na pipie (Python 3.10, licencja MIT) i ma adaptery do OpenAI Agents SDK, LangGraph oraz Claude Agent SDK, a poza API TypeSafe zadowoli też backend lokalny na Apple Silicon. Kto woli modele bez API, sięga po Kev, otwartą rodzinę wag na Qwen 3.5 w rozmiarach 0.8B, 4B i 9B, wzorowaną na Jevie. Do porównywania jakości służy benchmark JevBench.
Popyt po polsku dopiero się buduje: fraza „jev ai” pojawia się już w podpowiedziach Google, ale „czym jest jev” i „jev llm” wciąż wiszą puste, a samą nazwę zagłuszają Jevil z Deltarune i piwo Jever. Frazy „jev model” nie polecam z kolei do pozycjonowania, bo w wyszukiwarce oznacza wirusa japońskiego zapalenia mózgu. O polskich wdrożeniach na razie cicho, co przy modelu dostępnym od tygodnia nie dziwi.
Źródła
- TypeSafe AI, „Introducing System One Models and Jev”, 15.09.2026, typesafe.ai
- Simon Willison, „Jev introduces a new shape of LLM”, 21.09.2026, simonwillison.net
- Dyskusja nad ogłoszeniem na Hacker News, wrzesień 2026, news.ycombinator.com
- John Berryman, Arcturus Labs, „Will OpenAI eat Jev’s lunch?”, 21.09.2026, arcturus-labs.com
- Openlayer, jevals na GitHub, dokumentacja i benchmarki, stan na 24.09.2026, github.com