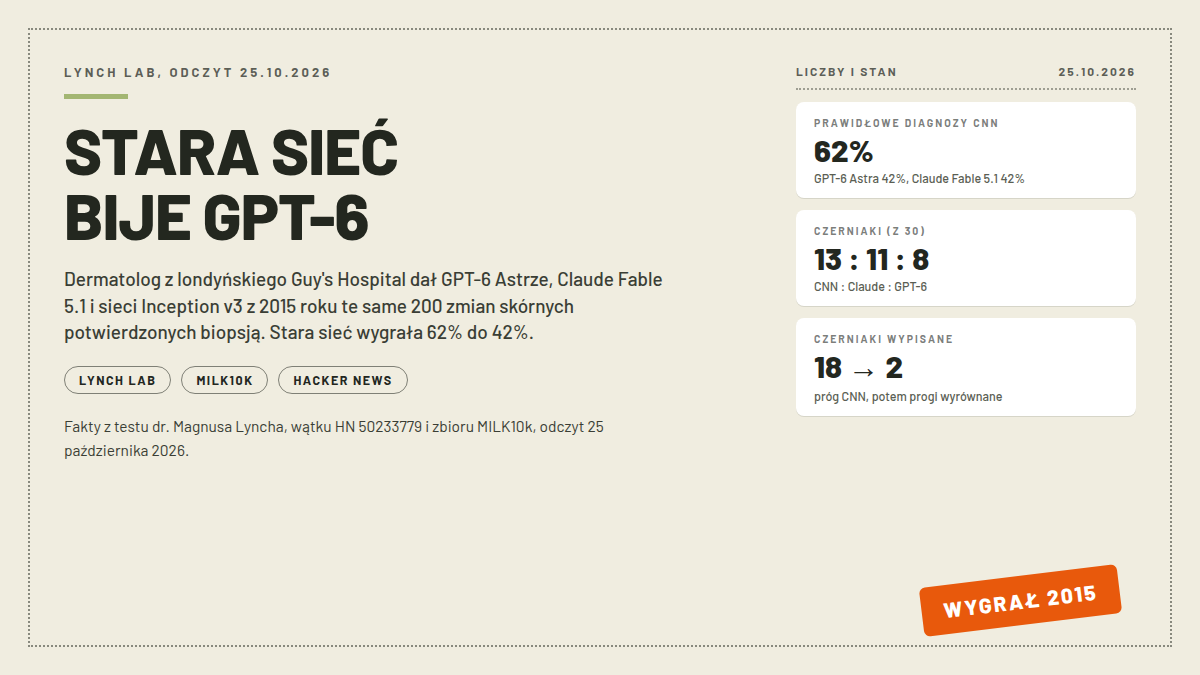
25 października 2026 dermatolog Magnus Lynch z londyńskiego Guy’s Hospital opisał na swojej stronie wynik prostego w zamyśle, trudnego w konsekwencjach eksperymentu. Dał dwóm czołowym modelom językowym, GPT-6 Astrze i Claude Fable 5.1, po 200 zmian skórnych potwierdzonych badaniem histopatologicznym, w tym 30 czerniakom, i poprosił o diagnozę tak, jak zrobiłby to lekarz rodzinny z aplikacją otwartą na monitorze. Do porównania użył sieci Inception v3, konwolucyjnej architektury, którą Google opublikował w 2015 roku, doszlifowanej na dermatologicznych zdjęciach. Stara sieć wskazała prawidłową diagnozę w 125 przypadkach na 200, każdy z LLM-ów w 84 i 85. Model ogólny z 2026 roku przegrał z dziesięcioletnią maszyną 62% do 42%.
Cały zestaw testowy, podpowiedzi i kod oceniający autor udostępnił publicznie, a samą sieć można odpalić w przeglądarce telefonu, także tej z WebGPU, bez wysyłania czegokolwiek na serwer. Dyskusja na Hacker News rozkręciła się w kilka godzin (245 punktów i 117 komentarzy na odczyt z wieczora 25.10); szerszej prasowej relacji nie ma, co zaznaczam, bo to jeszcze jedna strona internetowa lekarza, a nie recenzowane badanie.
- Najważniejsze informacje
- Na czym polegał test
- Wyniki: 62% kontra 42%
- Dlaczego model ogólny przegrywa
- Czy to znaczy, że AI w dermatologii nie działa
- Kontekst: modele, które przegrały, znamy z innych testów
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Test | 200 zmian potwierdzonych histopatologicznie, po 100 groźnych i 100 łagodnych, ze zbioru MILK10k |
| Modele | GPT-6 Astra, Claude Fable 5.1 oraz Inception v3 (2015) douczona na 68 011 zdjęciach z archiwum ISIC |
| Wynik ogólny | CNN 125/200 (62%), GPT-6 Astra 84/200 (42%), Claude Fable 5.1 85/200 (42%) |
| Czerniaki (30) | CNN 13, Claude 11, GPT-6 8 trafnych pierwszych diagnoz |
| Wypisanie bez leczenia | CNN wypisało 18 czerniaków przy domyślnym progu, LLM-y 3 i 4; przy wyrównanym progu 2 lub 1 |
| Bezpieczna odpowiedź pacjenta | Poproszone o poradę „czy iść do lekarza”, LLM-y kierowały do specjalisty w 99 i 98 na 100 przypadków czerniaka |
| Ujawnienie konfliktu | Analizę i wstępne wersje tekstu Lynch pisał z Claude Code, jedną z testowanych sieci jest model Anthropicu |
Na czym polegał test
Zbiór MILK10k, udostępniony w 2025 roku przez International Skin Imaging Collaboration, zawiera pary zdjęć każdej zmiany: zbliżenie kliniczne oraz obraz dermatoskopowy, robiony przez podświetlaną lupę, której używa dermatolog. Lynch wylosował 200 zmian, każdą potwierdzoną biopsją: 100, których nie wolno wypuścić (30 czerniaków, 25 raków podstawnokomórkowych, 25 raków płaskonabłonkowych i 20 rogactwa słonecznego) oraz 100 bezpiecznych (50 znamion i 50 brodawek łojotokowych). Każda z tych zmian kiedyś tak zaniepokoiła lekarza, że trafiła na biopsję, więc to cięższy materiał niż przeciętna galeria zdjęć.
Każdy z LLM-ów dostawał oba zdjęcia i polecenie w stylu klinicznym: podaj najbardziej prawdopodobną z sześciu diagnoz albo napisz „nie jestem pewien”, dołącz pewność, drugą propozycję i odpowiedź na pytanie, czy zmianę można bezpiecznie wypuścić bez leczenia, biopsji i obserwacji. Te same ustawienia domyślne, żadnych odmów. Inception v3 dostała oba obrazy tego samego pacjenta, ważone w stronę dermatoskopii, i wybierała z tej samej szóstki. Zdjęcia testowe usunięto z jej danych treningowych przed douczaniem, więc widziała je po raz pierwszy.
Wyniki: 62% kontra 42%
| Diagnoza prawidłowa | GPT-6 Astra | Claude Fable 5.1 | CNN |
|---|---|---|---|
| Wszystkie (z 200) | 84 (42%) | 85 (42%) | 125 (62%) |
| Czerniak (z 30) | 8 | 11 | 13 |
| Rak podstawnokomórkowy (z 25) | 25 | 18 | 24 |
| Rak płaskonabłonkowy (z 25) | 12 | 5 | 16 |
| Rogactwo słoneczne (z 20) | 10 | 12 | 9 |
| Znamiona (z 50) | 16 | 33 | 37 |
| Brodawki łojotokowe (z 50) | 13 | 6 | 26 |
Każdy model miał swojego faworyta. GPT-6 Astra nazwała 75 zmian rakami podstawnokomórkowymi, gdy takich było 25, w tym 14 z 30 czerniaków. Claude Fable 5.1 wypatrzyła 53 rogactwa słoneczne, gdy prawdziwych było 20. Błędy CNN szły w drugą stronę: z 17 pomylonych czerniaków 8 skatalogowała jako znamiona, 6 jako brodawki łojotokowe.
Najciekawszy wiersz tej tabeli to jednak wypisy. Przy własnym, konserwatywnym progu CNN wypuściła do domu 18 czerniaków z 30. Gdy Lynch wyrównał progi tak, żeby sieć była tak samo ostrożna jak LLM-y, liczba spadła do 2 lub 1. Modele językowe i tak są pod tym względem bezpieczne: na 100 dalszych czerniaków, o które pytano je z pozycji pacjenta, zaleciły wizytę u lekarza w 99 i 98 przypadkach. Problem nie leży więc w tym, że LLM zwolni groźną zmianę, tylko w tym, że przy wojskowym poziomie ostrożności diagnozuje dużo gorzej.
Dlaczego model ogólny przegrywa
Komentarze pod Hacker News zebrały się wokół jednej tezy: nikt nie obiecywał, że LLM będzie świetnym dermatologiem. „LLM-y mają być ogólnie inteligentne. Są nierówne w tych obszarach, na których laboratoria frontowe robią benchmarki, czyli oprogramowanie i matematyka, i nie są zaprojektowane ani oczekiwane, by były świetne we wszystkim. Ogólna inteligencja odblokowuje nowe przepływy pracy, nie doskonali istniejących” (fastball). Inny komentujący ujął to obrazowo: „To trochę jak porównanie radiologa z 20-letnią praktyką i IQ 100 z sześciolatkiem z przetestowanym IQ 130 i obserwowanie, jak radiolog rozbija dziecko” (spwa4).
Część dyskusji podeszła ostrożniej. Uwaga „benchmaxxing” trafia w sedno metody: CNN douczano na 68 011 zdjęciach z dokładnie tej domeny, więc jej przewaga to w dużej mierze efekt specjalizacji, a nie architektury (Legend2440). Autor tego zastrzeżenia pisze o kruchości takich modeli na zdjęciach „z dzikiej natury”. Lynch sam dodaje drugie zastrzeżenie: MILK10k jest publiczny od 2025 roku, więc żadnego z LLM-ów nie można wykluczyć z treningu na tych danych. Gdyby tak było, wypadłoby to na ich korzyść, a mimo to przegrały.
Trzecia lekcja dotyczy ekonomii. Gdy potrzebujesz systemu do jednego, konkretnego zadania na skalę, dedykowany klasyfikator pozostaje tańszy i celniejszy, a LLM świetnie nadaje się do zbudowania prototypu takiego systemu (snitty z wątku: „po prostu użyj LLM-a, żeby zrobił coś, co jest naprawdę dobre w tym, czego potrzebujesz”). Ten sam wzorzec widzieliśmy w testach narzędzi na tym blogu: model uniwersalny wygrywa elastycznością, specjalista liczbami.
Czy to znaczy, że AI w dermatologii nie działa
Nie. Lynch pisze wprost, że Inception v3 to baseline, nie czołówka: współczesne systemy dermatologiczne używają zespołów transformerów wizyjnych trenowanych na większych zbiorach, a regulowane produkty zbudowane na nich „wypadają znacznie lepiej”. Na zwykłych zdjęciach z archiwum ISIC ta sama sieć osiągała AUC 0,96, wobec 0,86 na trudnym zestawie biopsyjnym. Wynik testu pokazuje raczej granicę interfejsu: wrzucenie dwóch zdjęć do czatu ogólnego to nie to samo, co narzędzie zaprojektowane przez dermatologów i sprawdzone klinicznie.
Dla pacjenta, który dziś wkleja zdjęcie znamienia do czatu, z testu płynie dobra wiadomość. Oba modele w trybie pacjenta kierowały do lekarza praktycznie zawsze, łącznie ze zmianami zupełnie niegroźnymi. Przestraszą, ale nie uspokoją fałszywie. Gorzej wypada zaufanie do odwrotnej decyzji: gdy czat powie „to tylko brodawka, śpij spokojnie”, to zdanie nie ma pokrycia w tym teście.
Samą sieć uruchomisz bez konta: strona demo działa w przeglądarce przez WebGPU, nic nie jest wysyłane na serwer, a przycisk losowania czerpie z tych samych 200 zmian testowych. Komplet danych, wszystkich odpowiedzi LLM-ów i kodu oceniającego Lynch udostępnia jednym pakietem, a zbiór MILK10k ma przypisany DOI. Dla kogoś, kto buduje narzędzia medyczne, to gotowy szkielet do powtórzenia eksperymentu.
Kontekst: modele, które przegrały, znamy z innych testów
GPT-6 Astra i Claude Fable 5.1 to dla nas nie anonimy: oba modele opisywaliśmy na tym blogu, Astrę w recenzji po premierze, a Fable 5.1 przy sprawie ukrytych wiadomości w obrazach. Test Lyncha dokłada do ich akt jedną, twardą liczbę z domeny, w której bardziej się spieszą z obietnicami niż z dowodami. Nie zmienia to faktu, że ogólne modele robią za dużo rzeczy dobrze, żeby je wyrzucić. Zmienia to tylko to, gdzie ich nie należy stawiać.
Źródła
- Lynch Lab, „A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis”, dr Magnus Lynch, 25.10.2026 (odczyt 25.10.2026): https://lynchlab.net/llm-skin-cancer
- Demo sieci Inception v3 w przeglądarce (WebGPU, odczyt 25.10.2026): https://lynchlab.net/skin-ai-inception
- Zbiór testowy MILK10k, DOI z artykułu (odczyt 25.10.2026): https://doi.org/10.34970/648456
- Hacker News przez API Algolii, pełne drzewo dyskusji 50233779 (odczyt 25.10.2026): https://hn.algolia.com/api/v1/items/50233779
- International Skin Imaging Collaboration, archiwum ISIC, źródło danych douczających: https://www.isic-archive.com