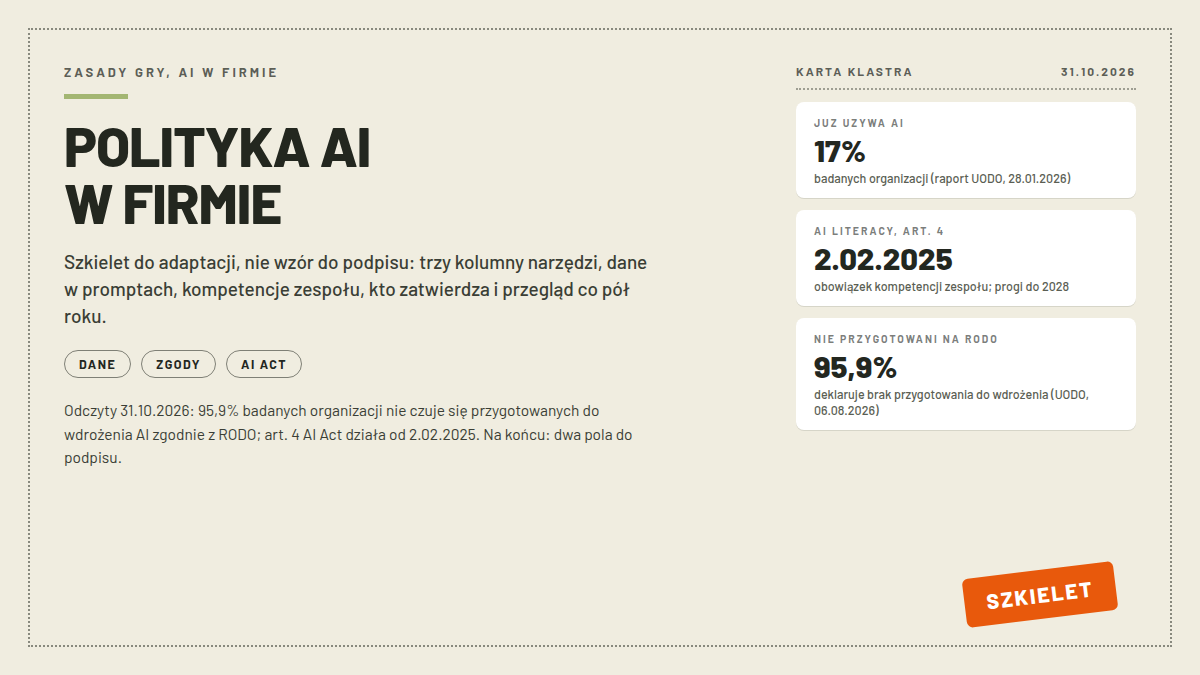
Google pod frazą „polityka ai w firmie” podpowiada „wzór”, a fraza „regulamin korzystania z ai w pracy” oznacza to samo oczekiwanie: dokument do wklejenia i podpisu. Uczciwie: takiego dokumentu tu nie będzie. Polityka przepisana z cudzego szablonu reguluje cudze narzędzia, cudze dane i cudze decyzje, więc trafia do szuflady zanim zdąży coś zmienić. Ten tekst daje to, co da się dać na początku: szkielet siedmiu sekcji z pytaniami, na które firma odpowiada własnymi faktami. To narzędzie pracy, nie wzór do druku. Argument za tym, żeby pisać zasady zanim jest problem, przynosi komunikat UODO z 06.08.2026: od 41 do 58,5% badanych podmiotów nie dostrzega związku między narzędziami AI a przetwarzaniem danych osobowych, a 95,9% nie uważa się za przygotowane do wdrożenia AI zgodnie z RODO. W tym samym komunikacie urząd opisuje praktykę jednym zdaniem: pytanie o zgodność pada zwykle wtedy, gdy narzędzie już działa, a rozstrzygnięcia o danych i dostawcy zapadły wcześniej. Metoda tego tekstu to odczyty źródeł z datami (stan na 31.10.2026); nie testowaliśmy żadnego narzędzia, a tekst nie jest poradą prawną.
- Najważniejsze informacje
- Trzy kolumny narzędzi: dopuszczone, na zgodę, zakazane
- Dane w promptach: RODO, tajemnica przedsiębiorstwa, kod
- AI literacy od 2.02.2025: obowiązek, nie formalność
- Kto zatwierdza narzędzia i gdzie leci eskalacja
- Człowiek zatwierdza wynik przed użyciem zewnętrznym
- Przegląd co pół roku, bo oś AI Act się rusza
- Osobna polityka dla programistów: vibe coding
- Na końcu: decyzja, nie przepis
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły (odczyty 31.10.2026) |
|---|---|
| Status tekstu | szkielet do adaptacji: sekcje i pytania do odpowiadania własnymi faktami, nie dokument do podpisu |
| AI literacy | art. 4 AI Act obowiązuje od 2.02.2025: „do najlepszego wysiłku” wystarczający poziom kompetencji zespołu, bez gwarancji konkretnego poziomu |
| Kolejne daty AI Act | egzekucja i AI Office od 2.08.2026; aneks III (m.in. zatrudnienie) od 2.12.2027; aneks I od 2.08.2028 (oś po nowelizacji AI Omnibus) |
| Rynek | 17% organizacji w badaniu UODO już używa AI; najczęściej automatyzacja procesów administracyjnych (41,2%) i analityka danych (31%) (raport 28.01.2026) |
| Darmowe vs biznesowe | Gemini Apps: „używamy czatów, żeby ulepszać modele”; M365 Copilot: prompty i odpowiedzi nie trenują modeli; OpenAI Business/Enterprise: „We do not train our models on your data by default” |
| Przegląd polityki | co pół roku; progi AI Act wchodzą w latach 2026-2028, polityka pisana raz nie nadąży |
Trzy kolumny narzędzi: dopuszczone, na zgodę, zakazane
Polityka korzystania z narzędzi ai zaczyna się od jednej reguły: o przypisaniu do kolumny nie decyduje nazwa narzędzia, tylko miejsce, w którym lądują dane, gdy je wpisujesz. Czat działający jak publiczna usługa konsumencka, konta firmowe z umową i narzędzia lokalne przetwarzają dane według trzech różnych reguł, więc podział na trzy kolumny jest najprostszym wyjściem. Pierwsza kolumna: dopuszczone bez dodatkowej zgody, zwykle zadania bez danych firmy (tłumaczenie publicznego tekstu, szkic tekstu od zera). Druga: wymagające zgody wyznaczonej osoby, tam gdzie do prompta może trafić treść służbowa. Trzecia: zakazane, bo dane w tej formie nie mogą opuścić firmy.
Granice między kolumnami najlepiej ustawiać przykładami zamiast definicji. Wklejenie fragmentu umowy z klientem do darmowego czatu na prywatnym koncie trafia do trzeciej kolumny w każdej sensownej wersji polityki: dane klienta opuszczają firmę w nieokreślonym kierunku. Sumaryczne statystyki sprzedaży bez nazw klientów w koncie firmowym siedzą w kolumnie drugiej. Pytanie kontrolne na granicy brzmi: gdyby pracownik wypisał fragment prompta na kartkę i wyszedł z nią z budynku, czy ktoś zapytałby o powód? Jeśli tak, to samo dotyczy czatu. Perspektywę pracownika opisujemy osobno w tekście o tym, jak używać AI w pracy; polityka patrzy na ten sam temat od strony firmy.
Dane w promptach: RODO, tajemnica przedsiębiorstwa, kod
Dane firmowe dzielą się na trzy rodziny o różnej wadze i każda potrzebuje własnego zdania w polityce. Dane osobowe klientów i pracowników podlegają RODO, więc ich przetwarzanie przez zewnętrzną usługę to decyzja z pełną dokumentacją, nie nawyk. Informacje stanowiące tajemnicę przedsiębiorstwa (cenniki własne, wyceny, baza kontaktów, wyniki negocjacji) tracą ochronę w momencie ujawnienia, więc polityka wypisuje je listą kategorii i zamyka w kolumnie zakazanej albo wymagającej narzędzi z umową. Kod źródłowy stoi osobno, bo oprócz sekretów niesie licencje i klucze; wracamy do niego w osobnej sekcji.
Klauzule treningowe darmowych i płatnych planów da się odczytać z polityk dostawców. Hub prywatności Gemini Apps (odczyt 31.10.2026) pisze wprost: Google używa czatów, „żeby ulepszać modele oraz poprawiać odpowiedzi aplikacji z Gemini”, z wyjątkami: czaty tymczasowe nie są używane do trenowania modeli, a przy wyłączonej aktywności i braku opinii przyszłe czaty też nie trafiają do ulepszania. OpenAI na stronie enterprise-privacy (live 403 z naszej sieci, odczyt z snapshotu Wayback z 28.10.2026) o koncie konsumenckim pisze, że dane użytkowników ChatGPT służą do treningu, a o ścieżce biznesowej: „We do not train our models on your data by default”. Microsoft w dokumencie M365 Copilot (odczyt 31.10.2026) obiecuje, że „Prompts, responses, and data accessed through Microsoft Graph aren’t used to train foundation LLMs”. Anthropic w warunkach komercyjnych (odczyt 31.10.2026) zapisuje: „Anthropic may not train models on Customer Content from Services”. Z tych czterech odczytów wychodzi prosta linia dla polityki: darmowe konta konsumenckie traktuj jako publiczne, konta firmowe z umową jako zaufane, a różnicę zapisz wprost, żeby praca służbowa nie przepływała na prywatne darmowe konta.
Lista pytań do własnej firmy przy tej sekcji jest krótka: które kategorie danych w ogóle mają prawo wjechać w prompt (rodziny z pierwszego akapitu), na jakich kontach (darmowe prywatne, firmowe z umową, lokalne), co dzieje się z danymi po stronie dostawcy (retencja, trening, recenzenci) i kto to odczytał z polityki dostawcy z datą. UODO opublikowało w sierpniu 2026 listy pytań inicjalnych w czterech wariantach, w tym dla małych i średnich firm korzystających z gotowych systemów, i zastrzega wprost, że pytania nie zastąpią analizy ryzyka ani nie przesądzają zgodności z RODO. Księgowość łączy tu obie rodziny danych (faktury, dane pracowników); mapę tego obszaru dajemy w tekście o AI w księgowości.
AI literacy od 2.02.2025: obowiązek, nie formalność
Od 2 lutego 2025 r. obowiązuje art. 4 aktu o AI, mówiący wprost, że dostawcy i stosujący systemy AI „shall take measures to ensure, to their best extent, a sufficient level of AI literacy” wobec personelu obsługującego te systemy, z uwzględnieniem wiedzy technicznej, doświadczenia, wykształcenia i kontekstu użycia (odczyt 31.10.2026). Ten sam przepis dodaje uspokajające zdanie: obowiązek nie wymaga gwarantowania żadnego konkretnego poziomu kompetencji. Frazy „ai literacy co to” i „ai literacy po polsku” w autouzupełnianiu pokazują, że pojęcie dopiero szuka swojej polskiej nazwy; po polsku najbliżej znaczenia jest „kompetencje w zakresie AI”.
Polityka wpisuje się w ten obowiązek praktycznie: papier, który mówi kto, czym i do czego może pracować, jest jednocześnie śladem, że firma zajmuje się kompetencjami zespołu. Krótkie przykłady dobrych i złych promptów, jednostronicowa ściąga trzech kolumn, rozmowa przy włączeniu nowego pracownika to trening zgodny ze skalą małej firmy; kurs zewnętrzny to decyzja osobna, nie warunek startu. Komunikat UODO z 06.08.2026 podaje tło: 41-58,5% badanych nie widzi związku między AI a danymi osobowymi, więc samo nazwanie tego związku w polityce już przesuwa wynik. Daty obowiązków opisujemy szerzej w osobnym tekście o AI Act w firmie; w tym miejscu wystarcza zdanie: literacy to pierwszy obowiązek z tego aktu, który zaczął działać, a kolejne progi wchodzą w latach 2026-2028.
Kto zatwierdza narzędzia i gdzie leci eskalacja
Sekcja, bez której polityka rozpada się na luźne zapiski, nazywa osobę i ścieżkę. W firmie z kilkunastu ludźmi wyznaczanie „właściciela AI” brzmi patetycznie, chodzi o nazwanie jednej osoby, która zatwierdza narzędzia do pierwszej kolumny i rozpatruje zgody z drugiej. Bez tego nazwiska decyzje rozkręcają się samoczynnie: narzędzie wchodzi przez prywatne konto jednego pracownika, po miesiącu używa go cały dział, nikt nie wie, na jakich warunkach. Etap „zasady gry” w większym procesie wdrożenia opisujemy w tekście o wdrożeniu AI w firmie; tu zostaje jego papierowy wynik.
Ścieżka eskalacji to druga połowa tej sekcji i powinna odpowiadać na trzy sytuacje zamiast stu: pracownik wkleił za dużo (co robi natychmiast: zgłoszenie komu, jakie kroki po stronie konta i dostawcy), chce nowe narzędzie (kto decyduje, w jakim czasie, jakie pytania padają), dostawca zmienił warunki (kto odczytuje powiadomienia i czy przegląd polityki uruchamia się poza harmonogramem). UODO w komunikacie o pytaniach inicjalnych wskazuje przy okazji stały błąd kolejności: pytanie o zgodność pada po decyzji, więc sensowna eskalacja działa też w odwrotnym kierunku, od pytania do decyzji, nie od decyzji do naprawy.
Człowiek zatwierdza wynik przed użyciem zewnętrznym
Piąta sekcja szkieletu jest krótka w zapisie i najczęściej testowana w praktyce: wynik opuszcza firmę tylko po człowieku. Mail do klienta, oferta, opis produktu na stronie, pismo, komunikat w mediach społecznościowych: wszystko, co ma odbiorcę na zewnątrz, przechodzi przez osobę, która czyta całość i podpisuje się własnym nazwiskiem. Modele piszą płynnie i nieprawdziwie równie łatwo, co płynnie i poprawnie, więc kontrola brzmi banalnie, ale to z niej wypada najwięcej: nazwy, liczby, nazwiska, terminy. Podstawy działania tych narzędzi wyjaśniamy w tekście o tym, czym jest chatbot; tu wystarczy stwierdzenie, że odpowiedzialność za treść nie przenosi się na narzędzie i nigdy nie przeniesie.
Przegląd co pół roku, bo oś AI Act się rusza
Sześć miesięcy to rytm przeglądu, który da się utrzymać bez osobnej funkcji w firmie: raz na pół roku ktoś otwiera politykę, odczytuje na nowo polityki dostawców i sprawdza, czy kolumny wciąż odpowiadają rzeczywistości. Wykres dat po stronie prawa przypomina, dlaczego to nie teoria: od 2.08.2026 działa egzekucja i AI Office, od 2.12.2027 dochodzi oś systemów wysokiego ryzyka z aneksu III (w tym zatrudnienie i rekrutacja), a aneks I wchodzi od 2.08.2028; oś po nowelizacji AI Omnibus potwierdzona na stronie Komisji Europejskiej (odczyt 31.10.2026). Rekrutacja i monitoring pracowników to dla wielu firm pierwsze systemy, które spadną w reżim wysokiego ryzyka, i polityka powinna zostawić na ten przypadek puste miejsce z pytaniem „co się zmienia w tej sekcji po 2.12.2027”.
Osobna polityka dla programistów: vibe coding
Zespół techniczny potrzebuje osobnego arkusza zasad, bo kod łączy trzy rodzaje wrażliwości naraz: sekrety techniczne (klucze API, hasła w konfiguracji, adresy serwerów), własność intelektualną (licencje podpatrzonego kodu) i dane klientów w zrzutach stack trace. Polityka biurowa zakazująca wklejania umów nie opisuje sytuacji „wkleiłem repozytorium, żeby model poprawił testy”, a to codzienne pytanie programisty. Wzorzec prywatny kontra firmowy działa jak w sekcji drugiej: prywatne konto konsumenckie do nauki i własnych projektów, konta firmowe z umową do kodu służbowego, przegląd diffów przed commitem jako odpowiednik „człowiek zatwierdza wynik”. Agenci piszący kod w pętli to decyzja osobna od polityki korzystania z czatów; ścieżkę budowania ich we własnym zakresie opisujemy w tekście jak stworzyć agenta AI, bez rozpisywania jej tutaj.
Na końcu: decyzja, nie przepis
Szkielet zamienia się w politykę w momencie, gdy ktoś wypełni go faktami firmy i podpisze się pod dwoma polami, których w tym tekście nie da się podpowiedzieć: imię i nazwisko właściciela procesu oraz data pierwszego przeglądu. Reszta to praca na odczytach: lista narzędzi w trzech kolumnach, spis kategorii danych, nazwisko do eskalacji, rytm półroczny. Gdy skala urośnie, dane wejdą do rejestru, a pojawią się systemy spadające w reżim wysokiego ryzyka; wtedy dochodzą decyzje na poziomie prawnym, a prawnicy i kancelarie zajmujące się tym zakresem istnieją na rynku jako osobna opcja zakupowa. Cały klaster, w którym polityka jest jednym z etapów, trzyma hub AI w firmie; ten tekst zostaje przy tym, co pewne na 31.10.2026: struktura siedmiu sekcji, daty AI Act po nowelizacji i klauzule dostawców z odczytami.
Najczęstsze pytania
Polityka AI w firmie: gdzie znaleźć wzór?
Gotowego wzoru do podpisu nie da się uczciwie podać w ogólnym tekście, bo polityka wynika z konkretnych narzędzi firmy, jej danych i umów. Ten tekst daje strukturę: siedem sekcji szkieletu z pytaniami, które firma odpowiada własnymi faktami. UODO opublikowało 06.08.2026 listy pytań inicjalnych w czterech wariantach, w tym dla małych i średnich firm korzystających z gotowych systemów AI; to najbliższy publicznie dostępny odpowiednik wzoru.
Regulamin korzystania z AI w pracy: co powinien zawierać?
Minimum z tego szkieletu: trzy kolumny narzędzi (dopuszczone, na zgodę, zakazane) z kryterium „gdzie lecą dane”, kategorie danych zakazanych w promptach, zapis o klauzulach treningowych darmowych kontra firmowych kont, nazwisko osoby zatwierdzającej i ścieżka eskalacji, zasada „człowiek zatwierdza wynik przed użyciem zewnętrznym”, termin przeglądu co pół roku.
Czym jest AI literacy i czy firma musi go zapewniać?
To kompetencje zespołu w zakresie AI: umiejętność oceny możliwości i ryzyk tych narzędzi (art. 3 pkt 56 aktu o AI). Od 2.02.2025 art. 4 wymaga od firm stosujących AI podejmowania środków, „aby zapewnić, do najlepszego wysiłku, wystarczający poziom” tych kompetencji, jednocześnie nie wymagając gwarantowania konkretnego poziomu. Polityka z listą dozwolonych zastosowań i krótka ściąga dla zespołu spełniają ten obowiązek w skali małej firmy.
AI Act w firmie: co już obowiązuje?
Od 2.02.2025: zakazy praktyk wysokiego ryzyka oraz obowiązek AI literacy (art. 4). Od 2.08.2026: egzekucja i AI Office. Po nowelizacji AI Omnibus systemy wysokiego ryzyka z aneksu III (m.in. zatrudnienie i rekrutacja) wchodzą od 2.12.2027, a aneks I od 2.08.2028 (oś potwierdzona na stronie Komisji Europejskiej, odczyt 31.10.2026).
Jak ograniczyć korzystanie przez pracowników z modeli AI?
Trzy kolumny zamiast zakazu generalnego: pracownik zawsze ma kolumnę dopuszczoną (zadania bez danych firmy), więc zakaz nie popycha korzystania do prywatnych kont. Do tego firma konta służbowe z umowami o braku treningu, ściąga „czego nie wklejać” i nazwisko, do którego leci pytanie o nowe narzędzie. Zapis o szybkim zgłaszaniu, że coś wklejono za dużo, bywa w praktyce ważniejszy niż lista zakazów.
Polityka korzystania z AI w urzędzie: czym się różni?
Urzędy działają w reżimie legalizmu: każde przetwarzanie danych potrzebuje podstawy prawnej, a dokumentacja jest gęstsza niż w firmie prywatnej. UODO przygotowało na ten przypadek osobny zestaw pytań inicjalnych dla sektora publicznego (obok wariantu dla MŚP, wersji 0 dla budujących własne modele i wersji rozszerzonej łączącej RODO z AI Act), co opisuje komunikat z 06.08.2026.
Źródła
- Komisja Europejska, „AI Act” (oś czasu zastosowania: 1.08.2024 wejście w życie, 2.08.2026 zastosowanie z wyjątkami; zakazy i AI literacy od 2.02.2025; GPAI od 2.08.2025; aneks I do 2.08.2028; aneks III do 2.12.2027 po porozumieniu; egzekucja i AI Office od 2.08.2026), https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai (odczyt 31.10.2026)
- artificialintelligenceact.eu, art. 4 „AI literacy” (obowiązek zapewnienia wystarczającego poziomu kompetencji „to their best extent” wobec personelu; bez gwarancji konkretnego poziomu; definicja z art. 3 pkt 56), https://artificialintelligenceact.eu/article/4/ (odczyt 31.10.2026)
- UODO, „Zanim wdrożysz narzędzie AI, sprawdź czy jest ono zgodne z zasadami RODO”, 06.08.2026 (41-58,5% podmiotów nie dostrzega związku AI-dane osobowe; 95,9% nie czuje się przygotowanych; „Pytanie o zgodność pada zwykle wtedy, gdy narzędzie już działa”; listy pytań inicjalnych w 4 wariantach, w tym MŚP i sektor publiczny; zastrzeżenie: pytania nie zastąpią analizy ryzyka), https://uodo.gov.pl/pl/138/4533 (odczyt 31.10.2026, data publikacji wg Google News RSS)
- UODO, „Jak organizacje korzystają ze sztucznej inteligencji i jakie mają potrzeby z tym związane?”, 28.01.2026 (Raport Strategiczny: 17% badanych organizacji używa AI; automatyzacja procesów administracyjnych 41,2%; analityka danych 31%), https://uodo.gov.pl/pl/589/4058 (odczyt 31.10.2026, data publikacji wg Google News RSS)
- Google, „Centrum prywatności dotyczące aplikacji z Gemini” (czaty używane „żeby ulepszać modele oraz poprawiać odpowiedzi aplikacji z Gemini”; czaty tymczasowe bez treningu, retencja 72 h; wyłączona aktywność bez opinii = przyszłe czaty bez ulepszania; domyślna retencja aktywności 18 miesięcy; czaty sprawdzone przez weryfikatorów nie są usuwane), https://support.google.com/gemini/answer/13594961?hl=pl (odczyt 31.10.2026)
- Microsoft, „Data, privacy, and security for Microsoft 365 Copilot” („Prompts, responses, and data accessed through Microsoft Graph aren’t used to train foundation LLMs, including those used by Microsoft Copilot”; zgodność z GDPR i EU Data Boundary), https://learn.microsoft.com/en-us/microsoft-365/copilot/microsoft-365-copilot-privacy (odczyt 31.10.2026)
- OpenAI, „Enterprise privacy at OpenAI”, wersja „Updated: January 8, 2026” („We do not train our models on your data by default” dla ChatGPT Business/Enterprise/Edu i API; dane użytkowników ChatGPT używane w treningu modeli konsumenckich; live openai.com 403 z naszej sieci, odczyt z snapshotu Wayback), http://web.archive.org/web/20261028151734/https://openai.com/enterprise-privacy/ (odczyt 31.10.2026)
- Anthropic, „Commercial Terms of Service” („Anthropic may not train models on Customer Content from Services”; klient zachowuje prawa do Inputs i ma wyodrębnione Outputy; przetwarzanie wg DPA), https://www.anthropic.com/legal/commercial-terms (odczyt 31.10.2026)