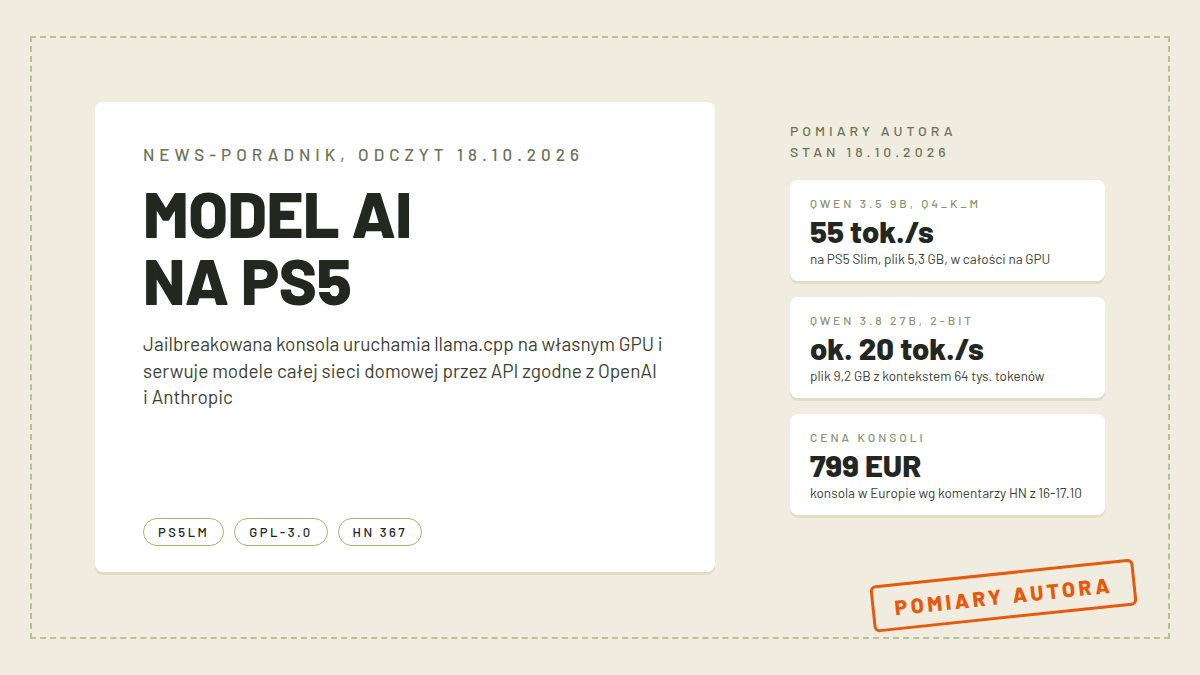
Na półce obok telewizora stoi konsola za cenę średniej karty graficznej, ma 16 GB pamięci GDDR6 współdzielonej przez procesor i GPU, i prawie nikt nie myślał o niej jako o serwerze modeli językowych. Projekt PS5LM zamienia taką konsolę w serwer llama.cpp: model GGUF ładuje się na GPU PlayStation 5, a laptop, telefon i narzędzia do kodowania odwołują się do niego po sieci lokalnej przez API zgodne z OpenAI i Anthropic. Bez komputera w tle, bez chmury, bez konta. Najnowsze wydanie aplikacji (v0.9.0) ukazało się 16 października 2026, w dniu, gdy dyskusja o projekcie trafiła na Hacker News i zebrała 367 punktów.
Sprzętowo to ciekawszy układ niż mogłoby się wydawać, bo 11,4 GB wspólnej pamięci na model i kontekst to spory zasób jak na urządzenie stojące pod telewizorem. Jest tylko wysoki próg wejścia: konsola musi być jailbreakowana na firmware między 7.00 a 13.60, co oznacza koniec gier online i obowiązek trzymania się z dala od aktualizacji systemu. Ten tekst rozkłada projekt na części: co działa, jakie prędkości deklaruje autor, co mówią ludzie, którzy już to odpalili, i gdzie kończy się sens zabawy.
- Co to jest PS5LM
- Jak to działa: GPU konsoli, Vulkan i pamięć
- Jakie modele i jakie prędkości
- Zanim cokolwiek uruchomisz: jailbreak
- Instalacja aplikacji i pobranie modelu
- Podłączenie narzędzi: curl, opencode, Claude Code
- Modele decyzyjne przez Ollaya
- Ile to kosztuje
- Ograniczenia, które trzeba brać pod uwagę
- Najczęstsze pytania
- Nota o zakresie
Co to jest PS5LM
PS5LM to natywna aplikacja na PlayStation 5 (numer tytułu PPSA99575), pisana w C++, licencjonowana na GPL-3.0. W środku pracuje llama.cpp z backendem Vulkan, a cała reszta to obudowanie go stroną dla telewizora i serwerem API. Autor (cobanov, repo utworzone 1 października 2026) podchodzi do tematu poważnie: aplikacja ma pięć ekranów sterowanych z pada, pobiera modele wprost z Hugging Face, planuje kontekst i cache do wolnej pamięci oraz pokazuje wykresy temperatury i poboru mocy konsoli.
Pomysł nie wziął się znikąd. We wrześniu 2026 ProsperoAI pokazał, że da się uruchomić Qwen 3.5 9B na GPU konsoli, ale pisał własne kernele AGC pod każdy model osobno i obsługiwał tylko kwantyzację Q4_0. PS5LM idzie o poziom wyżej: korzysta z llama.cpp, więc obsługuje każdą architekturę i kwantyzację, którą zna llama.cpp, od 0,8B modeli po 27B monolity. Aplikacja wyrosła z natywnej aplikacji GPU użytkownika abhi245y (PS5LM Plus).
Służy do tego samego, co Raspberry Pi z Ollamą, tylko mocniejsze i z ekranem na TV: prywatne podsumowywanie dokumentów, klasyfikacja, lokalne przetwarzanie obrazów albo zaplecze chatbota w domu. Prompt nie opuszcza sieci lokalnej. Jeśli szukasz sposobu, by odpalić LLM na PS5, to jest dziś najpełniejsza droga. Do 10 października projekt był payloadem z biblioteką modeli w przeglądarce (małe modele do 1,6 GB), natywną aplikacją jest od wydania 0.2.0.
Jak to działa: GPU konsoli, Vulkan i pamięć
PlayStation 5 ma ośmiordzeniowy procesor Zen 2 (3,5 GHz, w Pro 3,85 GHz), 16 GB GDDR6 o przepustowości 448 GB/s (576 GB/s w Pro) i GPU klasy RDNA 2 sterowane przez prywatny interfejs AGC, bez publicznego API graficznego. System to pochodna FreeBSD. Te fakty spisuje w dokumencie research; z nich wynika cała trudność zadania: bez jailbreaka nie ma dostępu do GPU, więc żaden Ollama-like nic tu nie uruchomi.
Po jailbreaku tor wygląda tak: aplikacja tytułowa dostaje 12 GB tzw. direct memory, a sterownik RADV (port Mesy dla kart AMD, w wersji PS5_Vulkan Mihawk-99, z warstwą winsys dla AGC konsoli) raportuje jedną stertę 11,44 GiB na model i kontekst. Bez włączonej flagi radv_enable_unified_heap_on_apu ta sterta ma 8 GiB. RADV zgłasza na konsoli Vulkan 1.4, przechodzi Khronos CTS z wyliczonymi lukami, choć bez certyfikacji. Dla llama.cpp to zwykłe urządzenie Vulkan, więc backend ggml-vulkan jest standardową ścieżką, nietypowy jest tylko sterownik pod spodem.
Jest haczyk wydajnościowy, który wyjaśnia sporo z poniższych liczb: RADV na PS5 nie ma cooperative matrix ani przyspieszonego iloczynu skalarnego, więc mnożenia macierzy idą przez shadery fp16. Do tego limity systemu: proces payloadu widzi tylko pięć logicznych rdzeni, a zajęcie ich wszystkich w pętli potrafiło zawiesić konsolę, więc PS5LM domyślnie zostawia dwa rdzenie wolne. To konsola współdzielona z systemem, nie karta w gnieździe PCIe.
Jakie modele i jakie prędkości
Pomiary autora, opisane jako „measured on the console” (PS5 Slim, każdy model w całości na GPU), wyglądają tak:
| Model | Rozmiar pliku | Prędkość na PS5 Slim |
|---|---|---|
| Qwen 3.5 0.8B, Q4_K_M | 0,5 GB | 207 tok./s |
| Qwen 3.5 9B, Q4_K_M | 5,3 GB | 55 tok./s |
| Qwen 3.8 27B, UD-Q2_K_XL | 9,2 GB | ok. 20 tok./s, kontekst 64 tys. |
| d1 Omni 600M (decyzyjny) | 1,1 GB | 3 pytania w 0,3 s |
Dokumentacja CONSOLE.md dopowiada szczegóły dla największego modelu: Qwen3.8-27B w wariancie UD-IQ2_XXS ładuje się 82 sekundy, przetwarza prompt z prędkością 35 do 50 tok./s, a generacja to 21 tok./s na krótkim zapytaniu, spadająca do 9 tok./s przy długim prompcie strony czatu. To spójne z matematyką dekodowania, którą projekt sam zapisuje: tokeny na sekundę to w przybliżeniu przepustowość pamięci podzielona przez bajty wag czytane na token, a gęsty 27B w 2 do 3 bitach czyta 7 do 9 GiB na token.
Komentarze z Hacker News dopowiadają resztę. Użytkownik kadoban ocenia Qwen 3.8 27B jako model „maybe somewhere around Opus 4.6 level”, z zastrzeżeniem, że kwantyzacja 2-bitowa jest wyraźnie gorsza od 4-bitowej. thombles dopowiada, że model „needs to do a lot of inference-time computation”, czyli rozsądne odpowiedzi na trudniejsze zadania wymagają dziesiątek tysięcy tokenów rozumowania, co przy kilkunastu tok./s daje długie czekanie. none_to_remain broni użyteczności: „A 20 tps Qwen3.8-27B at 2 bits quantization is limited but not useless”, z przykładem czytania codebase, gdzie drobne błędy nie bolą. Kontrgłos hypfer: „entirely useless given the limited VRAM”; jego zdaniem README obiecuje więcej, niż jest w rzeczywistości.
Lista modeli spisana w MODELS.md dzieli się na modele, które mają wpadać na pewno (do 6 GiB: Granite 4.2 3B i 8B, Gemma 4 E4B, Nemotron 3 Nano 4B, Qwen3.5 9B), i na takie, które wpadą, jeśli pozwoli sonda pamięci (6 do 11 GiB: Qwen 3.8 27B, Qwen 3.6 27B, Qwen 3.6 35B-A3B, gpt-oss 20B). Nie wpadają w ogóle modele od 18 GiB w górę, w tym Qwen 3.8 Flash-Next 180B i modele cloud-only. Modele z projektorem obrazu (Gemma 4, MiniCPM-V, d1) przyjmują zdjęcia w czacie.
Zanim cokolwiek uruchomisz: jailbreak
Tu zaczyna się właściwy koszt. PS5LM wymaga PS5 na firmware od 7.00 do 13.60 z jailbreakiem Relapse (publikacja ntfargo z 29 września 2026) i z załadowanymi payloadami: kstuff-lite (łatki kernela, na których stoi homebrew), etaHEN (wsparcie homebrew) i ShadowMountPlus (dodaje PS5LM do ekranu głównego z katalogu /data/homebrew). Relapse startuje w przeglądarce konsoli, przez wyciek informacji w JavaScriptCore i uszkodzenie tablicy w mechanizmie structured clone, a dostęp do zapisu i odczytu kernela dostaje przez wyścig use-after-free w aio_multi_wait. Nie przeżywa restartu konsoli.
Firmware 14.00, wydany 16 września 2026, tę lukę zamyka. Tom’s Hardware opisuje pokrętną pętlę: gry zaczynają wymagać nowszego firmware (cyfrowe wydanie Marvel’s Wolverine przy aktualizacji żąda już 14.00), a aktualizacja grzebie jailbreak na stałe. Konsola pod PS5LM to konsola z decyzją „nie aktualizuję”.
Trzecia rzecz: konsola z jailbreakiem to konsola, która nie gra online. Dokumentacja PS5LM milczy na temat PSN, a tezę sceny podsumowuje na HN użytkownik Retr0id: Sony ma zdanie o samych jailbreakach, ale „they really don’t give a shit about anyone running llama.cpp”. To opinia, nie gwarancja, i decyzja o PSN zostaje po stronie właściciela.
Nie piszemy tu instrukcji instalacji exploitów, i projekt też tego nie robi: repozytorium PS5LM zakłada gotowego jailbreaka i zajmuje się tym, co po nim.
Instalacja aplikacji i pobranie modelu
Po jailbreaku reszta jest banalna. Z zakładki Releases na GitHubie ściąga się ps5lm-app-v0.9.0.zip (35 MB), rozpakowuje i kopiuje katalog PPSA99575 na konsolę przez FTP (ftpsrv, port 2121) do /data/homebrew. ShadowMountPlus dodaje pozycję PS5LM do ekranu głównego. Aktualizacja to skopiowanie nowego katalogu na stary; ustawienia i modele siedzą w /data/PS5LM i zostają.
Modele pobiera sama aplikacja: ekran Models ma wyszukiwarkę Hugging Face, listę Suggested (modele zmierzone na konsoli) i pobieranie na pamięć wewnętrzną, dysk M.2 albo USB, a szesnaście równoległych połączeń daje ok. 12,5 MB/s mimo wąskich limitów gniazd w kernelu (pomiar z CONSOLE.md). Gdy model jest załadowany, ekran Home pokazuje „Ready” i adres serwera. Z kanapy steruje się padem: Square wysyła demo, Triangle otwiera klawiaturę ekranową.
Podłączenie narzędzi: curl, opencode, Claude Code
Serwer słucha na porcie 8081 i mówi trzema dialektami: OpenAI Chat Completions (/v1/chat/completions, używa opencode, aider, Continue), OpenAI Responses (/v1/responses, dla codex) i Anthropic Messages (/v1/messages, dla Claude Code). Nazwa modelu w żądaniu jest ignorowana, odpowiada ten, który siedzi w bibliotece. Szybki test z laptopa sprowadza się do curl z JSON-em na http://adres-konsoli:8081/v1/chat/completions.
Dokumentacja CLI.md zawiera gotowe configi i, co cenniejsze, wynik testu zrobionego na konsoli 10 października: zadanie „dopisz funkcję do hello.py” wykonały opencode 1.18.35 (208 sekund), codex 0.161.0 (zmienił plik i uruchomił go, 12 960 tokenów) i Claude Code 2.1.296 (613 sekund, z czego większość to pierwszy, 18-tysięczny prompt narzędzia). Claude Code wymaga zmiennych ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN i ustawionego CLAUDE_CODE_MAX_CONTEXT_TOKENS, bo nie zna modelu i zakłada 200 tys. kontekstu. Agenty wysyłają 10 do 20 tys. tokenów instrukcji i definicji narzędzi na starcie, a przy 30 do 50 tok./s przetwarzania promptu pierwsza odpowiedź zawsze potrwa minuty. Autor radzi: dla agentów lepszy jest mniejszy model z długim kontekstem, a 27B zostawić na pojedyncze pytania.
Modele decyzyjne przez Ollaya
Nowość z wydania v0.9.0 wykracza poza llama.cpp: PS5LM uruchamia też modele decyzyjne (d1, Clef, OpenJev i inne) i odpowiada na API /v1/systemone, które na PC serwuje projekt Ollaya (repozytorium ollaya-dev/ollaya, ponad 1300 gwiazdek, Apache-2.0, nazwane „Ollama for decision models”). Idea: model czyta stan (tekst albo JSON) i odpowiada na pytania o ustalonej typizacji, wybór z listy, wynik punktowy albo tak/nie, w jednym przejściu, bez generowania tekstu. Przykład z README konsultuje z modeliem wiadomość klienta: intencja (refund, information, cancel) z prawdopodobieństwami i pytanie „czy klient jest zły”.
W domu: klasyfikacja wiadomości, triage zgłoszeń, filtrowanie alertów, decyzje w automatyzacjach. d1 Omni 600M odpowiada na 3 pytania w 0,3 sekundy, z obrazem 720p i 7 pytaniami w 2,9 sekundy, więc temat klasyfikacji zdjęć z kamery jest realny. Porównania z Ollamą 0.35 na stronie Ollayi to pomiary producenta na PC, nie na konsoli.
Ile to kosztuje
Konsola jest tu argumentem głównym. Ceny z komentarzy HN z 16 do 17 października: 600 USD (nvme0n1p1), 650 USD jako MSRP (numpad0), 799 euro w Europie (madduci). Używana wychodzi taniej, a jeroenhd dodaje kontekst cenowy: po sześciokrotnym wzroście cen RAM 12 GiB pamięci w starej konsoli kosztuje mniej niż te same kości kupione osobno. Dla porównania numpad0 przywołuje specyfikacje: RX 9060 XT 16 GB ma szynę 128-bit i 322 GB/s, GPU PS5 ma 256-bit i 448 GB/s, przy podobnym poborze 160 do 180 W.
Jest jeszcze ścieżka boczna: BC-250, płyty górnicze zbudowane na okrojonym krysztale konsoli, po 150 do 220 USD na eBayu według komentujących (shiftpgdn, LoganDark). To sprzęt bez konsolowej obudowy, z tym samym GPU klasy RDNA 2. Prąd policzył tylko jjcm, szacunkowo dla USA: „70 cents a day in power cost means you now get ~2M output tokens per day (~$3.50 worth of usage)”; w polskich taryfach będzie inaczej, a odczyt mocy robi ekran Console. Cen PS5 z polskich kart produktu nie odczytaliśmy (sklepy blokują automatyczne pobieranie), stąd ceny tylko z atrybucją na HN.
Ograniczenia, które trzeba brać pod uwagę
Pierwsza grupa to cena wejścia i jej trwałość. Jailbreak znika po restarcie i po aktualizacji firmware, a firma zamyka luki w kolejnych wydaniach systemu. Dokumentacja przyznaje wprost, że etap kernelowy Relapse „sometimes hangs” i konsola potrafi się wtedy wyłączyć; to wyścig w eksploicie, nie wada PS5LM. Do tego ryzyko bana na PSN i gwarancja, którą producent nie obejmie przy konsoli z łatami kernela.
Druga grupa to wydajność i jakość. 20 tok./s na 27B w kwantyzacji 2-bit wystarcza do czatu i klasyfikacji, nie wystarcza na interaktywną pracę z agentami, gdzie liczy się szybkość przetwarzania długich promptów. Zmiana modelu restartuje aplikację (sterta GPU po wyładowaniu modelu się nie oddaje w całości, opisane w CONSOLE.md), przeglądarka konsoli nie wyrenderuje natywnego UI llama.cpp (PS5LM ma własne). To projekt tygodniowy, z 11 otwartymi zgłoszeniami i jedną konsolą testową (PS5 Slim CFI-2015, firmware 13.60), więc wyniki mogą się różnić. Na PS5 Pro (576 GB/s) pomiarów jeszcze nie ma.
Najczęstsze pytania
Czy PS5LM działa bez jailbreaka
Nie. Aplikacja jest natywnym tytułem homebrew i potrzebuje łatek kernela (kstuff-lite), wsparcia homebrew (etaHEN) oraz ShadowMountPlus do pojawienia się na ekranie głównym. Bez jailbreaka system nie udostępnia publicznego API do GPU (interfejs AGC jest prywatny), więc llama.cpp nie ma czym liczyć. Wymagany firmware to 7.00 do 13.60; nowsze wersje mają lukę załataną.
Czy po jailbreaku konsola nadal jest zwykłą PS5
Tak, dopóki nie podłączysz jej do PSN i nie zaakceptujesz aktualizacji. Jailbreak Relapse nie przeżywa restartu, więc jest uruchamiany od nowa po każdym włączeniu konsoli, a firmware 14.00 lukę zamyka na stałe.
Jaki model wybrać na PS5LM
Na co dzień: coś z listy „fits for sure”, do 6 GiB, na przykład Granite 4.2 3B albo Qwen 3.5 9B, który daje 55 tok./s. Najlepsze odpowiedzi daje Qwen 3.8 27B w kwantyzacji 2-bit, ale po cenie: kilkuminutowe pierwsze odpowiedzi w narzędziach kodujących i potrzeba trzymania żądań krótkich. Do klasyfikacji i decyzji są modele decyzyjne (d1, Clef), liczone w setkach milisekund.
Ile prądu ciągnie taka konfiguracja
Nie ma wiarygodnego pomiaru dla pracy serwera 24 na 7. GPU PS5 ma nominalny pobór 180 W, a szacunek użytkownika jjcm z HN to 70 centów dziennie (USA) przy ok. 2 mln tokenów wyjściowych. Wykres poboru mocy w aplikacji pozwala policzyć rachunek na własnej taryfie w tydzień.
Czy to nadaje się do pracy z kodem
Na zasadzie „działa, ale powoli”. Test autora z 10 października przeszły wszystkie trzy narzędzia, ale każde przywozi 10 do 20 tys. tokenów własnych instrukcji, przetwarzanych przy 30 do 50 tok./s, więc pierwsza odpowiedź to minuty. Do nauki i eksperymentów z agentami bez kosztu API, spoko; do produkcji nie.
Nota o zakresie
Nie mamy PS5, więc nic z opisanego nie przeszło przez nasz test. Wszystkie prędkości i rozmiary z tabel to deklaracje autora projektu, opisane jako pomiary na konsoli (README i strona projektu), uzupełnione dokumentacją CONSOLE.md z jednej konsoli testowej (PS5 Slim, firmware 13.60). Liczby przytaczane za komentującymi HN (jakość Qwen 3.8 27B, koszty prądu, ceny sprzętu) to ich zgłoszenia, nie nasze pomiary. Cen PS5 z polskich sklepów nie odczytaliśmy automatycznie (strony blokują roboty), stąd ceny tylko z atrybucją na HN. Nie testowaliśmy jakości odpowiedzi modeli po polsku.
Źródła
- README repozytorium PS5LM, odczyt 2026-10-18: https://raw.githubusercontent.com/cobanov/PS5LM/main/README.md
- Metadane repozytorium (gwiazdki, licencja, daty), GitHub API, odczyt 2026-10-18: https://api.github.com/repos/cobanov/PS5LM
- Najnowsze wydanie v0.9.0 z 16.10.2026 (changelog, assety), GitHub API, odczyt 2026-10-18: https://api.github.com/repos/cobanov/PS5LM/releases/latest
- Strona projektu ps5lm.cobanov.dev (pomiary „measured on the console”), odczyt 2026-10-18: https://ps5lm.cobanov.dev
- Wątek Hacker News (367 pkt, 84 komentarze), pełne drzewo przez API Algolii, odczyt 2026-10-18: https://hn.algolia.com/api/v1/items/50122431
- Dokumentacja CONSOLE.md (pamięć, pomiary llama.cpp, konsola testowa), odczyt 2026-10-18: https://raw.githubusercontent.com/cobanov/PS5LM/main/docs/CONSOLE.md
- Dokumentacja CLI.md (API, configi narzędzi, test z 10.10.2026), odczyt 2026-10-18: https://raw.githubusercontent.com/cobanov/PS5LM/main/docs/CLI.md
- Dokumentacja MODELS.md (listy modeli i rozmiary GGUF), odczyt 2026-10-18: https://raw.githubusercontent.com/cobanov/PS5LM/main/docs/MODELS.md
- Dokumentacja RESEARCH.md (specyfikacja konsoli, opis Relapse i prac poprzedników), odczyt 2026-10-18: https://raw.githubusercontent.com/cobanov/PS5LM/main/docs/RESEARCH.md
- README PS5_Vulkan (RADV na PS5, Vulkan 1.4, braki cooperative matrix), odczyt 2026-10-18: https://raw.githubusercontent.com/mihawk-99/PS5_Vulkan/main/README.md
- Tom’s Hardware o jailbreaku Relapse (firmware 7.00-13.60, Catch-22 z 14.00), publikacja 30.09.2026, odczyt 2026-10-18: https://www.tomshardware.com/video-games/playstation/new-ps5-relapse-jailbreak-enables-homebrew-and-switch-emulation-but-is-hamstrung-by-rapidly-changing-firmware-revisions-jailbreak-unlocks-firmware-13-60-but-newer-games-already-demand-firmware-14-00
- Strona Ollaya (modele decyzyjne, benchmark z Ollamą), odczyt 2026-10-18: https://ollaya.dev
- Metadane repozytorium ollaya-dev/ollaya, GitHub API, odczyt 2026-10-18: https://api.github.com/repos/ollaya-dev/ollaya
- README etaHEN (exploity IPv6 i UMTX, payloady), odczyt 2026-10-18: https://raw.githubusercontent.com/etaHEN/etaHEN/main/README.md
- CHANGELOG projektu (historia wydań od 0.2.0 z 10.10.2026 do 0.9.0), odczyt 2026-10-18: https://raw.githubusercontent.com/cobanov/PS5LM/main/CHANGELOG.md