—
Najważniejsze informacje
| Co | Stan na 27.10.2026 |
|---|---|
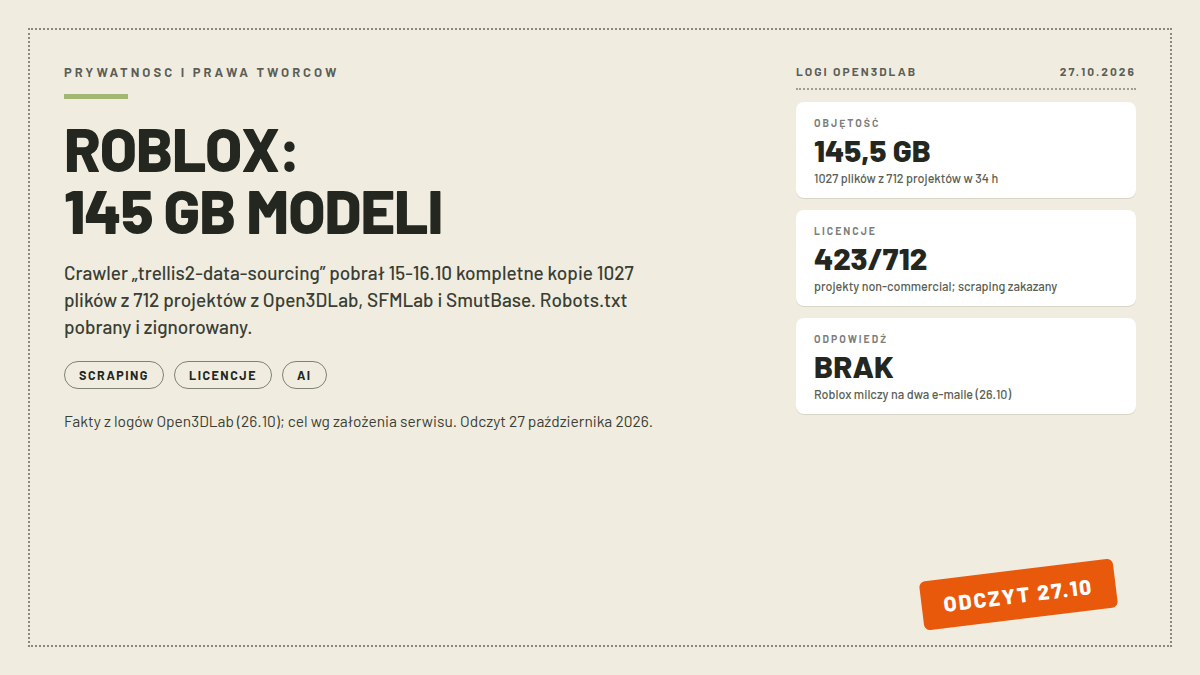
| Co się stało | crawler „trellis2-data-sourcing/1.0” („3D foundation model research; @roblox.com”) pobrał 15-16.10.2026 kompletne kopie 1027 plików z 712 projektów |
| Objętość | 145,5 GB z trzech stron: Open3DLab, SFMLab i SmutBase |
| Treści dla dorosłych | 345 z 712 projektów (62,6 GB), w tym 364 pliki (54,8 GB) z SmutBase |
| Licencje | 423 z 712 projektów non-commercial; robots.txt pobrany i zignorowany; regulamin zakazuje scrapingu |
| Reakcja | blokada 18.10; dwa e-maile do Roblox bez odpowiedzi (stan 26.10) |
| Stanowisko Roblox | brak (zapis wprost, stan na publikację) |
| Cel pobrania | założenie serwisu („what we assume are AI training purposes”), nie fakt |
Co zrobili twórcy serwisu, a czego nie zrobił Roblox
Wykrycie nastąpiło 18 października rano, blokada tego samego dnia. Open3DLab napisało tego samego dnia e-mail na adres z identyfikatora crawlera z prośbą o komentarz. Odpowiedzi nie było. Crawler wrócił 19 października i wszystkie próby zostały zablokowane; wg serwisu nie zmniejszył tempa mimo blokad, a godziny pracy układały się w rytm biurowy: aktywność od rana, przerwa w porze lunchu, koniec z końcem dnia roboczego CEST. 20 października o 8:00 nastąpił ostatni powrót, z wolnym zwalnianiem po południu, „likely in an effort to test our rate limiting”. Drugi e-mail też został bez odpowiedzi, i na moment publikacji, 26 października, Roblox nie wydał żadnego stanowiska. Zapisuję wprost: po naszej stronie też nie ma żadnej odpowiedzi ani komentarza Roblox, ten tekst powstaje 27 października.
- Najważniejsze informacje
- Co zrobili twórcy serwisu, a czego nie zrobił Roblox
- Dlaczego akurat te strony
- Co z tego wynika dla twórców w Polsce
Sekcja „Speculation” komunikatu Open3DLab jest rzadko spotykanie uczciwa, bo wyraźnie oddziela fakty z logów od domysłów. Fakty: Roblox od co najmniej 2025 buduje „3D foundation model”; w marcu 2025 ogłoszono Cube, „core generative AI system for 3D and 4D”, którego pierwszy model kształtów trenowano na około 1,5 miliona assetów z licencjonowanych i publicznych zbiorów (m.in. Objaverse) oraz z opcjonalnie zgłoszonych elementów własnego Creator Store; w lutym 2026 ruszyła „4D generation” na Cubie. Adres z identyfikatora crawlera należy do badacza wymienionego wśród ponad 40 autorów pracy o Cube, a jego publiczny profil mówi o budowie fundamentowego modelu 3D w Robloxie.
Wnioski serwisu są ostrożne: „trellis2” może wskazywać na TRELLIS.2, otwarty model generowania 3D od Microsoftu z końca 2025, albo być kryptonimem projektu; narzędzia TRELLIS.2 nie zawierają crawlera, więc ten skrypt pisano pod konkretne zadanie. I najważniejsze: „We can’t prove it, and we don’t know whether any of our creators’ files ended up in a model”. Serwis odrzuca też osobistą atrybucję badaczowi: „we don’t suggest this researcher did anything on their own initiative or out of the ordinary for their job. A data-collection run like this is a company’s decision, and the responsibility for it is Roblox’s”.
Dlaczego akurat te strony
Odpowiedź daje sam Open3DLab: publiczne zbiory 3D mają dużo surowej geometrii, a mało tego, czego system generowania 3D potrzebuje najmocniej, czyli „complete, textured characters, many of them rigged, in the formats artists actually work in”, każdy z tytułem, opisem i podglądem. To gotowy materiał treningowy dla modelu, który ma generować postaci i animacje. Serwis przypomina przy okazji historię stosunków Robloxa z twórcami: dochodzenie People Make Games z 2021 o prowizji (według obliczeń autorów około 75% dla platformy wobec 30% na Steamie i wypłatach w Robuxach z progiem wypłaty), pozew National Music Publishers’ Association z 2021 o co najmniej 200 milionów dolarów za nielegalnie używaną muzykę, podniesienie stawki wypłaty o 8,5% we wrześniu 2025. To kontekst, nie oskarżenie; każda z tych spraw ma własną, niezależną historię.
Co z tego wynika dla twórców w Polsce
Zanim lekcje, jedna uwaga o tym, co się tu właściwie naruszyło, bo warstwy są trzy i każda działa osobno. robots.txt to standard grzecznościowy: mówi robotowi, czego nie czytać, i nie ma zęba, poza reputacyjnym. Regulamin serwisu to umowa z każdym, kto korzysta z infrastruktury, i tę Open3DLab ma wprost przeciwko scrapingowi. Licencje twórców to trzecia warstwa, najmocniejsza prawnie, bo przylega do samych plików: 423 z 712 pobranych projektów zezwalały wyłącznie na użycie niekomercyjne, więc nawet idealnie legalne pobranie przez użytkownika nie czyni tych plików surowcem komercyjnego treningu. Crawler naruszył wszystkie trzy warstwy naraz, a sprawa pokaże, którą z nich ktoś faktycznie wyegzekwuje.
Trzy lekcje z tej afery, żadna nie wymaga bycia twórcą modeli 3D. Pierwsza: plik robots.txt to prośba, nie zamek, i sprawa Open3DLab pokazuje czarną scenariuszową wersję, w którym robot prośbę pobiera i ignoruje. Druga: licencje non-commercial mają wartość tylko tam, gdzie ktoś je egzekwuje; 423 projekty z tej puli miały właśnie taką licencję. Trzecia: kanał kontaktu w identyfikatorze robota (adres e-mail w user agencie) zadziałał jako dziennik zdarzeń, ale nie jako komunikacja, bo na dwa maile nie odpowiedziano.
Dla twórcy udostępniającego prace w sieci dyskusja pod sprawą na Hacker News podała praktyczny, ostry środek: użytkownik hypfer pisze, że serwis nieprowadzący biznesowo nie musi rozmawiać z chmurami wcale: „you can just block incoming traffic from all of AWS, DigitalOcean, Azure, etc”, z zastrzeżeniem autora, że „That alone is not a sufficient strategy of course, but you can get rid of a lot of bots by just refusing to talk” do dostawców chmury. To jest środek boleśnie skuteczny, bo odcina też użytkowników VPN i część zwykłych odwiedzających; traktuj go jako jedną z opcji, nie jako radę uniwersalną.
Afera ma też drugą, mniej oczywistą warstwę: treści dla dorosłych. Prawie połowa pobranej objętości (62,6 GB z 345 projektów) pochodzi z sekcji adult, co przy trenowaniu modelu komercyjnego rodzi pytania wykraczające poza licencje: zgody osób, których postaci modele przedstawiają, i granice, których twórcy modów dorosłych nie rozciągają na szkolenie modeli korporacyjnych. Na ten moment nikt tych pytań nie rozstrzygnął, bo Roblox milczy. Kiedy stanie się inaczej, dopiszemy aktualizację; pilnujemy sprawy.
Źródła
- Open3DLab: „Roblox downloaded 145 GB of models from our sites (including adult content) without asking”, autor Salaryman, 26.10.2026 (logi crawlera, UA trellis2-data-sourcing/1.0, sekcja Speculation o Cube i TRELLIS.2, brak odpowiedzi Roblox na dwa e-maile), https://open3dlab.com/news/roblox-downloaded-145-gb-of-models-from-our-sites/ (odczyt 27.10.2026)
- Hacker News: dyskusja 50256985 (443 pkt, odczyt 27.10.2026), cytat hypfer verbatim, https://news.ycombinator.com/item?id=50256985
- Podpowiedzi Google dla fraz niszy: „roblox ai” (game maker, creator, assistant: narzędzia, nie afera), https://suggestqueries.google.com (odczyt 27.10.2026)