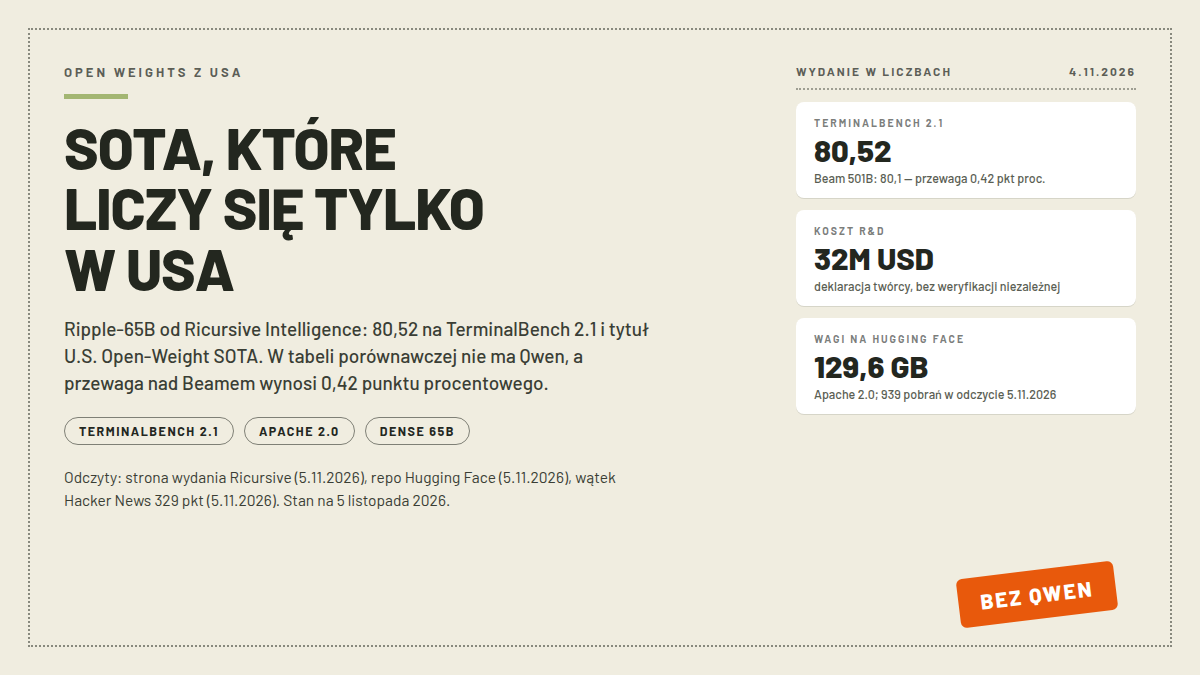
Laboratorium Ricursive Intelligence pokazało 4 listopada 2026 model Ripple-65B Preview i od razu weszło z nim na Hacker News z tytułem „U.S. Open-Weight SOTA on Agentic Coding”. Liczby brzmią poważnie: 80,52 punktu na TerminalBench 2.1, gęsty transformer 65B z wagami na Apache 2.0, trening na 12 bln tokenów i kontekst do miliona, a do tego deklaracja pełnego kosztu badawczego 32 mln dolarów, czyli deklarowana jedna dziesiąta tego, co kosztowało poprzednie osiągnięcie tej klasy. Wątek urosł w moim odczycie z wieczora 5 listopada do 329 punktów, ale nie dlatego, że ludzie pobiegli pobierać wagi. Dyskusja rozbiła się o sam tytuł: skoro rekord dotyczy tylko modeli otwartych z USA, a w tabeli porównawczej nie ma Qwen, to znaczy coś zupełnie innego niż to, co czytelnik rozumie przez SOTA.
- Najważniejsze informacje
- Co to za model i od kogo
- Co mierzy TerminalBench 2.1
- Tabela SOTA i jej wycięcia
- Koszt 32 mln i 1,4 mln rolloutów
- Po co komu geografia w tytule
- Co z tego dla lokalnego uruchomienia
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Wydanie | Ripple-65B Preview, Ricursive Intelligence, wątek HN 4.11.2026 (329 pkt w odczycie 5.11 wieczorem) |
| Architektura | gęsty transformer 65B, bez MoE; 80 warstw, d_model 5120, pre-trening na 12 bln tokenów, kontekst do 1M |
| Wynik | TerminalBench 2.1: 80,52; Reflection Beam 501B: 80,1; Meta Muse Spark Open 816B: 76,4; Inkling 975B: 63,8; Nemotron 3 Ultra 550B: 56,4 |
| Licencja | Apache 2.0, repo ricursiveAI/Ripple-65B-Preview na Hugging Face: 129,6 GB, 939 pobrań (odczyt 5.11.2026) |
| RL | ok. 1,4 mln rolloutów, deklarowane ok. 70x mniej niż Beam |
| Koszt | 32 mln USD pełnego R&D, deklaracja własna twórcy bez weryfikacji niezależnej |
| Dostęp przez API | OpenRouter, Together AI, GMI Cloud, Fireworks |
| Krytyka HN | brak Qwen w tabeli (Qwen 3.8 27B: 73% na tym samym benchu wg komentujących), przewaga 0,42 pkt proc. nad drugim miejscem, doborę rywali kwestionowano wprost |
Co to za model i od kogo
Ricursive Intelligence przedstawia się jako laboratorium full-stack budujące systemy samoulepszające się przez współprojektowanie układów, oprogramowania i modelu, a Ripple ma być dowodem tej tezy: wynik z górnej półki przy ułamku budżetu, bez własnych kerneli i bez kwantyzacji w treningu (MFU ok. 40%). Na stronie wydania wymieniono współprace z AI2 znaną z Olmo, Prime Intellect, RadixArk i NVIDIA. Architektura jest współczesna i zagęszczona: 80 warstw przy d_model 5120, czyli wąsko i głęboko, sliding window attention z przeważającą liczbą warstw lokalnych, gated attention na sigmoidzie, value residuals i global NoPE. Społeczność od razu zauważyła ciekawostkę rynkową: istnieje druga firma Recursive, która też robi modele, a obie nazwy różnią się jedną literą i obie tłumaczą się na polski tak samo.
Wagi siedzą na Hugging Face jako ricursiveAI/Ripple-65B-Preview: 129,6 GB w 31 plikach, licencja Apache 2.0, 939 pobrań i 233 polubienia w odczycie z 5 listopada. Po stronie inferencji model jest dostępny u czterech dostawców chmurowych (OpenRouter, Together AI, GMI Cloud, Fireworks), więc do pierwszego kontaktu nie trzeba własnej karty. Cenników tych usług nie odczytałem 5 listopada i nie podaję ich z pamięci; strona wydania cen nie podaje wcale.
Gęstość (dense) to element, który warto tu rozumieć, bo od niego zależy wszystko dalsze. W modelach MoE, takich jak chińskie flagowce, router wybiera przy każdym tokenie garść ekspertów, więc aktywna część parametrów jest mała, ale cała masa wag musi siedzieć w pamięci. Ripple nie ma routingu: każdy token przechodzi przez wszystkie 65B parametrów, co zwykle oznacza lepszą jakość na parametr i wolniejsze generowanie na tym samym sprzęcie. To świadomy wybór pod bench agentowy, gdzie liczy się niezawodność zadań, nie przepustowość czatu, i pod narrację efektywności: mniej parametrów, więcej pracy każdego z nich.
Co mierzy TerminalBench 2.1
TerminalBench to benchmark zadań agentowych wykonywanych w terminalu: model dostaje środowisko i cel, a punkty zbiera za ukończone zadania, nie za ładne odpowiedzi. Właśnie dlatego służy do rankingu modeli „agentic coding”, czyli takich, które mają same uruchamiać komendy, czytać pliki i naprawiać własne błędy. Wersja 2.1 nie jest jednak najświeższa, i w wątku HN padało, że część starszych benchów tego typu straciła na wiarygodności: SWE-bench miał być nieformalnie wycofany przez OpenAI, a DeepSWE miał być „bench-hackowany” przez trening pod konkretne zadania. To relacje komentujących, nie moje pomiary, ale pokazują kierunek uwagi: sam wynik 80,52 mówi mniej niż wydawałoby się z numerka, dopóki nie wiadomo, jak bardzo etap RL został dopasowany do zestawu testowego. Twórcy podają liczbę rolloutów, nie podają reguł oddzielenia zbioru treningowego od testowego, a to pierwsze pytanie, które zadaje każdy audyt benchmarku.
Tabela SOTA i jej wycięcia
Tabela TerminalBench 2.1 na stronie wygląda mocno, dopóki nie zapyta się, kto w niej siedzi. Ripple 80,52 wobec Reflection Beam 501B z wynikiem 80,1 to przewaga 0,42 punktu procentowego na jednym benchu, co komentujący yorwba policzył wprost i nazwał prowadzeniem bez znaczenia praktycznego. Trzy dalsze pozycje (Muse Spark Open 816B, Inkling 975B, Nemotron 3 Ultra 550B) to modele od ośmiu do piętnastu razy większe, więc skalowanie wygląda imponująco, ale właśnie tu zaczyna się tytułowe „U.S.”.
Bo pełna tabela open-weight, bez ograniczenia geograficznego, wygląda inaczej. Komentujący 2001zhaozhao przytaczał, że Qwen 3.8 Flash Next ma na TerminalBench 2.1 wynik 84,3, a Qwen 3.8-27B, czyli model dwukrotnie mniejszy od Ripple, 73. Te liczby pochodzą z komentarza, nie z mojego odczytu benchmarku, więc traktuj je jako relację społeczności; kolejność jest jednak zgodna z tym, co wiadomo o wynikach tej rodziny. Wniosek jest twardy: globalny rekord open-weight na tym benchu należy do modelu chińskiego, a „U.S. Open-Weight SOTA” znaczy dokładnie to, co napisało, najlepszy w podzbiorze wyciętym geograficznie. W dyskusji padły też zarzuty doboru rywali w bardziej drobiazgowym wariancie: do porównania wielkości wybrano Inkling 975B zamiast mniejszego i lepszego Beam 1.0, a Nemotron 3 Ultra zamiast mniejszego Nemotron 3.5 Super.
Koszt 32 mln i 1,4 mln rolloutów
Deklaracje ekonomiczne to druga oś wydania: pełny koszt R&D od drabinki pretreningu po finalny run miał zamknąć się w 32 mln USD, a etap RL w ok. 1,4 mln rolloutów, około siedemdziesiąt razy mniej niż u Beam. To liczby samego twórcy, bez weryfikacji niezależnej, i strona pisze je wprost jako „estimated to the best of our knowledge”; w wątku HN nie znalazłem replikacji ani podważenia tych liczb, więc stan na 5 listopada brzmi: przyjęte do wiadomości, niepotwierdzone. Nawet jeśli kwota jest bliska prawdy, nie zmienia oceny tabeli: tanio i dobrze to nadal nie to samo, co najlepiej.
Warto przy tym oddać, że sama techniczna strona nie budzi zastrzeżeń. Gęsty 65B z wynikiem 80 na benchu agentowym przy budżecie rzędu trzydziestu kilku milionów to realny postęp efektywności, i część komentujących doceniła to wprost, oddzielając wyraźnie rekord od etykiety SOTA. Spór nie dotyczy tego, czy Ripple jest dobry, tylko tego, jak duży kawałek rynku wycięto, żeby mógł nosić ten napis.
Po co komu geografia w tytule
Podział na „U.S.” i resztę nie jest caprice marketingowy, tylko odblask realnego rynku. W dyskusji pod wątkiem kilkoro komentujących wskazywało, że pierwotnym klientem takiego modelu są podmioty, które z przepisów albo z polityki zakupowej muszą brać technologię amerykańską: agencje rządowe, branża projektowania układów, firmy z wymogami sojusowymi. W tym korytarzu Qwen i tak nie może zagrać, więc tabela bez Qwen jest dla tego klienta tabelą kompletną. Jeden z komentarzy poszedł dalej i przypomniał, że stanowisko departamentu stanu może kiedyś uczynić ten podział obowiązkowym dla części firm, co brzmi jak futurystyczna anegdota, ale logicznie wynika z kierunku regulacji. Dla europejskiego obserwatora, a takim jest czytelnik tego bloga, to po prostu kolejny sygnał, że wagi otwarte przestały być jednym rynkiem i stały się kilkoma rynkami o różnych regułach dostępu.
Z tej samej dyskusji pochodzi pytanie o przyszłość: czy będzie wersja mniejsza. Komentarze domagające się 27B albo destylacji z Ripple wyszły od razu, bo gęsty 65B na sprzęcie hobbystycznym to powolny model, a cała efektywność tego wydania siedzi w wyniku, nie w cenie uruchomienia. Twórcy nie zapowiedzieli mniejszej wersji na 5 listopada, więc stan jest taki: pusty.
Co z tego dla lokalnego uruchomienia
Gęsta architektura ma cenę po stronie użytkownika: 65B bez routing MoE to ok. 130 GB wag w bf16 i wolna generacja na sprzęcie konsumenckim, co w wątku podniósł komentujący od hobbyzistów. Kontra z tej samej dyskusji brzmi, że techniki przyspieszające dense modele (MTP i tym podobne) zmieniają rachunek i gęste modele wracają do łask tam, gdzie liczy się jakość na token. Realnie: na kartach konsumenckich pozostaje to model do testów przez API, nie do domu; uruchamianie otwartych wag na własnym sprzęcie opisujemy w hubie lokalnego AI, a sprzęt klasy DGX Spark, na którym strona wydania pokazuje Ripple lokalnie, omawialiśmy przy linuksowym pomiarze na RTX Spark. Polskiego autocompletu wokół nazwy jest zero w odczycie 5 listopada, więc fraza „ripple 65b” to luka do obsadzenia, nie rodzina z konkurencją.
Najczęstsze pytania
Co to jest Ripple-65B?
Model językowy laboratorium Ricursive Intelligence: gęsty transformer 65B parametrów, 80 warstw, kontekst do 1M tokenów, pre-trening na 12 bln tokenów i etap RL na ok. 1,4 mln rolloutów. Wagi są otwarte na Apache 2.0, model jest też dostępny u czterech dostawców API.
Czy Ripple-65B jest do pobrania?
Tak. Repozytorium ricursiveAI/Ripple-65B-Preview na Hugging Face zawiera wagi o rozmiarze 129,6 GB na licencji Apache 2.0, więc użycie komercyjne i modyfikacje są dozwolone bez dodatkowych umów, w przeciwieństwie do licencji wielu chińskich wydań wag.
Czy Ripple-65B jest naprawdę SOTA?
Tylko w wąskim znaczeniu z tytułu: najlepszy wynik wśród modeli open-weight pochodzących z USA na TerminalBench 2.1 (80,52). Globalnie w tym zestawieniu prowadzą modele chińskie (Qwen 3.8 Flash Next ok. 84,3 wg komentujących HN), a przewaga nad drugim amerykańskim modelem wynosi 0,42 punktu procentowego.
Ile kosztuje Ripple-65B?
Wagi są darmowe na Apache 2.0. Ceny inferencji API (OpenRouter, Together, GMI, Fireworks) nie były odczytane 5 listopada i strona wydania ich nie podaje. Deklarowany koszt treningu to 32 mln USD pełnego R&D według twórcy, bez weryfikacji niezależnej.
Źródła
- Strona wydania Ripple-65B Preview, Ricursive Intelligence (odczyt 5.11.2026)
- Repozytorium ricursiveAI/Ripple-65B-Preview na Hugging Face (odczyt 5.11.2026)
- Dyskusja na Hacker News (329 punktów, odczyt 5.11.2026)
- Strona modelu na OpenRouter (odczyt 5.11.2026)
- Strona modelu na Together AI (odczyt 5.11.2026)