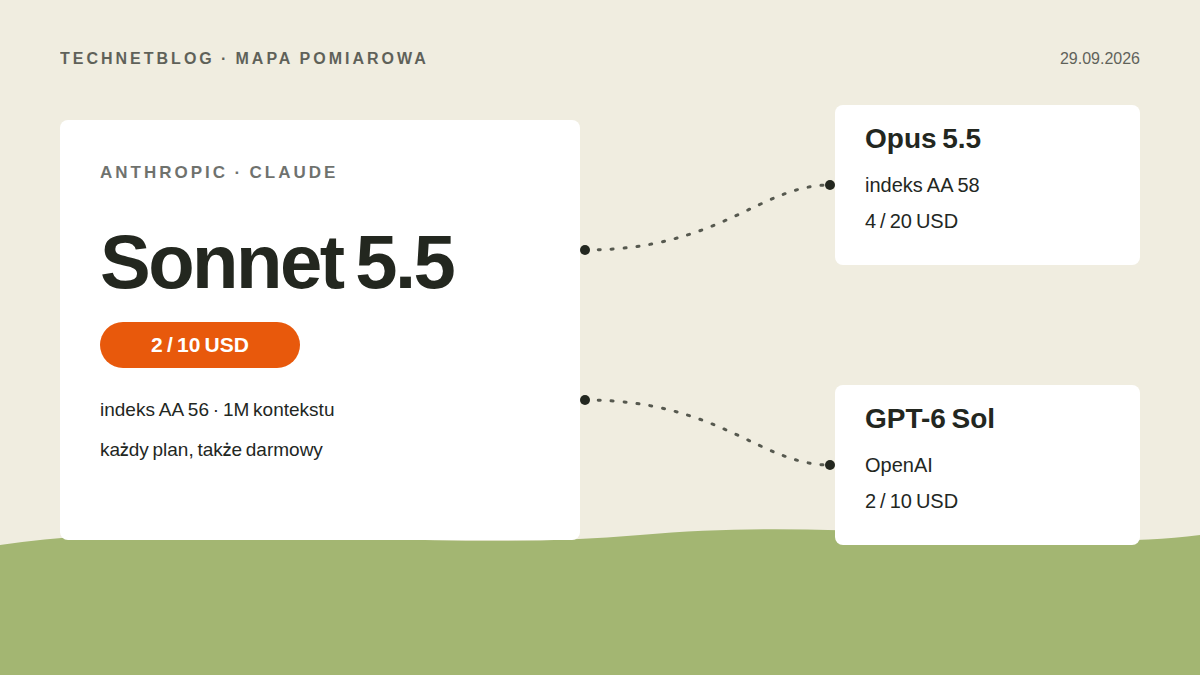
Dwudziestego ósmego września wieczorem Anthropic dołożyło do rodziny Claude model Sonnet 5.5. W rankingu Artificial Analysis punktował 56 przy poziomie wysiłku max, dwa punkty za flagowym Opusem 5.5 i lepiej niż cokolwiek innego na rynku. Cena API została bez zmian: dwa dolary za milion tokenów wejścia i dziesięć za wyjścia, dokładnie połowa stawek Opusa. Najważniejsze dla większości czytelników jest jednak to, że Sonnet 5.5 trafił na każdy plan Claude, także darmowy.
Wszedł też tam, gdzie mało kto zagląda w pierwszym dniu premiery: do Claude Code. Od wersji 2.1.284 jest domyślnym Sonnetem, więc jeśli pracujesz z tym narzędziem, nowy model już siedzi w twoim terminalu.
To wypełnienie środka rodziny tydzień po premierze Opusa 5.5 z dwudziestego drugiego września i druga w tym miesiącu premiera, która przestawia relację ceny do możliwości. Na początku września OpenAI wypuściło GPT-6 Sol i Lunę, a Sol kosztuje w API dokładnie tyle, co Sonnet 5.5, po 2 i 10 dolarów za milion tokenów. Anthropic odpowiada modelem, który w testach na pracę agenta w terminalu punktuje wyżej od własnego flagowca.
Spis treści:
- Co nowego w Sonnet 5.5
- Ile kosztuje Sonnet 5.5
- Gdzie włączyć Sonnet 5.5
- Sonnet 5.5 czy Opus 5.5: który wybrać
- Uwaga: zabezpieczenia cyber potrafią zaskoczyć
- Claude w Polsce
- Źródła
Co nowego w Sonnet 5.5
Anthropic deklaruje, że model generuje odpowiedzi o ponad 30 procent szybciej niż Sonnet 5 i wychodzi do 30 procent taniej przy jednym zadaniu, bo rzadziej odpytuje narzędzia po kolei i zbiera wywołania w paczki. W pracy z kodem to czuć na liczbie zwrotów do powłoki: mniej przebiegów na tę samą robotę. Kontekst nie urósł, zostaje milion tokenów na wejściu, z obrazami włącznie.
Benchmarki agenticzne idą w tę samą stronę. Terminal-Bench 4.0, mierzący pracę modelu w terminalu, wypada 70,6 procenta wobec 10,3 procenta u Sonnet 5 i 66,4 procenta u Opus 5.5. W CursorBench 4.0, czyli przy kodowaniu w IDE, jest 55,5 procenta wobec 34,1 procenta poprzednika. Przy zadaniach ekspertowych liczonych skalą GDPval nowy Sonnet zbiera 1844 punkty, gdy Opus 5.5 ma 1846, czyli remis w granicach błędu pomiaru. Do tego model jako pierwszy z rodziny Sonnet przeszedł Pokémon Red, patrząc wyłącznie na zrzuty ekranu, co jest równie bezużyteczne w pracy biurowej, co wymowne dla zdolności agentowych.
Druga strona medalu wychodzi w pomiarach Artificial Analysis. Na poziomie max Sonnet 5.5 wypisuje około 193 tysiące tokenów na jedno zadanie indeksu, najwięcej ze zmierzonych modeli i o 60 procent więcej niż Opus 5.5, przez co pojedyncze zadanie kosztuje 7,60 dolara, o połowę więcej niż u Sonnet 5 przy tym samym ustawieniu. Deklaracja „do 30 procent taniej” opisuje warunki raportowane przez klientów Anthropic przy typowych ustawieniach; przy maksymalnym wysiłku licznik idzie w drugą stronę, bo model po prostu myśli dłużej i wypisuje więcej. Suwak wysiłku ma pięć pozycji, od low do max, i to on rozstrzyga, który rachunek dostaniesz.
W czystej faktografii Opus zostaje na czele: w teście AA-Omniscience nowy Sonnet punktował 54 procenty wobec 66 procent flagowca.
Ile kosztuje Sonnet 5.5
Aktualizacja, siódmego października: w rodzinie i cenniku zmian. Anthropic wypuściło Haiku 5.5, najtańszy model w ofercie: od 0,10 dolara za milion tokenów wejścia i 0,50 za wyjścia przy promptach do 100 tysięcy tokenów, z regulacją wysiłku i kontekstem miliona tokenów. Napisałem o nim osobny tekst. Jednocześnie odczyt pamięci podręcznej Sonnet 5.5 potaniał o połowę, z 0,20 do 0,10 dolara, co według wyliczeń producenta zdejmuje około 20 procent z typowej pracy agentowej. Do tego Max i Team dostają w tym tygodniu miesięczne kredyty API, odpowiednio 100, 200 i do 500 dolarów, których można używać poza limitami subskrypcji.
Cennik API nie ruszył: 2 dolary za milion tokenów wejścia, 10 za wyjścia, zapis do pamięci podręcznej 2,50 dolara i odczyt 0,20 dolara, który od siódmego października kosztuje 0,10 (patrz notka wyżej). Przetwarzanie wsadowe tnie rachunek o połowę. Dla porządku: Opus 5.5 kosztuje 4 i 20 dolarów, Fable 5.1 dziesięć i pięćdziesiąt, Haiku 5.5 od 0,10 do 0,50 na wejściu zależnie od długości promptu. Sonnet 5.5 przestał być dolną granicą rodziny, ale w czołówce rankingu wciąż wyrównuje się z GPT-6 Sol.
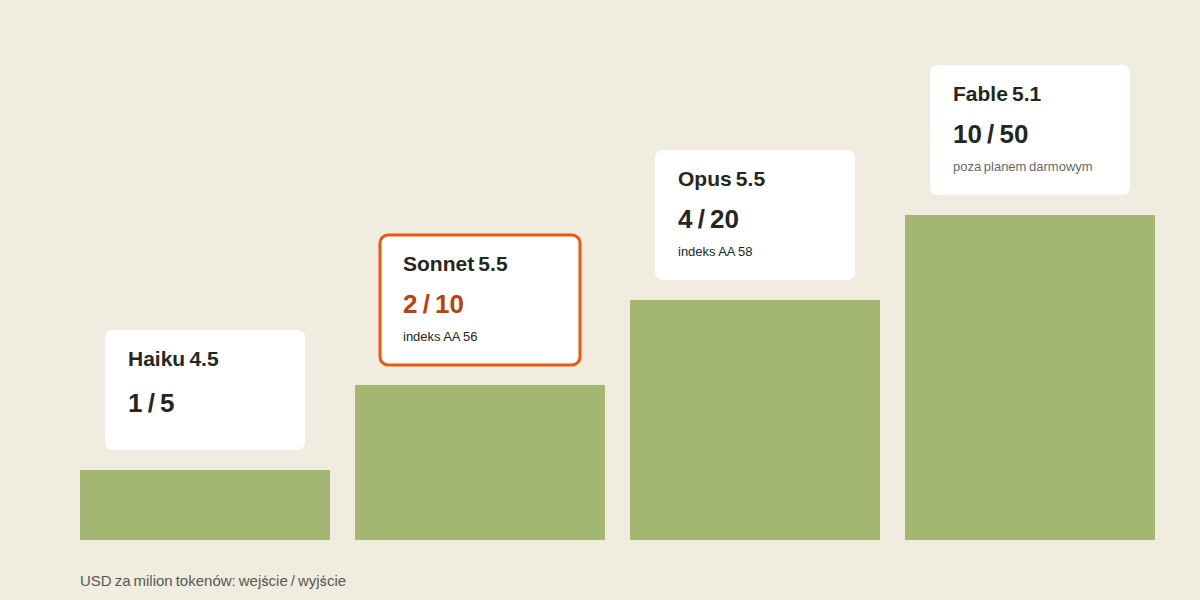
Na planach abonamentowych układ wygląda tak: Sonnet 5.5 jest dostępny na każdym planie, także darmowym, w ramach limitów danego planu. Opus wymaga konta płatnego. Pro kosztuje 17 dolarów miesięcznie przy rozliczeniu rocznym, 200 dolarów płatnych z góry, albo 20 dolarów przy rozliczeniu miesięcznym. Max zaczyna się od 100 dolarów i daje pięciokrotność albo dwudziestokrotność limitów Pro. Limity odnawiają się w pięciogodzinnych oknach, a na planach płatnych dochodzi do tego pulsa tygodniowa; po jej wyczerpaniu można dokupić kredyty rozliczane w stawkach API. Ceny modeli trzymamy na bieżąco w naszej tabeli narzędzi AI.
Ściąga dla zabieganych:
| Model | API wejście / wyjście (USD za 1M) | Indeks AA (max) | Dostępność |
|---|---|---|---|
| Haiku 5.5 | 0,10 / 0,50 (powyżej 100k tok. promptu: 0,50 / 2,50) | brak pomiaru | API i chmury od 7.10 |
| Sonnet 5.5 | 2 / 10 | 56 | wszystkie plany, także darmowy |
| Opus 5.5 | 4 / 20 | 58 | plany płatne |
| Fable 5.1 | 10 / 50 | brak pomiaru | poza planem darmowym; na Pro przez kredyty |
Gdzie włączyć Sonnet 5.5
Trzy miejsca, trzy ścieżki.
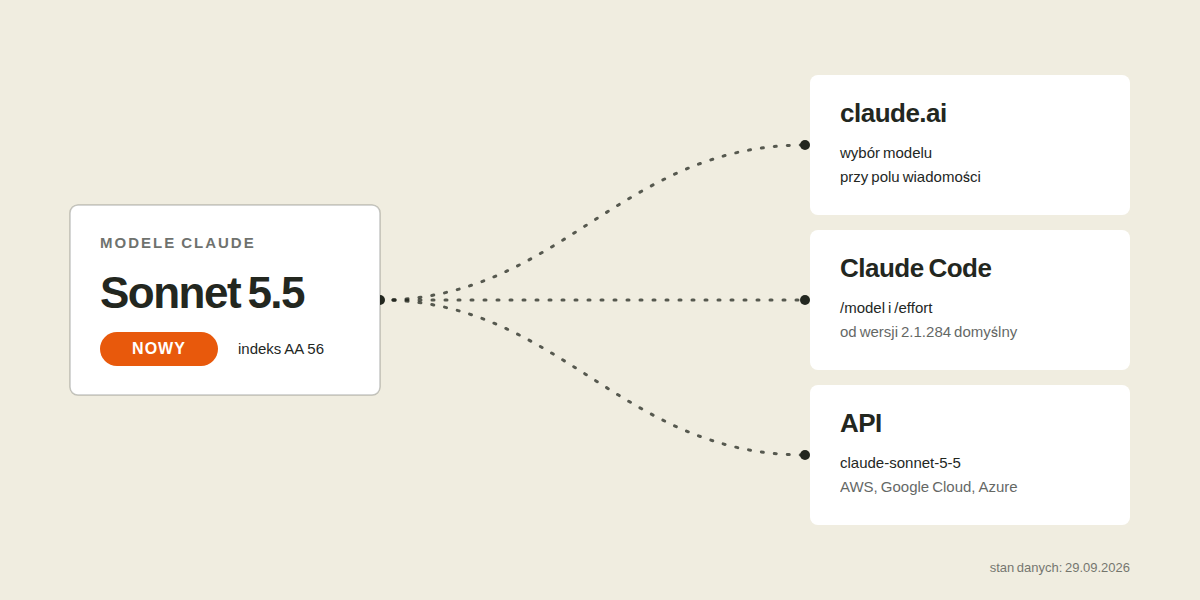
W przeglądarce i aplikacjach (claude.ai na webie, desktopie i telefonie) wybór modelu siedzi przy polu wiadomości; na planie darmowym do wyboru jest Sonnet 5.5 w ramach darmowych limitów, Opus pozostaje za płatną ścianą. W Claude Code wystarczy zaktualizować narzędzie do wersji 2.1.284 albo nowszej: od tej wersji domyślnym Sonnetem jest 5.5, przełącza się komendą /model, a suwakiem /effort reguluje poziom wysiłku od low do max. W API model występuje pod identyfikatorem claude-sonnet-5-5 i poza stroną Anthropic trafił od razu do AWS, Google Cloud i Azure, z deklaracją zero retention, czyli nieprzechowywania danych wejściowych.
Sonnet 5.5 czy Opus 5.5: który wybrać
Porównanie wychodzi mniej jednostronne, niż sugerują dwa punkty różnicy w rankingu. W benchmarkach pracy agenta nad kodem oba modele siedzą niemal równo, a Terminal-Bench wygrywa nowy Sonnet. Opus broni się tam, gdzie liczy się wiedza i fakty: 66 procent wobec 54 w AA-Omniscience, Humanity’s Last Exam 67,7 wobec 64,5, najtrudniejszy z testów kodowych FrontierCode 54,4 wobec 46,2. Sonnet odpowiada szybciej i przy płaceniu za tokeny wychodzi dwa razy taniej.
Na subskrypcjach płacisz limitem, więc wybór wygląda inaczej. Użytkownicy Claude Code opisują Sonnet 5.5 jako naturalny model na codzienne sesje, żeby nie spalać tygodniowej pulsy Opusem, i przeskakują na flagowca, gdy zadanie jest naprawdę ciężkie. Zdrowy układ jest ten sam, co przy poprzednich generacjach: codzienna robota na Sonnecie, Opus na zadania, których pierwsze podejście nie domyka. Sonnet 5.5 zaostrza tylko opłacalność tej zasady, bo odejście od flagowca przestało oznaczać wyraźny spadek jakości.
Uwaga: zabezpieczenia cyber potrafią zaskoczyć
Sonnet 5.5 jest pierwszym Sonnetem zabezpieczonym na poziomie Opusa 5.5, z klasyfikatorami wykrywającymi próby destylacji modelu. Anthropic pisze wprost, że rutynowa praca nad własnym kodem, szukanie i naprawa błędów, zostaje bez zmian, ale zadania cyberbezpieczeństwa wyższego ryzyka „widocznie” cofają się na starszego Sonnet 5. W pomiarach Artificial Analysis dotyczyło to około 0,1 procenta zadań, tylko że ten promil potrafi trafić w środek sensownego projektu.
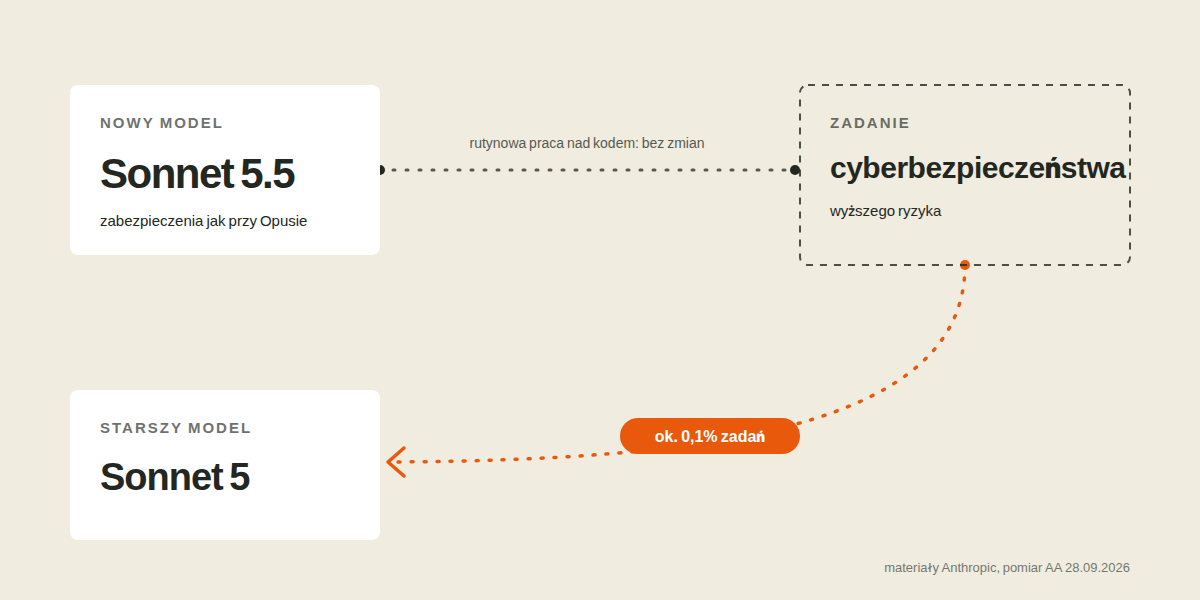
Na Hacker News zebrały się zgłoszenia fałszywych alarmów: analiza trzydziestoletniego kodu C z przepełnieniami bufora, praca przy parserach, a w jednym przypadku zwykła autoryzacja Bluetooth na ESP32 do czujnika obecności w inteligentnym domu. Po alarmie model spada na starszą wersję i jakość odpowiedzi spada razem z nim. Dla ludzi pracujących blisko bezpieczeństwa Anthropic prowadzi darmowy program weryfikacji cyber, ale uczestnicy tego wątku zgodnie narzekają, że w praktyce niewiele zmienia. Kto planuje poważną pracę przy bezpieczeństwie, powinien włączyć ten koszt do decyzji o przestawieniu się na nowy model.
Claude w Polsce
Polska jest na oficjalnej liście krajów wspieranych przez Anthropic, sprawdzałem to dziś bezpośrednio na ich stronie. Rozliczenie idzie w dolarach i polskiego cennika nie ma, więc ceny Pro i Max trzeba traktować jak stawki przeliczane przez bank przy płatności kartą. Interfejs aplikacji i Claude Code pozostaje po angielsku; model odpowiada po polsku, tak jak inne duże modele, ale oficjalnej polskiej wersji interfejsu nie ma.
Na koniec uczciwie: nie testowaliśmy Sonnet 5.5, bo artykuł powstał w ciągu doby od premiery. Benchmarki pochodzą z materiałów Anthropic oraz z pomiarów Artificial Analysis, które liczyło na buildzie przedpremierowym z błędem structured outputs, poprawionym przed wydaniem publicznym. Ceny i dostępność sprawdzałem w oficjalnym cenniku i na liście wspieranych krajów 29 września 2026, aktualizację z siódmego października w cenniku i dokumentacji API z tego dnia. Ilustracje są stylizowanymi mapami ścieżek, nie zrzutami ekranu. Gdy Haiku 5.5 trafi do aplikacji albo zmienią się limity planów, zaktualizuję ten tekst.
Źródła
- Anthropic, 28.09.2026: karta modelu Sonnet 5.5 (benchmarki, cena API, zabezpieczenia cyber) → anthropic.com
- Claude.com, dostęp 29.09.2026: cennik planów i API (Pro 17/20 USD, Max od 100 USD, Sonnet 5.5 na wszystkich planach) → claude.com
- Artificial Analysis, 28.09.2026: Sonnet 5.5 tuż za Opus 5.5 (indeks 56, koszt zadania 7,60 USD) → artificialanalysis.ai
- Claude Code CHANGELOG, 2.1.284: Sonnet 5.5 domyślnym Sonnetem, 1M kontekstu, suwak /effort → github.com
- Anthropic: lista wspieranych krajów (Polska obecna, dostęp 29.09.2026) → anthropic.com
- Hacker News, od 28.09.2026: wątek „Sonnet 5.5″, obserwacje użytkowników o limitach i fałszywych alarmach cyber → news.ycombinator.com