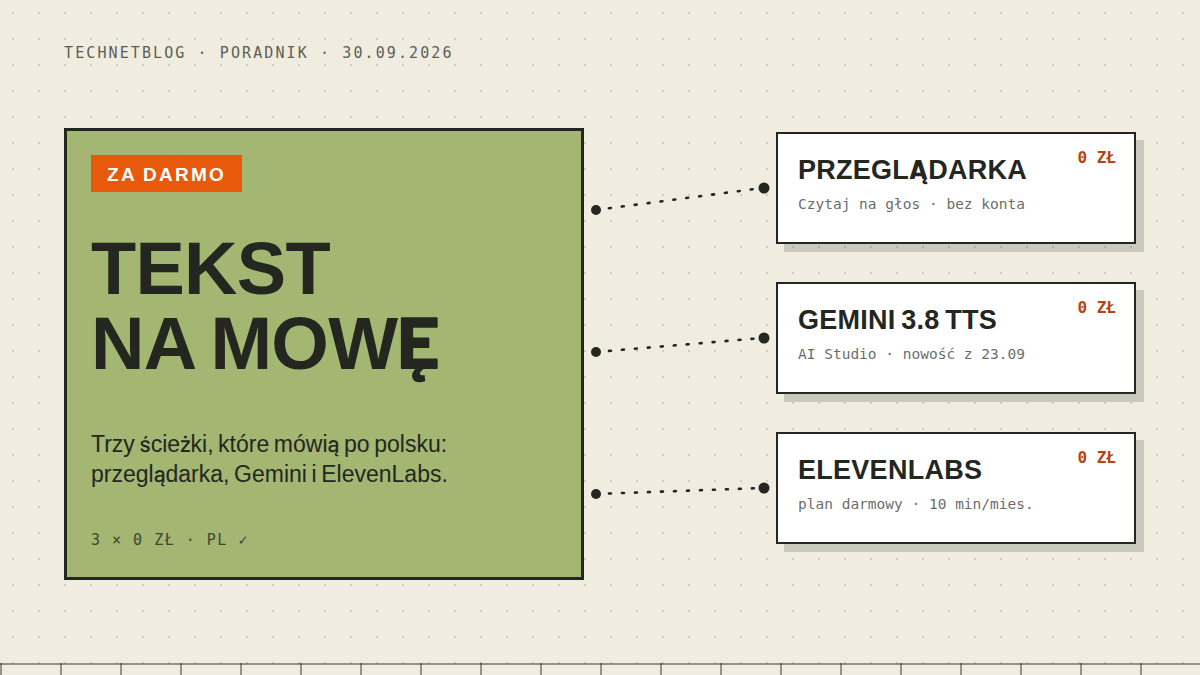
Dwudziestego trzeciego września Google wypuścił dwa modele do zamiany tekstu na mowę, Gemini 3.8 Flash TTS i Flash-Lite TTS, i oba od pierwszego dnia są dostępne za darmo na poziomie darmowym API oraz w AI Studio. Po polsku mówią od razu, dokumentacja wymienia nasz język wprost na liście obsługiwanych. To dobry moment, żeby poukładać w jedną całość to, co ludzie masowo wpisują w wyszukiwarkę od dawna: tekst na mowę ai, zamiana tekstu na mowę za darmo, darmowy lektor ai, syntezator mowy.
W tym poradniku przechodzę przez trzy ścieżki, które realnie kosztują zero złotych: czytnik wbudowany w przeglądarkę, nowy Gemini TTS w AI Studio i dziesięć minut miesięcznie w ElevenLabs. Na końcu jest ściąga, a w środku jeszcze jedna droga, całkiem bez internetu, którą przetestowaliśmy na zwykłym procesorze, bez karty graficznej.
Spis treści:
- Najpierw zdecyduj: czytasz dla siebie, czy nagrywasz
- Czytnik w przeglądarce: odczyt bez konta i limitów
- Gemini 3.8 TTS: darmowa nowość Google z 23 września
- ElevenLabs: dziesięć minut miesięcznie na start
- Całkiem bez internetu: Piper i głosy systemowe
- Ściąga: która ścieżka do czego
- Nota uczciwości
- Źródła
Najpierw zdecyduj: czytasz dla siebie, czy nagrywasz
Zamiana tekstu na mowę służy w praktyce dwóm różnym rzeczom. Pierwsza to odczytanie czegoś dla siebie: artykułu, PDF-a, długiego dokumentu, kiedy oczy są zajęte albo tekst ma osiem tysięcy słów. Druga to zrobienie nagrania, które gdzieś wstawisz: lektora do filmu, głosu do prezentacji, wersji audio własnej notatki.
Od tego rozróżnienia zależy wybór ścieżki. Do czytania dla siebie wystarczy przeglądarka, bez żadnego konta i bez limitów. Do nagrań potrzebujesz narzędzia AI, a tam pojawiają się limity dobowe, licencje i pytanie, co dzieje się z twoim tekstem na cudzym serwerze. W tabelkach porównawczych te trzy rzeczy giną najczęściej, a to one rozstrzygają wybór.
Czytnik w przeglądarce: odczyt bez konta i limitów
Microsoft Edge ma wbudowaną funkcję Czytaj na głos. Klikasz prawym przyciskiem na otwartej stronie albo PDF-ie, wybierasz odczyt i słuchasz. Konto nie jest potrzebne, licznik nie istnieje, a głosy przychodzą z systemu. Gdy brakuje pakietu językowego, doinstalowuje się go w ustawieniach Windows (Czas i język, następnie Mowa), co Microsoft opisuje krok po kroku na stronie wsparcia. W Wordzie działa z tej samej rodziny Przeczytaj na głos, przydatne przy dokumentach, które masz otwarte w edytorze.
Do czytania długich tekstów ta ścieżka wygrywa bez walki. Ma jedną twardą granicę: nie dostaniesz z niej pliku z nagraniem. Funkcja gra na żywo i niczego nie zapisuje, więc na lektora do filmu się nie nadaje. Do tego potrzebujesz modelu, który wygeneruje plik audio na twoje zlecenie.
Gemini 3.8 TTS: darmowa nowość Google z 23 września
Google ogłosiło oba modele 23 września i nazwało je swoimi najbardziej ekspresyjnymi modelami audio do tej pory. Gemini 3.8 Flash TTS to wersja pełna, Flash-Lite tańsza i szybsza, celowana w duże wolumeny typu dubbing czy głosowe agenty. Dokumentacja API, aktualizowana dzień po premierze, mówi wprost: polski obsługiwany na obu modelach, łącznie Flash deklaruje ponad 130 języków, Flash-Lite ponad 100. Język rozpoznawany jest z samego tekstu, nie trzeba nic przełączać.
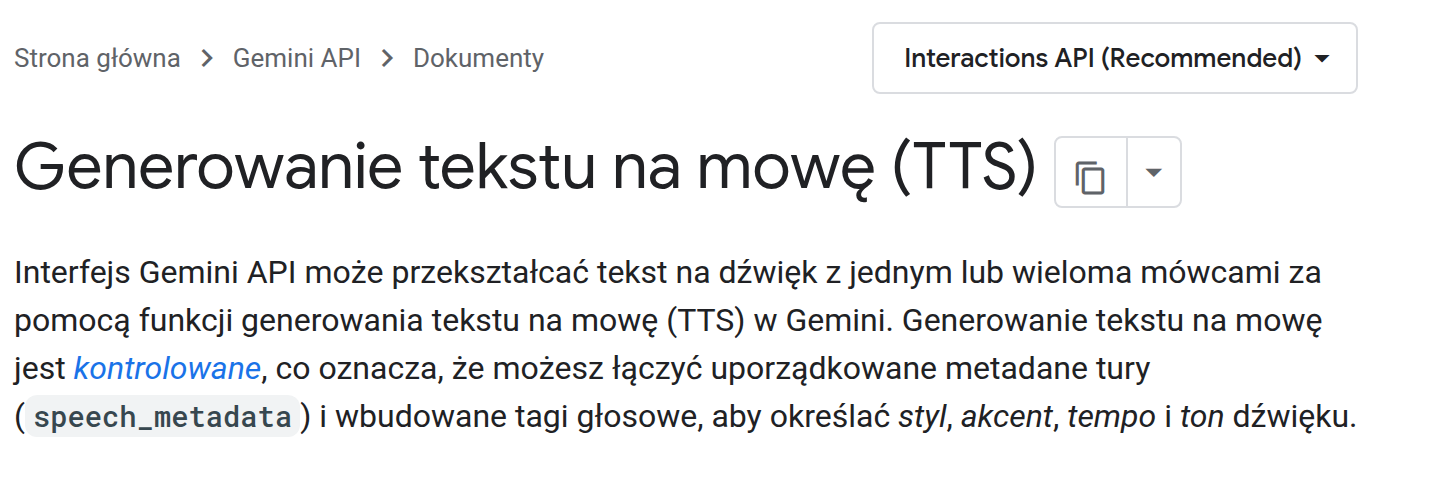
Wejście dla człowieka bez zaplecza programistycznego wygląda tak: logujesz się zwykłym kontem Google w AI Studio, gdzie jest osobny tryb generowania mowy. Wybierasz jeden z 30 fabrycznych głosów o nazwach w stylu Zephyr, Kore czy Puck, wklejasz tekst i słuchasz wyniku. Do tego dochodzi biblioteka rozszerzona z setkami głosów, a łącznie Google deklaruje ponad dwa tysiące głosów gotowych do pracy w API. Tekst można reżyserować linię po linii: wtrącać pauzy, śmiech albo westchnienie tagami w rodzaju <short pause> czy <laugh>, opisywać styl wypowiedzi jako na przykład radosny i przyjazny, a w jednej scenie rozmawiać dwoma głosami naraz.
Koszty wyglądają tak. W AI Studio korzystanie jest bezpłatne we wszystkich regionach, bez karty płatniczej. W API oba modele też mają poziom darmowy, free of charge, z dobowymi limitami zapytań. Google nie publikuje już jawnej tabeli liczb dla poszczególnych modeli, limity widać dopiero po zalogowaniu w AI Studio, a licznik dobowy resetuje się o północy czasu pacyficznego. Dla skali: płatnie wychodzi około 0,002 dolara za dziesięć sekund nagrania, więc nawet stawki komercyjne są tu symboliczne.
Jest w tym wszystkim jeden zapis, który łatwo przewinąć. Na poziomie darmowym cennik Google zaznacza wprost, że firma może używać twoich zapytań do trenowania własnych produktów. Przy tekście, który i tak wrzucasz publicznie, to bez znaczenia. Przy czegokolwiek poufnym, już nie. Ten sam mechanizm opisywaliśmy przy okazji ciasteczka __obi, którym ChatGPT zbierał dane o odwiedzanych stronach. Zapis o trenowaniu stoi w cenniku na widoku, w kolumnie poziomu darmowego.
Na marginesie: replikacja czyjegoś głosu z 30-sekundowej próbki wymaga według Google weryfikacji zgody mówcy, a wygenerowane nagrania są znakowane watermarkiem SynthID. Zaznaczam, że to deklaracje producenta, nie nasza weryfikacja. Nawigacja po nowych modelach jest prosta: gemini-3.8-flash-tts i gemini-3.8-flash-lite-tts to nazwy aktualne, starsze pozycje z dopiskiem preview zostają w dokumentacji dla istniejących projektów.
ElevenLabs: dziesięć minut miesięcznie na start
Druga ścieżka to ElevenLabs, usługa płatna z założenia, ale z planem darmowym, na którym da się realnie pracować. Dostajesz 10 tysięcy kredytów miesięcznie, zamiana tekstu na mowę kosztuje jeden kredyt za znak, a cennik w podsumowaniu planu przelicza to na około dziesięć minut nagrania. Kredytów nie przenosisz na kolejny miesiąc, więc jeśli masz dłuższy scenariusz, dziel go na raty albo czekaj na odnowienie. W pakiecie są też efekty dźwiękowe, projektowanie własnego głosu i trzy projekty w Studio.
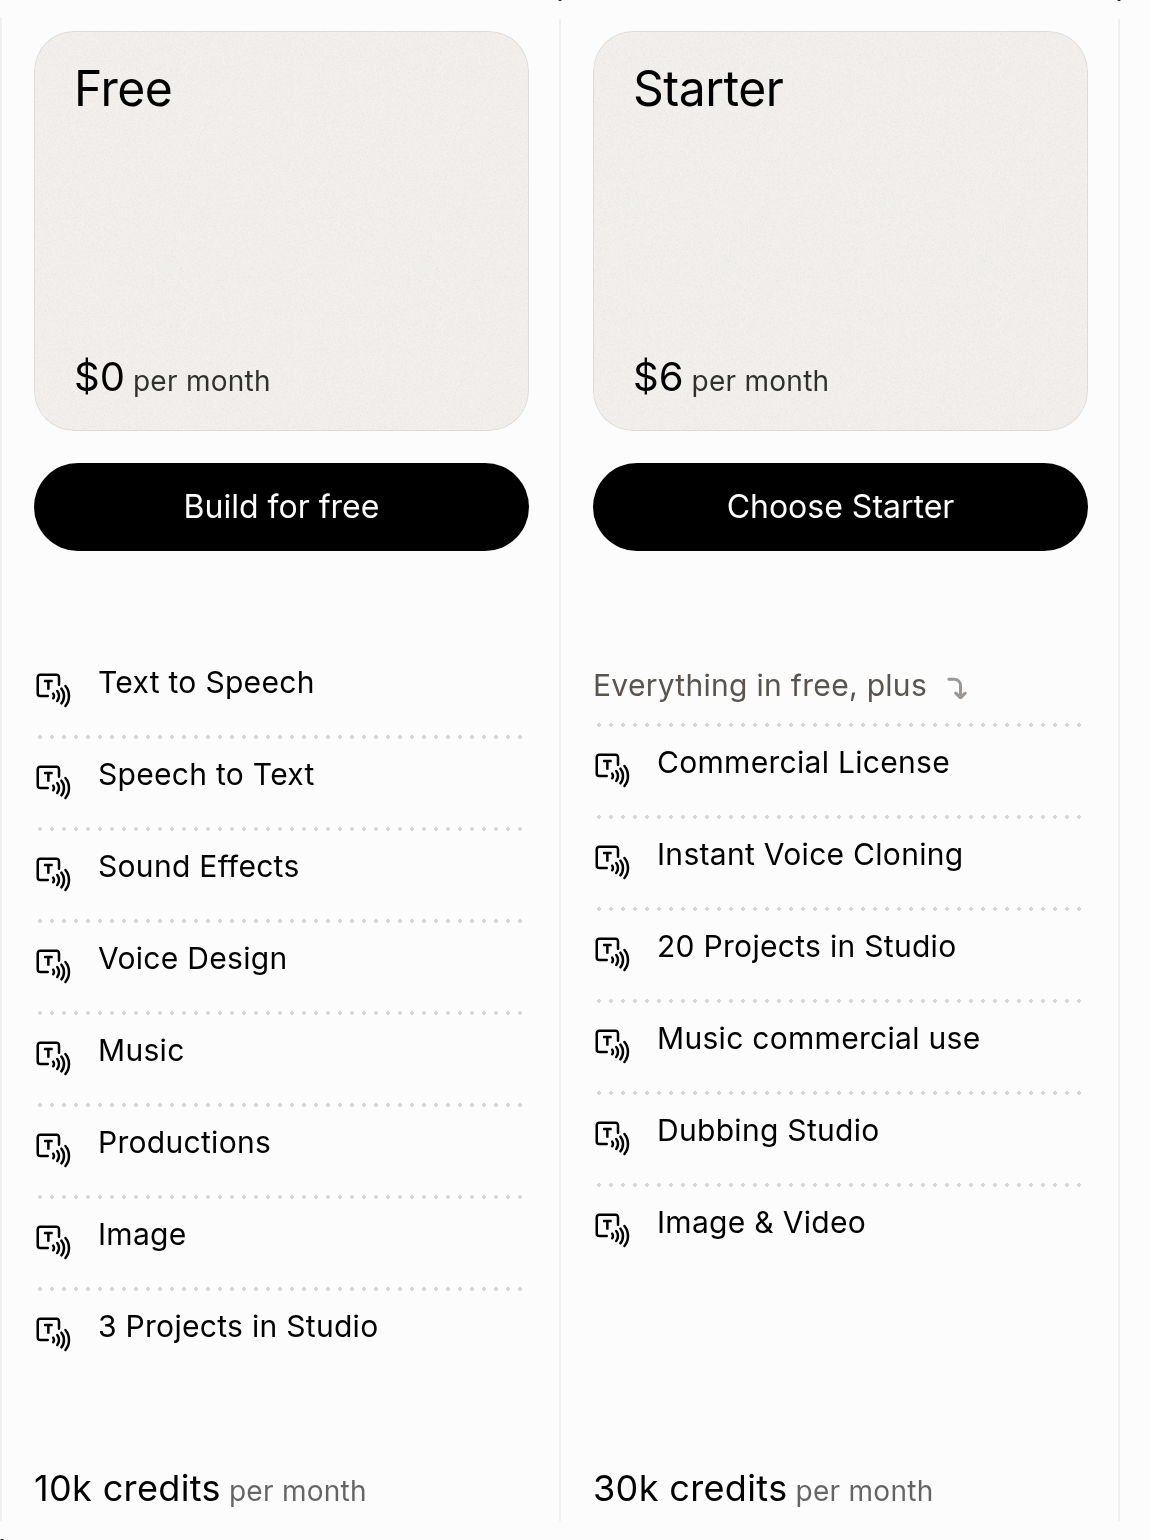
Polski jest wspierany i to nie marketingowo: dokumentacja wymienia go wprost na liście 29 języków modelu Multilingual v2, a nowsze modele deklarują 74 języki. Najważniejsza różnica wobec Gemini siedzi jednak w licencji. Plan darmowy nie obejmuje praw do użytku komercyjnego, ta pojawia się dopiero w Starterze za 6 dolarów miesięcznie. Audio, które wygenerujesz, pozostaje twoje, ale jeśli chcesz na nim zarabiać, potrzebujesz planu płatnego. Do testów, podcastu hobbystycznego albo głosu w szkolnej prezentacji to bez znaczenia. Dla kanału, który monetyzuje, już tak.
Jeśli rozważysz kiedyś plan płatny, cennikiem tego i kilku innych narzędzi dzielimy się w tabeli narzędzi AI, aktualizowanej z oficjalnych stron.
Całkiem bez internetu: Piper i głosy systemowe
Trzecia droga omija serwery w ogóle. Polska ma tu długą historię: IVONA z Gdańska była tak dobrym syntezatorem, że w styczniu 2013 kupił ją Amazon, a TechCrunch wiózł wtedy tytuł o konkurencji dla Siri. Stąd sentymentalne zapytania o syntezator mowy ivona, które wciąż żyją w podpowiedziach Google.
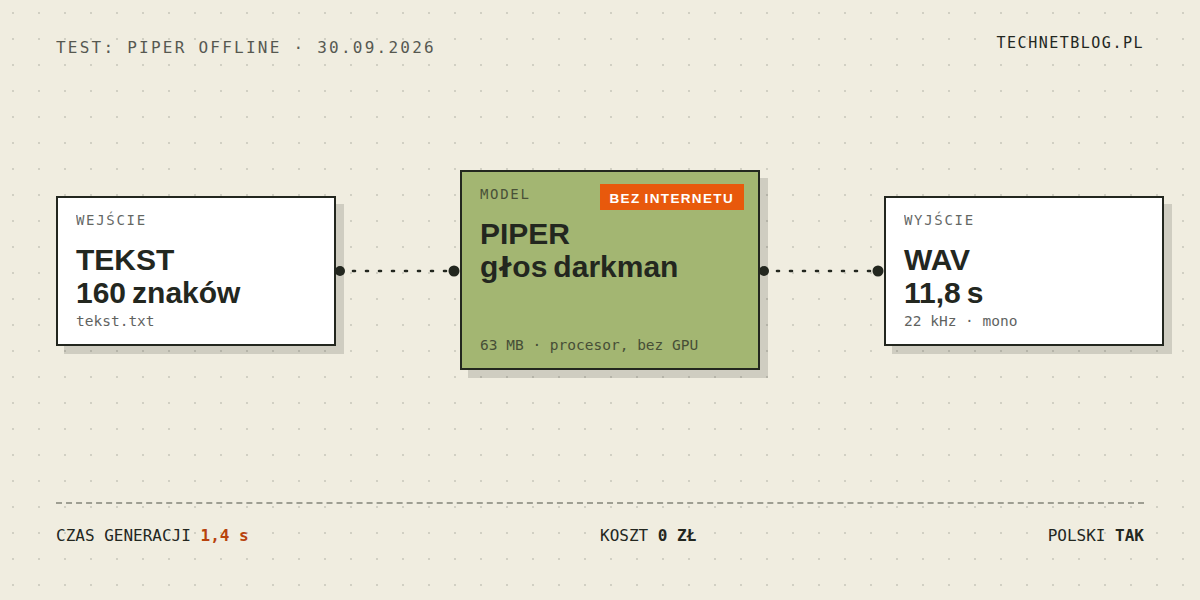
Współczesnym odpowiednikiem tamtej epoki, tyle że otwartym i darmowym, jest Piper: mały model neuronowy działający na zwykłym procesorze. Przetestowaliśmy go trzydziestego września na maszynie bez karty graficznej. Instalacja to jedno polecenie, polski głos darkman to plik o rozmiarze 63 MB z repozytorium Hugging Face, a tekst 160 znaków zamienił się w 11,8 sekundy dźwięku w ciągu 1,4 sekundy czasu zegara. Plik WAV, 22 kHz, mono, zero połączenia z siecią w trakcie pracy.
pip install piper-tts
python3 -m piper -m pl_PL-darkman-medium.onnx -f nagranie.wav < tekst.txt
Jak taki głos brzmi, ocenisz sam, model ściągniesz w minutę i nie zapłacisz nic. Jakości audio nie oceniamy w tym tekście na słuch. Dla większości ludzi wariant offline to ciekawostka albo zapas na moment, gdy łącze zawodzi. Jest jednak scenariusz, w którym wygrywa z resztą od razu: teksty, których nie chcesz wysyłać żadnej firmie, bo nic nie opuszcza twojego komputera.
Ściąga: która ścieżka do czego
| Cel | Ścieżka | Koszt | Główny limit |
|---|---|---|---|
| Przeczytać artykuł albo PDF | Czytaj na głos w Edge | 0 zł | brak, działa bez konta |
| Nagranie po polsku na własne potrzeby | Gemini 3.8 TTS w AI Studio | 0 zł | dobowe limity, na free trening produktów Google |
| Próba lektora do filmu | ElevenLabs, plan darmowy | 0 zł | 10 minut miesięcznie, bez licencji komercyjnej |
| Teksty poufne albo praca offline | Piper lub głosy systemowe | 0 zł | jakość zależy od wybranego głosu |
Nota uczciwości
Ścieżki opisujemy według oficjalnej dokumentacji i cenników z 30 września 2026. Nie zakładaliśmy kont w AI Studio ani w ElevenLabs, więc ścieżek w interfejsach nie potwierdzaliśmy na żywych profilach. Jakości brzmienia głosów nie oceniamy na słuch; benchmarki i deklaracje producentów przytaczamy jako ich twierdzenia. Jedyny test przeprowadzony w całości u nas to Piper w sekcji offline, z liczbami podanymi przy opisie.
Źródła
- DeepMind: Say hello to Gemini 3.8 text to speech, 23.09.2026
- Dokumentacja Gemini API: Text-to-speech generation, aktualizacja 24.09.2026
- Cennik Gemini Developer API, aktualizacja 24.09.2026
- ElevenLabs: Pricing, stan na 30.09.2026
- ElevenLabs: Text to Speech, dokumentacja
- Microsoft: Pobieranie języków i głosów dla czytnika immersyjnego, trybu czytania i funkcji Czytaj na głos
- Piper, repozytorium na GitHubie oraz polskie głosy na Hugging Face
- TechCrunch: Amazon Gets Into Voice Recognition, Buys Ivona Software, 24.01.2013
- TLDR AI z 24.09.2026, sygnał o premierze