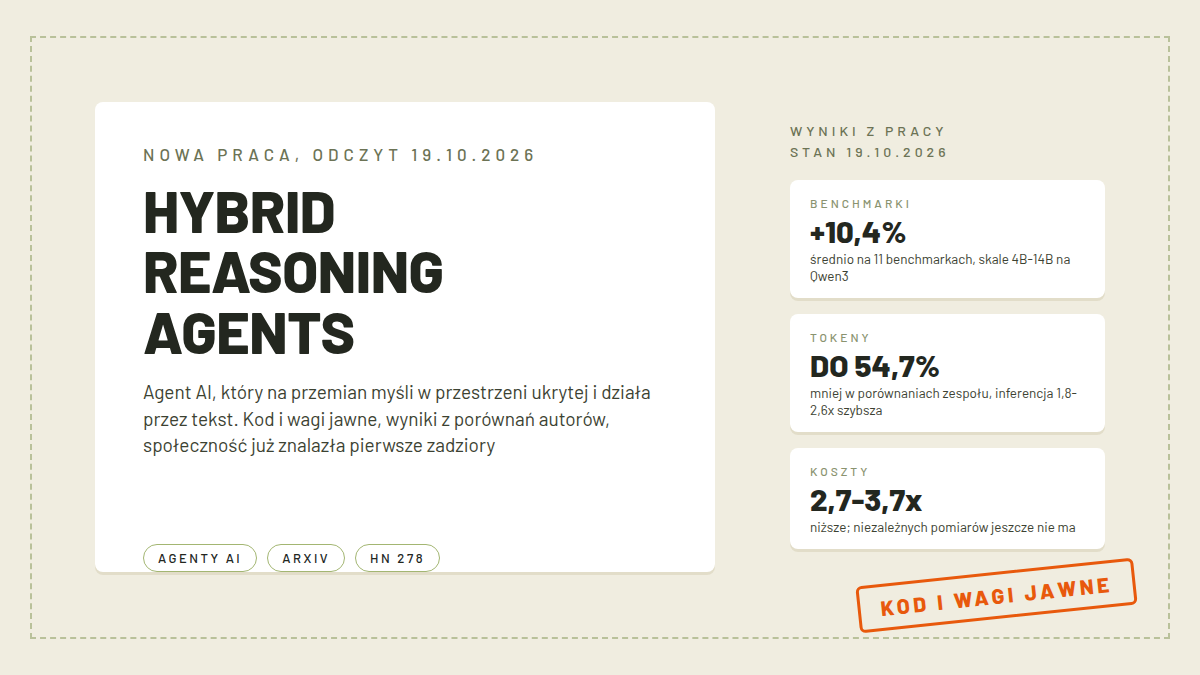
Agent AI opisany w tej pracy nie musi nic mówić do siebie, żeby zadać pytanie wyszukiwarce albo policzyć coś w Pythonie. W poniedziałek 13 października na arXiv pojawiła się praca „Hybrid Reasoning Agents” (oznaczenie 2610.18861, 45 stron), pod którą podpisało się ośmiu autorów ze Stanforda, Together AI, UIUC i Meta. Zespół zbudował HybridAgenta: model, który na przemian przechodzi w tryb myślenia w przestrzeni ukrytej, czyli w wektorach niewidocznych dla użytkownika, i wraca do zwykłego tekstu, kiedy trzeba wywołać narzędzie albo dać odpowiedź. Kod i wagi są jawne.
Dyskusja wybuchła w niedzielę 18 października na Hacker News: 278 punktów i 155 komentarzy przy odczycie z rana 19 października. To nietypowa mieszanka. Z jednej strony konkretne liczby z porównań autorów: 10,4% lepsze wyniki średnio na jedenastu benchmarkach, 35,5-54,7% mniej tokenów, inferencja 1,8-2,6 razy szybsza, koszty 2,7-3,7 razy niższe. Z drugiej gorący spór o to, czy chcemy agentów, których rozumowanie nie jest tekstem. Obie strony tej dyskusji mają sens i obie trafiły do tego tekstu.
- Najważniejsze informacje
- Jak działa agent, który myśli bez tekstu
- Czym to różni się od zwykłych agentów
- Co pokazują liczby, a czego jeszcze nie dowodzą
- Jak spróbować i ile to kosztuje
- Wątek bezpieczeństwa: myślenie bez świadków
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Czym jest | HybridAgent: agent AI łączący myślenie w przestrzeni ukrytej (latent space) z klasycznym działaniem przez tekst; moduł HybridLink i pamięć robocza przenoszona między turami |
| Kto za tym stoi | Ośmiu autorów: Jiaru Zou, Yunzhe Qi, Sirui Chen, Federico Bianchi, Shang Zhu, Pan Lu, Jingrui He, James Zou; afiliacje Stanford University, Together AI, UIUC, Meta |
| Kiedy | Praca na arXiv 13 października 2026, repozytorium na GitHubie utworzone 9 października, dyskusja HN 18 października |
| Kod | Repozytorium na GitHubie w organizacji togethercomputer, licencja MIT, Python; 171 gwiazdek przy odczycie 19 października |
| Modele i dane | Dwa checkpointy, 8B i 14B, na bazach Qwen3 na Hugging Face, licencja MIT; datasety treningowe HybridSFT i HybridRL |
| Wyniki wg autorów | Średnio +10,4% na 11 benchmarkach, 35,5-54,7% mniej tokenów, inferencja 1,8-2,6x szybsza, koszty 2,7-3,7x niższe |
| Czego brakuje | Zero niezależnych pomiarów; pierwsze relacje użytkowników z kwantyzacji GGUF opisują zapętlanie myślenia |
| Kontekst | Rozwija nurt latent reasoning; w pracy porównanie z COCONUT od Meta na tym samym modelu bazowym |
Jak działa agent, który myśli bez tekstu
W klasycznym agencie rozumowanie to fizycznie tekst. Model generuje tokeny „najpierw sprawdzę X, potem Y”, każdy z nich kosztuje przy wejściu i wyjściu, a całość widać w logach. W przestrzeni ukrytej stan myślenia to wektor liczb, który siedzi wewnątrz sieci i nigdy nie zamienia się w token. Teoretycznie gęstszy i tańszy, w praktyce do tej pory bezużyteczny dla agentów: nie dało się w połowie myśli wywołać narzędzia, bo narzędzia mówią w tekście.
Pomysł autorów na mostek nazywa się HybridLink. To lekka warstwa, która mapuje stany ukryte z ostatniej warstwy modelu z powrotem do przestrzeni wejściowych osadzeń, dzięki czemu agent może wejść w tryb latentny, pomyśleć kilka kroków bez generowania tokenów i wyjść z powrotem do tekstu w momencie, gdy ma dzwonić do wyszukiwarki albo pisać kod. Cały kontekst hybrydowy, czyli fragmenty tekstu, myśli w wektorach i obserwacje z narzędzi, niesie między turami własna pamięć robocza agenta.
Co zaskakujące, myśli wcale nie muszą zostawać czarną skrzynką. Każdy krok latentny można odwzorować jako pseudo-tekst, mapując wektor do najbliższego osadzenia tokena. W dokumentacji repozytorium widać to na przykładzie pytania, za ile sekund dźwięk pokonuje dziesięć kilometrów: model myśli w latentach z zadeklarowaną czytelnością 0,84-0,96, w połowie wywołuje wyszukiwarkę, potem Pythona, i podaje odpowiedź 29 sekund. Autorzy nazywają ten tryb Interpretable Latent Mode, a czytelność na żądanie wróci jeszcze w polemice o bezpieczeństwo.
Samo doklejenie mostka nie wystarcza, więc praca opisuje dwa etapy treningu. HybridSFT uczy model współpracy z HybridLinkiem na przygotowanych trajektoriach hybrydowych, a HybridRL dostraja już metodą wzmocnienia, kiedy warto myśleć w latentach, a kiedy działać przez tekst. W wypowiedzi Jiaru Zou z 14 października cała idea mieści się w trzech zdaniach: „Twój agent LLM musi myśleć na głos, token po tokenie, zanim przeszuka, uruchomi kod albo zadziała w świecie. My ludzie nie: rozmyślamy w ciszy i mówimy, kiedy to ma znaczenie” („We ponder in silence and speak when it matters”).
Czym to różni się od zwykłych agentów
Porównanie najlepiej robić na trzech poziomach: rachunku, prędkości i audytowalności. Rachunek jest prosty w teorii: ślad rozumowania w tekście to tysiące tokenów, które płaci się dwa razy, przy wysyłaniu i przy generowaniu. Jeśli myślenie dzieje się w wektorach, tych tokenów nie ma. Deklaracje autorów mówią o 35,5-54,7% oszczędności tokenów i 2,7-3,7x niższych kosztach w ich porównaniach, co przy agentach pracujących hurtowo na API byłoby odczuwalne w rachunku miesięcznym. Prędkość idzie w parze, bo mniej tokenów znaczy mniej przejść dekodera.
Audytowalność to poziom, na którym zgodność kończy się. Przy zwykłym agencie ślad rozumowania czytasz jak dziennik: widzisz, kiedy model zdecydował się na wyszukanie, co wtedy sądził i czy nie zaczął kombinować. Latentna myśl jest domyślnie niewidoczna, więc pytanie „co model naprawdę chciał” przestaje mieć tanią odpowiedź. Hybrydowa konstrukcja częściowo broni tej strony: tryb tekstowy wraca przy każdej akcji zewnętrznej, a myśli latentne da się rzutować na pseudo-tekst. Częściowo, bo rzutowanie wektora na najbliższy token zawsze gubi coś z sensu, o czym pisali komentujący.
Warta uwagi jest też skala wysiłku treningowego. Dokumentacja podaje dla etapu HybridSFT zalecane 8 albo 16 GPU, a dla HybridRL 32 GPU w konfiguracji czterech węzłów po osiem kart. To nie jest projekt na weekend z jednym RTX-em, przynajmniej jeśli ktoś chce odtworzyć trening od zera. Inferencja gotowych modeli to inna historia, do niej wracam niżej.
Co pokazują liczby, a czego jeszcze nie dowodzą
Dobrą miarę stanu wiedzy daje anegdota z dyskusji. Pierwsze pytanie wątku, od użytkownika 44za12, brzmiało: „Where are the benchmarks?” i pytało wprost, czy to tylko przyspieszenie inferencji, czy też wzrost trafności. Odpowiedź padła po kilku minutach od innego komentującego: benchmarki są w pracy, od dziewiątej strony. Faktycznie są: jedenaście benchmarków z matematyki, nauk, medycyny, wyszukiwania i rozumowania agentowego, z nazwami takimi jak AIME, GPQA, MATH-500, MedQA, GAIA, WebWalker i HLE, na trzech skalach modeli 4B, 8B i 14B zbudowanych na bazach Qwen3.
Wszystkie te liczby pochodzą z porównań autorów, nie z niezależnych powtórzeń. Zespół stawia HybridAgenta obok agentów opartych o modele graniczne i obok frameworków agentycznych, tekstowych i latentnych, i raportuje średnio +10,4% skuteczności przy jednoczesnej oszczędności tokenów i czasu. To obiecująca paczka liczb, tyle że deklaracja producenta zawsze wymaga dozoru. Nie testowaliśmy sami żadnego z modeli, więc trzymamy się tego, co jest w pracy i w repozytorium, a wątpliwości zapisujemy wprost.
Ciekawy punkt odniesienia siedzi w samej pracy. COCONUT, wcześniejsza metoda Meta dla myślenia w przestrzeni ukrytej, pojawia się w analizach treningowych jako porównanie na tym samym modelu bazowym Qwen3-14B. To plasuje HybridAgenta w istniejącym nurcie latent reasoning, z wyraźnym celem: zabrać z tego nurtu oszczędności, a przywrócić mu dostęp do narzędzi, czego COCONUT natywnie nie miał. Dla skali zainteresowania: kanał Google News dla nazwy pracy zwracał przy odczycie 19 października zero wyników, więc polski opis jest jednym z pierwszych tekstów na ten temat.
Jak spróbować i ile to kosztuje
Kod leży na GitHubie pod licencją MIT, w Pythonie, z instrukcją instalacji przez conda i plikiem wymagań. Checkpointy HybridAgent-8B-Agentic i HybridAgent-14B-Agentic są na Hugging Face, oba na bazach Qwen3 i oba z wagami HybridLinka dołączonymi jako adapter; przy odczycie 19 października każdy z modeli miał po blisko tysiącu pobrań. Datasety treningowe HybridSFT i HybridRL też są publiczne, łącznie z trajektoriami hybrydowymi. Narzędzie wyszukiwania użyte w agentze to Tavily, więc do pełnego działania potrzebny jest klucz API tej usługi, nie tylko sprzęt.
Praktyczna droga na własnym sprzęcie prowadzi dziś przez kwantyzacje społeczności: mradermacher opublikował GGUF modelu 8B (licencja MIT, 676 pobrań przy odczycie 19 października) pod llama.cpp. Tu uczciwa nota: obie negatywne relacje z dyskusji dotyczyły właśnie tej drogi. Użytkownik SwellJoe pisał, że 14B w llama.cpp z kwantyzacją 8-bit zapętlało się na wariacjach tego samego akapitu przez pięć minut, na zadaniu, które podobnej wielkości modele robią bez problemu. Drugi komentujący testował GGUF 8B na pytaniu „Kto jest papieżem?” i uzyskał nieskończoną pętlę myślenia. Przyczyny mogą być różne, łącznie z możliwą niepełną obsługą trybu latentnego w samym narzędziu, ale w momencie pisania nie znaleźliśmy relacji z pełnych checkpointów na własnym sprzęcie, więc na razie traktujemy obie zapiski jako ostrzeżenie, nie jako wyrok. Spróbujemy i dopisze.
Wątek bezpieczeństwa: myślenie bez świadków
Ton części dyskusji wyznaczyła żartobliwa uwaga cwyersa: „O fajnie, Najzakazniejsza Technika” („Oh cool, it’s the Most Forbidden Technique”), nawiązanie do eseju Zviego Mowshowitza z marca 2025 o technikach, które psują własne narzędzia kontroli. W toku wymiany komentujący abecedarius doprecyzował, że praca nie realizuje dosłownie tamtej techniki, tylko podchodzi do problemu z drugiej strony: odbiera monitorującym tekstowy ślad rozumowania, czyli inna droga do tej samej straty. Inni szli dalej. „W skrócie: nie widzimy już tekstowych śladów rozumowania, więc modelom łatwiej nas oszukać przy złośliwych planach” pisał lnenad. A sailingparrot skwitował całość: „Z entuzjazmem ścigamy się do usunięcia jedynej praktycznej drogi monitorowania intencji modeli w zamian za kilka procent [mniej tokenów]. Nie mogę się doczekać”.
Ta obawa ma twardy rdzeń, który znamy z osobnej rozmowy o bezpieczeństwie agentów AI: jeśli monitoring śladu rozumowania to dziś jeden z niewielu działających mechanizmów wczesnego ostrzegania, to jego utrata wymaga jakiegoś zamiennika, zanim agenty myślące w latentach trafią na produkcję. Druga część wątku przyjęła pracę dokładnie odwrotnie. Modeless argumentował, że wielkie laboratoria i tak boją się utraty śladu rozumowania, bo na nim opierają kontrolę modeli, i przewidywał, że skończymy z osobnymi modelami nadzorującymi albo dekodującymi przestrzeń ukrytą. A chabons przywołał konstrukcję z pracy: każdy span latentny da się zrzutować na pseudo-tekst równaniem 5, tyle że rzutowanie gubi kombinacje pojęć, których nie da się wyrazić jednym tokenem. Czytelność jako opcja to nie to samo co czytelność domyślna, ale to znacznie więcej niż czarna skrzynka.
Źródła
- Abstrakt i metadane pracy (autorzy, afiliacje w README repo, daty, wyniki), odczyt 19.10.2026: https://arxiv.org/abs/2610.18861
- Pełna wersja HTML pracy (benchmarki, skale 4B/8B/14B, porównanie z COCONUT), odczyt 19.10.2026: https://arxiv.org/html/2610.18861v1
- Repozytorium kodu HybridAgent (licencja MIT, instalacja, wymagania sprzętowe, przykłady), odczyt 19.10.2026: https://github.com/togethercomputer/HybridAgent
- Model HybridAgent-8B-Agentic na Hugging Face (licencja MIT, licznik pobrań), odczyt 19.10.2026: https://huggingface.co/togethercomputer/HybridAgent-8B-Agentic
- Kwantyzacja GGUF modelu 8B od mradermacher, odczyt 19.10.2026: https://huggingface.co/mradermacher/HybridAgent-8B-Agentic-GGUF
- Wątek Hacker News (278 punktów, 155 komentarzy policzone rekurencyjnie, cytaty), odczyt 19.10.2026: https://news.ycombinator.com/item?id=50145337
- Wątek X Jiaru Zou z 14.10.2026 (cytat „ponder in silence”, 557 polubień), odczyt 19.10.2026: https://x.com/Jiaru_Zou/status/2110400256647340476
- Esej „The Most Forbidden Technique” Zviego Mowshowitza z 12.03.2025 (przywołany w wątku HN z linkiem), odczyt 19.10.2026: https://thezvi.substack.com/p/the-most-forbidden-technique
Skracanie łańcuchów rozumowania idzie w dwóch kierunkach: agenci zwężają myślenie w trakcie pracy, a wytwórcy modeli pieczą skrócenie w wagach. Świeży przykład drugiej drogi to ThinkingCap na Gemmie 4: o 39 procent krótsze rozumowanie przy zachowanej dokładności.