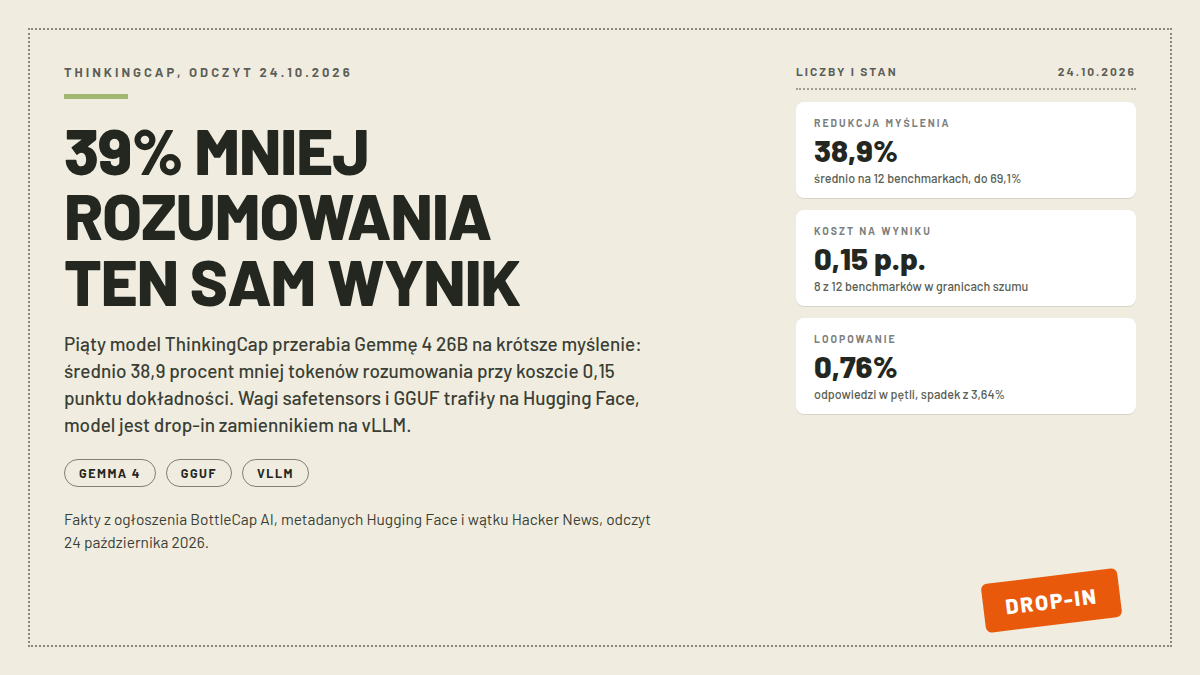
23 października 2026 firma BottleCap AI opublikowała piąty model z serii ThinkingCap, pierwszy zbudowany na modelu Google: ThinkingCap-gemma-4-26B-A4B-it, czyli przestrojoną Gemmę 4 w wariancie 26B z mieszaniną ekspertów i około 4B parametrów aktywnych na token. Efekt podany w ogłoszeniu: o 38,9 procent mniej tokenów myślenia mierzone na dwunastu benchmarkach, w skrajnych przypadkach do 69,1 procent, przy koszcie 0,15 punktu procentowego dokładności. Wagi trafiły na Hugging Face tego samego dnia (odczyt metadanych 24.10), obok poszły buildy GGUF, więc model da się odpalić lokalnie na zwykłym sprzęcie.
Po co w ogóle ktoś tnie myślenie? Bo rozumowanie jest najdroższą częścią pracy modelu rozumującego: każdy token „dumania” to czas odpowiedzi i pieniądze w inferencji. W wpisie o hybrydowych trybach rozumowania opisywałem scenę od drugiej strony, gdzie agenci same skracają łańcuchy myśli kosztem jakości; ThinkingCap to podejście od strony treningu, w które skrócenie jest zapieczone w wagach, a użytkownik nie musi nic konfigurować.
- Najważniejsze informacje
- Co autorzy zrobili z Gemmą
- Jak uruchomić to lokalnie
- Co mówią użytkownicy z Hacker News
- Co to oznacza dla polskiego użytkownika
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Model | ThinkingCap-gemma-4-26B-A4B-it, piąty z serii, pierwszy na modelu Google (publikacja 23.10.2026) |
| Efekt | średnio 38,9% mniej tokenów myślenia, maksymalnie 69,1%, dokładność −0,15 p.p. (12 benchmarków) |
| Baza | google/gemma-4-26B-A4B-it: 26B parametrów, ok. 4B aktywnych na token (MoE) |
| Dokładna zgodność | drop-in replacement: te same ustawienia próbkowania (temperatura 1.0, top_p 0.95), ten sam stack vLLM |
| Zapętlenia | spadek z 3,64% do 0,76% odpowiedzi |
| Wagi | Hugging Face: safetensors + osobne repo GGUF, repo podaje Apache 2.0 (użycie rodziny Gemma regulują warunki Google) |
| Wersja PRO | deklarowane do 87,6% mniej myślenia (62% średnio), dystrybucja przez kontakt enterprise |
Co autorzy zrobili z Gemmą
Seria ThinkingCap opiera się na pomysłu trenowania modelu tak, by osiągał te same odpowiedzi krótszym łańcuchem myśli. To piąta odsłona: wcześniej przerobiono dwa Qweny (3.6 i 3.8 w 27B), NVIDIA Nemotron 3.5 Lightning 30B i Qwen3.8-Flash-Next. Gemma 4 26B jest pierwszym modelem Google w tym gronie i, jak podają autorzy, wariant z najmniejszym kosztem dokładności w całej serii.
Metodologia jest tu ważniejsza niż zwykle, bo modeli „mniej myśli” pojawia się co miesiąc, a połowa z nich porównuje się nieuczciwie. Tutaj obie strony, oryginał i ThinkingCap, biegały w tym samym harnessie na vLLM, z tymi samymi ustawieniami próbkowania zalecanymi przez Google, a wyniki bazowe zmierzono samodzielnie zamiast cytować katalogowe. Liczba seedów jest dobrane do głośności benchmarku: od 64 w matematycznych AIME i HMMT po 4 w wielkich zbiorach typu MMLU-Pro. Generacja ograniczona do 65536 tokenów na odpowiedź.
Wyniki z tabeli są bardziej zniuansowane niż nagłówek. Na ośmiu z dwunastu benchmarków różnica dokładności mieści się w szumie między seedami, a na pięciu ThinkingCap wychodzi ponad oryginał; IFBench plus 1,83 punktu, HMMT z lutego plus 1,28, LongBench v2 plus 1,45. Po drugiej stronie stoi AA-LCR z minus 4,00 punktami, którą autorzy nazywają wprost jedynym realnym kosztem w całym zestawie, oraz GPQA-Diamond z minus 0,96. Redukcje myślenia idą od 13,7 procent w instrukcjach po 69,1 procent na LongBench v2, a średnia z dwunastu to właśnie te 38,9 procent.
Odrębnym, praktycznym efektem jest spadek zapętlenia. Oryginalna Gemma wpadała w pętle na 3,64 procent odpowiedzi, ThinkingCap na 0,76, a w matematycznych benchmarkach, gdzie zapętlenie bolało najbardziej (do 17 procent na HMMT z lutego), spadek idzie do pojedynczych procent. Kto odpalał modele rozumujące lokalnie, zna ten widok: model kręci się w kółko i zjada tokeny, nic nie zwracając.
Jak uruchomić to lokalnie
Repo bottlecapai/ThinkingCap-gemma-4-26B-A4B-it na Hugging Face zawiera wagi safetensors, a osobne repo dostarcza buildy GGUF (oba utworzone 23.10.2026, odczyt 24.10). Repo modelu ma tag licencji Apache 2.0, z tą uwagą, że rodzina Gemma podlega warunkom licencyjnym Google, więc przed komercyjnym użyciem te warunki trzeba przeczytać samodzielnie. Wersja PRO z jeszcze mocniejszym cięciem myślenia nie ma publicznych wag; autorzy ją rozdają przez kontakt enterprise, co w komentarzach na HN przyjęło się z przymrużeniem oka.
Co do sprzętu, poniższa arytmetyka to szacunek, nie pomiar: 26 miliardów parametrów w BF16 to około 52 GB pamięci, więc pełnoprecyzyjny bieg to stacja z dużą kartą albo serwer. Kwantyzacja 4-bit w GGUF zje jakieś 15-17 GB, co mieści się na kartach 24 GB wygodnie, a na 16 GB na styk. Aktywnych parametrów jest około 4B na token, więc prędkość generacji powinna być lepsza niż sugeruje rozmiar pliku; deklarowanym środowiskiem serwowania jest vLLM, a na komputerze osobistym ten sam model w GGUF odpali się w llama.cpp albo LM Studio. Podstawowa Gemma 4 26B to jeden z popularniejszych modeli lokalnych na Hugging Face (ponad 8,6 miliona pobrań wg metadanych), więc ekosystem kwantyzacji i poradników jest już ustawiony.
Co mówią użytkownicy z Hacker News
Dyskusja jest stosunkowo spokojna, ale daje obraz z praktyki. Użytkownik dofm opisuje codzienne używanie podstawowej Gemmy na starym M1 Max: „with ”Reasoning strength: low” in the system prompt, it’s just kind of nice to use. It’s not really slow (…), it writes well, etc.” Jego zdaniem Gemma 4 jest po prostu przyjemna w rozmowie, co czyni wersję o krótszym myśleniu naturalnym wyborem na słabszym sprzęcie.
Sceptycy mają swoje linie obrony. PaulKeeble testował wcześniejsze odsłony serii i jego doświadczenie brzmi: „its not as smart and capable, the results on the same task were less impressive.” Syntaxing dorzuca obserwację, że wersja ThinkingCap była „noticeably more censored” niż wyjściowy Qwen 27B, co przy treningu przeciw nadmiernemu myśleniu dało efekt uboczny w postaci ostrożniejszych odpowiedzi. Najmocniejsza kontra pochodzi od verdverm, który opisuje analogiczny produkt Fireworks (Ember-1, skrócone myślenie na Kimi K3): „It hallucinated and claimed task completion almost every session. Zero trust for this concept of fine tuning out excessive thinking.”
Najciekawszy komentarz merytoryczny zostawia arjie: „smaller models are moving parameter-level thinking into inference time (…) There’s some conservation of difficulty for tasks and you either do the computation in the model or you do it in the looped iterations of the model.” To zdanie dobrze spina całość: tokeny myślenia i tokeny iteracji to dwa konta, na których płacisz za tę samą trudność, a ThinkingCap tylko przenosi rachunek między nimi.
Co to oznacza dla polskiego użytkownika
Dla kogoś, kto odpala modele lokalnie, argument cenowy nie istnieje (prąd jest tanio), ale istnieje czas: o 39 procent krótszy łańcuch myśli to w praktyce odpowiedź, która przychodzi wyraźnie szybciej, na tym samym sprzęcie. Dla kogoś, kto hostuje modele dla zespołu, to już realna redukcja rachunku za inferencję przy deklarowanie pomijalnym koszcie jakości, z jednym zaznaczonym wyjątkiem AA-LCR.
Wąskim gardłem pozostaje licencja: Gemma ma własne warunki Google, inne niż w pełni otwartych Qwenów, więc przed wdrożeniem komercyjnym warto je przejrzeć. Na marginesie: jeśli zaczynasz od zera, nasz hub o lokalnym AI zbiera sprzętowe minimalia i początki od prostszych modeli, bo Gemma 4 26B nie jest najlżejszym pierwszym wyborem, mimo że uruchomienie jej lokalnie jest już przystępne.
Najczęstsze pytania
gemma 4 lokalnie: czy ten model da się odpalić na własnym komputerze?
Tak. Wagi safetensors i buildy GGUF są na Hugging Face od 23 października 2026, a przy 4-bitowej kwantyzacji model potrzebuje około 15-17 GB pamięci, więc mieści się na kartach 24 GB i na styk na 16 GB. To szacunek z arytmetyki parametrów, nie pomiar; deklarowane środowisko serwera to vLLM, lokalnie sprawdzą się llama.cpp albo LM Studio.
gemma lokalnie: czym to się różni od wersji Google?
ThinkingCap bazuje na tej samej Gemmie 4 26B-A4B-it, tylko przetrenowanej tak, by pisała krótsze łańcuchy myśli: średnio o 38,9 procent mniej tokenów rozumowania na dwunastu benchmarkach przy deklarowanym spadku dokładności o 0,15 punktu. Ustawienia próbkowania i stack serwujący pozostają bez zmian, więc podmiana w istniejącym wdrożeniu jest deklarowana jako drop-in.
jak uruchomić llm lokalnie od zera?
Potrzebujesz komputera z kartą o odpowiedniej pamięci, oprogramowania typu llama.cpp, LM Studio albo Ollama i pliku wagi w formacie GGUF dopasowanego do tej pamięci. Prostsze modele niż 26B działają nawet na 8 GB VRAM, a pełne minimum sprzętowe i ścieżki instalacji zbieramy w hubie o lokalnym AI.
Źródła
- BottleCap AI, ThinkingCap: Gemma-4-26B-A4B (publikacja 23.10.2026, odczyt 24.10.2026): https://bottlecapai.com/post/thinkingcap-gemma-4-26b/
- Hugging Face, metadane modelu ThinkingCap-gemma-4-26B-A4B-it (odczyt 24.10.2026): https://huggingface.co/bottlecapai/ThinkingCap-gemma-4-26B-A4B-it
- Hugging Face, metadane bazy google/gemma-4-26B-A4B-it (odczyt 24.10.2026): https://huggingface.co/google/gemma-4-26B-A4B-it
- Hacker News przez API Algolii, pełne drzewo dyskusji 50209907 (odczyt 24.10.2026): https://hn.algolia.com/api/v1/items/50209907