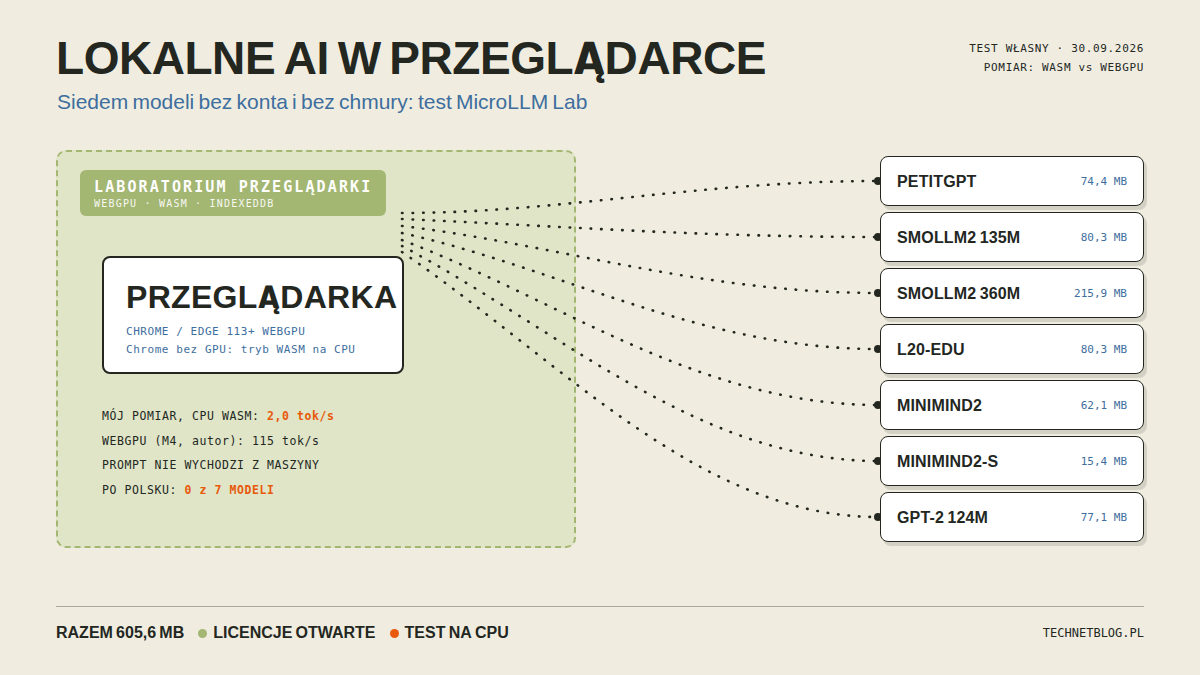
Pod koniec września na Hacker News pojawił się projekt MicroLLM Lab: jedna strona, na której siedem małych modeli językowych działa w całości w twojej przeglądarce. Bez konta, bez klucza API, bez instalacji. Klikasz Load, model ważący kilkadziesiąt megabajtów zapisuje się w pamięci przeglądarki i po chwili odpowiada na pytania, a prompt, przynajmniej według deklaracji autora, nie opuszcza twojego komputera. Sprawdziłem to na laptopie biurowym bez karty graficznej do AI. Działa, choć z wyraźnymi ograniczeniami, a największe jest takie, że te modele nie mówią po polsku.
Spis treści:
- Czym jest MicroLLM Lab
- Jak to działa
- Mój test: laptop bez GPU do AI
- Polski język: klapa
- Po co to komu
- Co zamiast tego do pracy po polsku
- Nota uczciwości
- Źródła
Czym jest MicroLLM Lab
MicroLLM Lab to stronka postawiona wokół otwartego repozytorium microllm-lab na GitHubie. Wątek na Hacker News z dwudziestego ósmego września zebrał w dobę 278 punktów i ponad sto komentarzy, w większości od ludzi testujących modele na własnym sprzęcie i dzielących się wynikami, często żenującymi dla modeli. Sama idea jest prosta: skoro przeglądarki mają dziś dostęp do karty graficznej przez WebGPU, drobny model językowy da się policzyć na miejscu, tak jak strona liczy animacje, czyli bez własnego serwera.
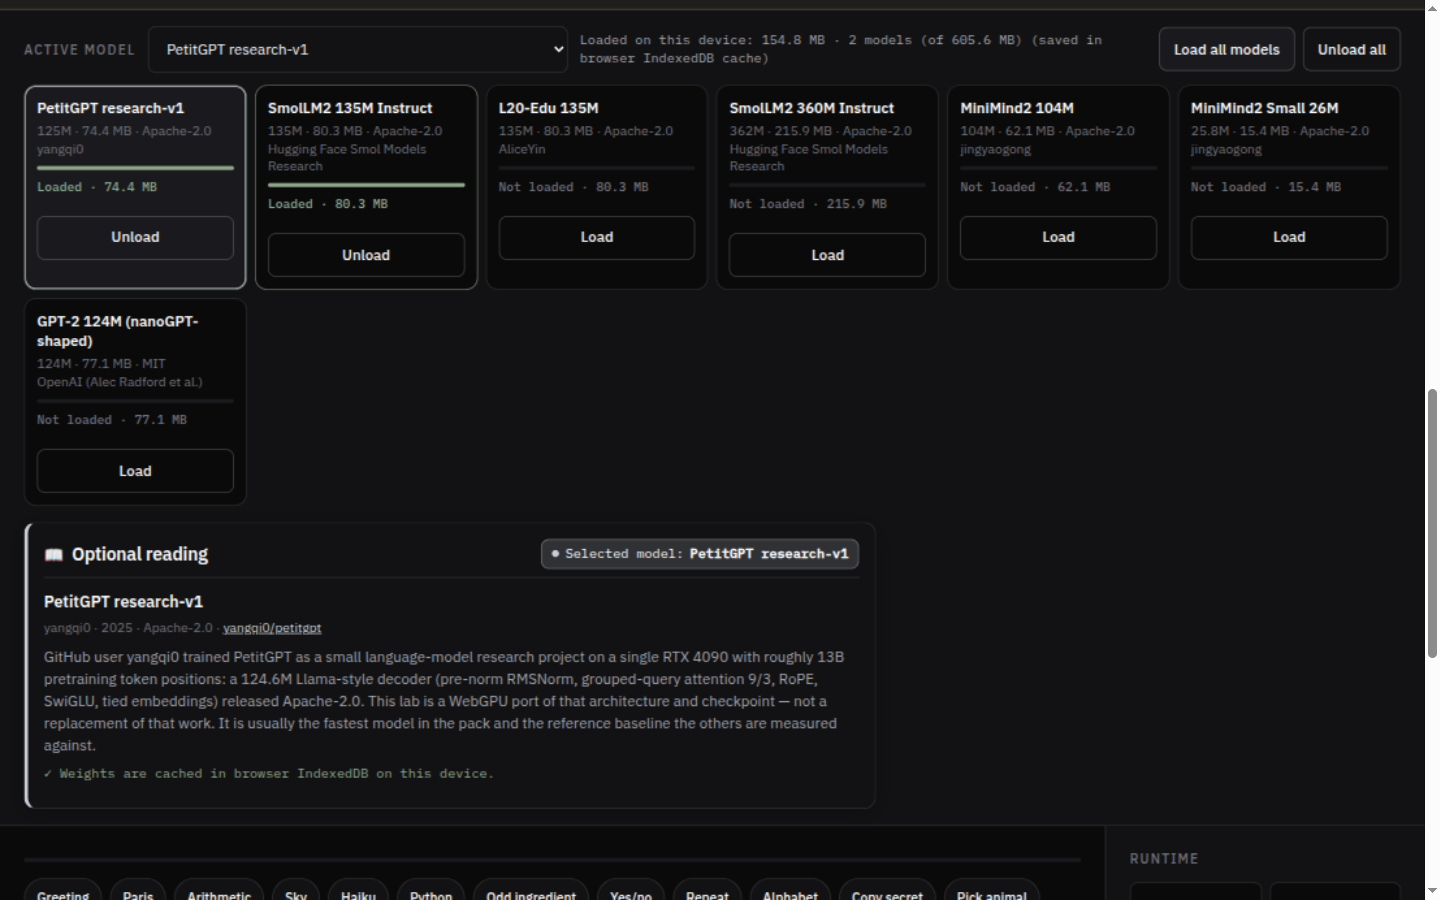
W zestawie siedem modeli, wszystkie na otwartych licencjach Apache-2.0 albo MIT. PetitGPT research-v1 to projekt jednej osoby, wytrenowany na pojedynczej karcie RTX 4090 na około trzynastu miliardach tokenów. SmolLM2 135M i 360M Instruct pochodzą z serii małych modeli Hugging Face, trenowanej na około dwóch bilionach tokenów. Dalej dwa edukacyjne MiniMind2 z Chin (26 i 104 miliony parametrów), L20-Edu wytrenowany na jednej karcie L20 oraz GPT-2 124M, czyli model z 2019 roku udostępniony przez OpenAI na licencji MIT. Cała siódemka zajmuje razem 605,6 MB, ale najmniejszy mieści się w 15,4 MB.
| Model | Parametry | Rozmiar w Q4 |
|---|---|---|
| PetitGPT research-v1 | 124,6 mln | 74,4 MB |
| SmolLM2 135M Instruct | 134,5 mln | 80,3 MB |
| SmolLM2 360M Instruct | 362 mln | 215,9 MB |
| L20-Edu 135M | 134,5 mln | 80,3 MB |
| MiniMind2 104M | 104 mln | 62,1 MB |
| MiniMind2 Small 26M | 25,8 mln | 15,4 MB |
| GPT-2 124M | 124 mln | 77,1 MB |
Jak to działa
Dwie technologie robią tu całą robotę i obie zdecydują, czy u ciebie to działa, czy nie. Pierwsza to WebGPU, standard W3C dający stronom dostęp do GPU. Działa w Chrome, Edge i Brave od wersji 113, natomiast w Firefoksie pod Linuksem wciąż bywa niedostępny, na co narzekał już pierwszy komentarz pod wątkiem. Druga to kwantyzacja Q4: zamiast zapisywać każdy parametr w szesnastu bitach, model pakuje się do czterech bitów na parametr i stumilionowy model waży około osiemdziesiąt megabajtów zamiast kilkuset. To ta sama rodzina trików, dzięki której lokalne modele w ogóle mieszczą się na laptopach.
Gdy WebGPU nie jest dostępny, strona nie odmawia działania, tylko przełącza się na tryb WASM liczony procesorem. To właśnie scenariusz, który zmierzyłem u siebie, bo mój sprzęt testowy nie ma osobnej karty graficznej. Raz pobrane wagi lądują w IndexedDB, wewnętrznej bazie przeglądarki, więc przy kolejnej wizycie model nie pobiera się drugi raz; po moich testach strona raportowała 154,8 MB w dwóch modelach zapisanych na urządzeniu.
Jedno zastrzeżenie dla ludzi myślących o prywatności. Obietnica, że prompt nie opuszcza maszyny, jest deklaracją autora, a ja nie przeprowadzałem pełnego audytu ruchu sieciowego strony. Kod publicznej strony może się zmienić przy dowolnej aktualizacji, więc naprawdę wrażliwe notatki wklejałbym wyłącznie do kopii postawionej lokalnie z repozytorium. Do zwykłych pytań testowych żywa strona nadaje się bez wahania.
Mój test: laptop bez GPU do AI
Testowy sprzęt to i7-10850H, 64 GB RAM i zintegrowana grafika Intel UHD, czyli przeciętny laptop biurowy, a nie stacja do uczenia maszynowego. W testowanej przeglądarce adapter WebGPU nie był dostępny, więc strona sama włączyła tryb WASM i uczciwie pokazała odpowiedni komunikat na początku.
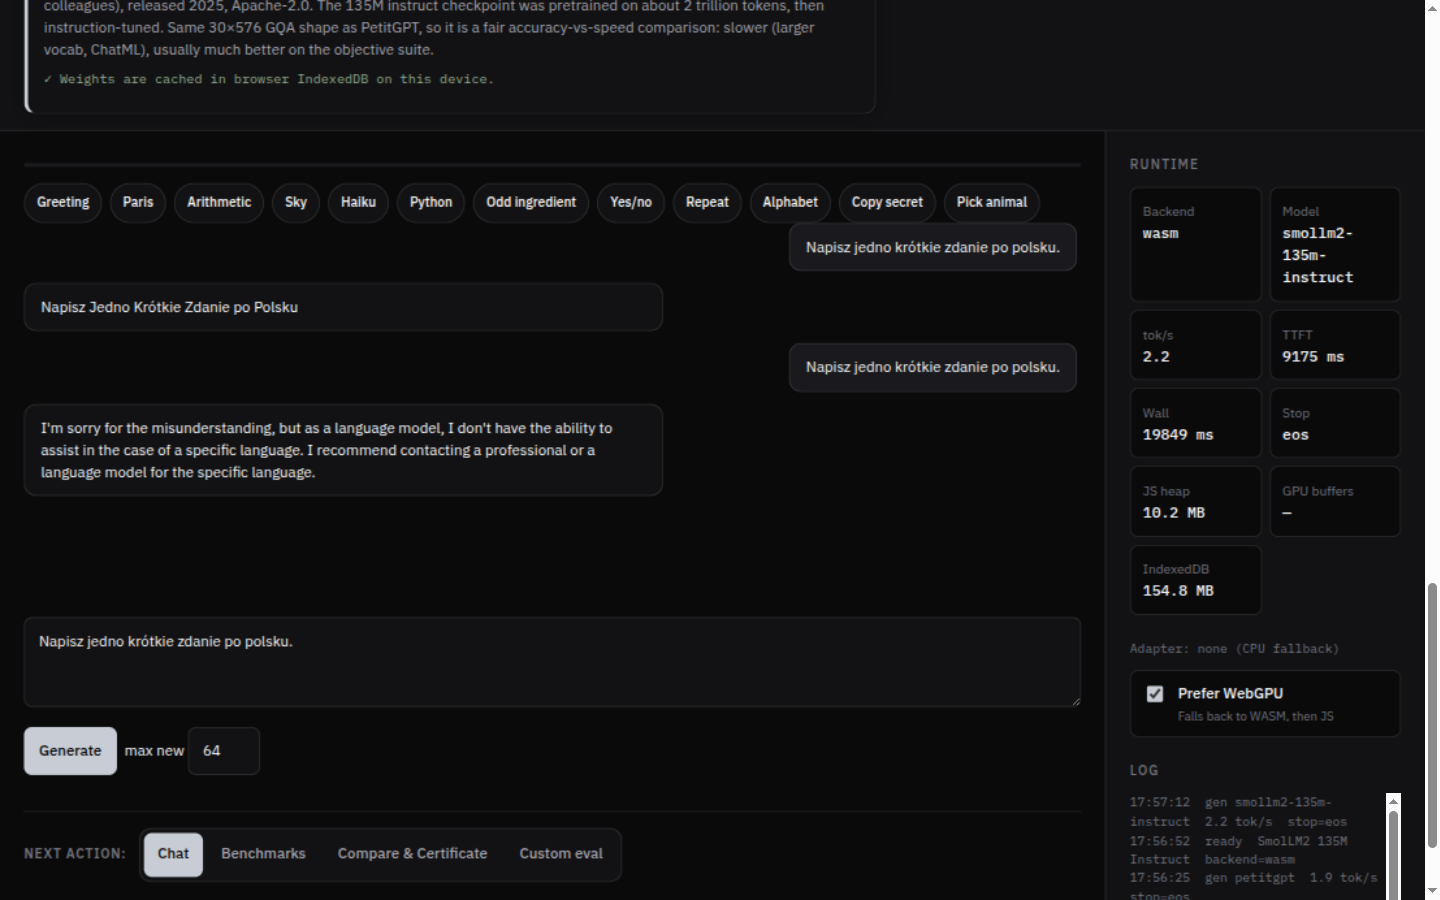
PetitGPT, 74,4 MB, pobrał się w kilka sekund przy około 13 MB/s. Prośba o krótkie przywitanie wróciła po chwili: „Hello! How can I help you today?”. W logu strony widniała prędkość 2,0 tokenu na sekundę, backend WASM. Dla porównania autor projektu podaje dla tego samego modelu 115 tok/s na Apple M4 z włączonym WebGPU, a strona obiecuje w trybie sprzętowym od 100 do ponad 300 tok/s. Różnica między GPU a CPU to tu nie kilkadziesiąt procent, tylko jeden albo dwa rzędy wielkości. Na moim sprzęcie odpowiedź pojawiała się w tempie wyraźnie wolniejszym niż czytanie.
Arytmetyka wypadła lepiej, niż spodziewałem się po lekturze komentarzy. Na pytanie „What is 2+2? Answer with just the number” PetitGPT odpowiedział: „2+2 is 2 + 2 = 4.”. Poprawnie, choć okrężnie, bo innym użytkownikom ten sam model odpowiadał „2+2 is 2″, a jeszcze innym wyprowadzał równanie kończące się błędem. Małe modele są po prostu loteryjne: ta sama waga pliku i ten sam prompt dają różne odpowiedzi w zależności od trybu dekodowania.
SmolLM2 135M Instruct, drugi model, który załadowałem, na oba angielskie pytania wypadł czysto: „Hello, I’m here to assist you in a variety of ways.” oraz po prostu „2 + 2 = 4″. Widać tu różnicę między checkpointem badawczym trenowanym na trzynastu miliardach tokenów a modelem instrukcyjnym z dwoma bilionami za sobą. Wbudowany pakiet testów, dwadzieścia jeden zadań, na Apple M4 wykonuje się w około sześć sekund; u mnie widoczny licznik zdążył pokazać test drugi z dwudziestu jeden, a po dziesięciu minutach pakiet wciąż się liczył. Na CPU fallback to materiał na przerwę, nie benchmark.
Polski język: klapa
Najciekawszy dla polskiego czytelnika okazał się test językowy. PetitGPT poproszony o napisanie jednego zdania po polsku o kocie odpowiedział: „Napisz Jedno Zdanie Po Polsku O Kocie is a city in Poland. It is located in the district of Olszow.” Model potraktował moje zdanie jak nazwę własną, dopowiedział do niej fikcyjne miasto i spokojnie kontynuował o jego zabytkach oraz turystyce. SmolLM2 był uprzejmie bezradny: „I’m sorry for the misunderstanding, but as a language model, I don’t have the ability to assist in the case of a specific language”, po czym poradził skontaktowanie się z profesjonalistą albo z modelem językowym. Rada kontaktu z modelem językowym, wygłoszona przez model językowy, to moje ulubione zdanie całego testu.
To prosta arytmetyka zbiorów treningowych, nie wada samego laboratorium. Modele tej wielkości trenuje się po angielsku, czasem z domieszką chińskiego, bo każdy kolejny język kosztuje tokeny, których przy stu trzydziestu pięciu milionach parametrów po prostu nie ma. Zanim więc klikniesz Load, wiedz, że żaden z tej siódemki nie napisze maila po polsku ani nie streści polskiego artykułu.
Po co to komu
Dla dewelopera rozważającego funkcję AI działającą na urządzeniu klienta to najtańszy możliwy poligon. Kilka minut w przeglądarce pokazuje na prawdziwym sprzęcie użytkowników, jak smakuje kompromis między jakością odpowiedzi a szybkością, i to bez konfigurowania czegokolwiek. Dla ciekawych to żywa lekcja budowy modeli językowych: widać pobieranie wag, cache w przeglądarce, licznik tokenów na sekundę, wyniki testów i porównania między modelami, wszystko po stronie klienta.
W README projektu jest zdanie, które uczciwie podsumowuje całe przedsięwzięcie: „Cloud models are better. That is not the point.”, czyli modele chmurowe są lepsze i nie o to chodzi. Autor nie udaje, że 135 milionów parametrów dorówna GPT-6 czy Claude. Kierunek zarysowuje się sam: w wątku Hacker News pojawiła się już propozycja Web Models API, interfejsu, którym przeglądarka sama udostępniałaby modele stronom. Dzisiejsze eksperymenty to rozgrzewka przed tą erą.
Co zamiast tego do pracy po polsku
Jeśli chcesz realnie pracować lokalnie i po polsku, MicroLLM Lab nie jest tym narzędziem. Celuj w pełnowymiarowe modele open weights uruchamiane na własnym komputerze przez narzędzia typu Ollama, które opisywałem szerzej w wpisie o DeepSeek po polsku, albo po prostu w chmurę. Przegląd większych narzędzi AI z cenami trzymam na stronie narzędzia AI. A jeśli motywem jest prywatność, a nie polszczyzna, piszę szerzej o tym, co ChatGPT wie o tobie dzięki ciasteczku __obi.
Nota uczciwości
Test wykonałem 30 września 2026 na laptopie z i7-10850H i zintegrowaną grafiką Intel UHD, w przeglądarce bez aktywnego adaptera WebGPU, czyli na backendzie WASM. Prędkości dla trybu WebGPU pochodzą z deklaracji autora projektu, mierzonych na Apple M4, a nie z mojego pomiaru. Odpowiedzi modeli cytuję jednorazowo z własnej sesji testowej; małe modele bywają loteryjne i powtórzenie tego samego pytania może dać inny wynik. Deklarację prywatności cytuję za autorem, bez audytu ruchu sieciowego.
Źródła
- MicroLLM Lab, strona projektu, stan 30 września 2026
- Repozytorium robss2020/microllm-lab, GitHub, README z listą modeli i pomiarami na Apple M4
- Wątek „MicroLLM Lab – Try 7 tiny LLM’s in the browser”, Hacker News, 28 września 2026, 278 punktów
- Repozytorium yangqi0/petitgpt, GitHub, trening PetitGPT
- HuggingFaceTB/SmolLM2-135M-Instruct, karta modelu, Hugging Face