LLM to skrót od angielskiego large language model, po polsku duży model językowy. To program, który uczy się języka na takiej ilości tekstu, że potrafi sam układać zdania, których nikt przed nim w tej kolejności nie napisał: odpowiada na pytania, tłumaczy, pisze kod, streszcza dokumenty, prowadzi rozmowę. Skrót wylądował w pytaniach, które ludzie wpisują w Google, a odpowiedzi w sieci rozjeżdżają się od marketingowych landingów po wykłady z matematyki. Rozbieram go tu na części bez jednego wzoru, za to z datami, liczbami i cenami, bo na tym polega różnica między zrozumieniem a powtarzaniem skrótowca. Ten tekst jest częścią naszego przewodnika dla początkujących, całość trzyma strona Podstawy AI: 30 pytań i odpowiedzi.
- Najważniejsze informacje
- Jak działa LLM, jeśli odjąć matematykę
- Czym LLM różni się od AI i od ChatGPT
- Krótka historia: od transformerów do 900 milionów ludzi
- Co LLM potrafi, a gdzie są granice
- LLM po polsku: jakość, ceny i rodzimy Bielik
- llms.txt: gdy robot LLM wchodzi na twoją stronę
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Rozwinięcie skrótu | Large language model, duży model językowy; program uczący się języka z ogromnej ilości tekstu |
| Jak działa | Przewiduje kolejny fragment tekstu (token), jeden po drugim, na podstawie wszystkiego, co przeczytał przedtem |
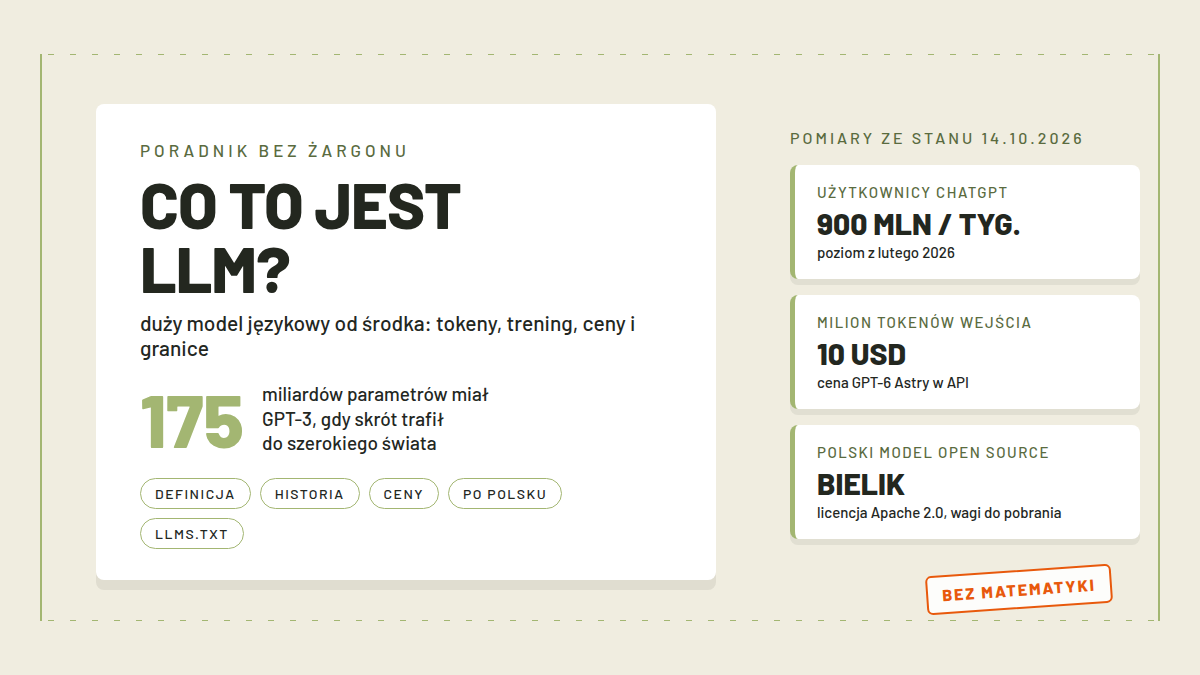
| Skąd „duży” | GPT-3 z 2020 roku miał 175 mld parametrów, Kimi K3 około 2,8 bln; najnowszych modeli firmy już nie liczą publicznie |
| Przykłady LLM | GPT-6 w ChatGPT, Claude, Gemini, Grok, DeepSeek, polski Bielik |
| Daty przełomowe | Transformer 2017 (Google), ChatGPT 30 listopada 2022 |
| Po polsku | Duże modele piszą i rozmawiają po polsku; Bielik to polski model open source na licencji Apache 2.0 |
| Koszt | Czaty z dużym modelem od 0 zł; API rozliczane w tokenach, np. milion tokenów wejścia GPT-6 Astry to 10 USD |
Jak działa LLM, jeśli odjąć matematykę
Model dostaje tekst i pyta sam siebie: co będzie dalej. Po polskim „Dzień dobry, nazywam” niemal na pewno przyjdzie „się”, po „stolicą Polski jest” wybór spada do jednego słowa. LLM robi ten sam ruch, tylko na ogromną skalę: patrzy na wszystko, co dostał, i wylicza rozkład prawdopodobieństwa na następny fragment tekstu. Taki fragment to token, zwykle kawałek słowa wielkości kilku znaków. Wylosowanego tokena dokleja do zdania i powtarza procedurę, więc długa odpowiedź w czacie to setki takich kroków wykonanych w ułamku sekundy.
Skąd model wie, co jest prawdopodobne? Z treningu. Pokazuje się mu miliardy zdań z zakrytym następnym słowem i każe zgadywać; przy błędzie poprawia się wewnętrzne pokrętła, zwane parametrami albo wagami, i leci dalej. Po milionach takich rund model wchłania gramatykę, style, fakty, a nawet dowcipy, nie dlatego, że je rozumie, tylko dlatego, że widział ich mnóstwo. Skala tych pokręteł dała nazwę całej rodzinie: GPT-3 z 2020 roku miał ich 175 mld, dziesięć razy więcej niż jakikolwiek wcześniejszy gęsty model, jak podsumowali autorzy w publikacji na arXiv. Dziś otwarte modele typu DeepSeek R1 liczą 671 mld parametrów, a Kimi K3 około 2,8 bln; liczb dla najnowszych modeli zamkniętych, na czele z GPT-6 i Claude, producenci już nie publikują.
Sam trening na tekście nie wystarczyłby do czatu. Surowy GPT-3 kontynuował dowolny tekst: dostawszy pytanie, potrafił odpowiedzieć kolejnym pytaniem, bo i takie sekwencje widział. Dlatego dochodzi drugi etap, dostrajanie: model uczy się na przykładach trzymać roli asystenta, a potem ludzie oceniają pary odpowiedzi i model dostaje nagrodę za te wybrane. To stąd czat przeprasza, dopytuje i odmawia niektórych tematów; grzeczność jest wytrenowana, nie wbudowana.
W tym mechanizmie siedzi też temperatura, parametr, o który pytają nawet ci, którzy nie programują. To suwak losowości: przy niskiej wartości model konsekwentnie wybiera najbardziej prawdopodobne tokeny, więc odpowiada przewidywalnie i pasuje do danych oraz kodu; przy wysokiej dopuszcza wybory z ogona rozkładu, więc tekst robi się kreatywniejszy i mniej wiarygodny zarazem. W aplikacjach konsumenckich ten suwak jest schowany, ale w API i ustawieniach zaawansowanych się pojawia. Cena też liczy się w tokenach: milion tokenów wejścia w GPT-6 Astrze kosztuje 10 USD według cennika OpenAI, który przywołujemy w tekście o Astrze; na skalę jednej rozmowy wychodzą ułamki grosza, na miliony zapytań w firmie robią się z tego pieniądze.
Czym LLM różni się od AI i od ChatGPT
Skrót LLM bywa mylony z całą sztuczną inteligencją, a to tylko jej językowa część. Sztuczna inteligencja to pojęcie nadrzędne obejmujące wszystko od systemów rekomendacji sklepów przez rozpoznawanie twarzy po silniki grające w szachy; LLM zajmuje się wyłącznie językiem, czyli pisaniem i rozumieniem tekstu. Wszystko, co ostatnio zgotował światu czat AI, wyczerpuje się w tym jednym podzbiorze, co samo w sobie mówi coś o sile języka.
Z ChatGPT jest druga historyjka. ChatGPT to nie LLM, tylko produkt zbudowany na LLM: interfejs czatu, aplikacje, subskrypcje i pamięć rozmów, a pod spodem pracują modele rodziny GPT. Analogia z autem jest banalna, ale działa: GPT-6 jest silnikiem, ChatGPT samochodem z tym silnikiem, a ten sam silnik można wstawić do API, czatu w innej aplikacji albo agenta. Claude to produkt Anthropic na modelach Claude, Gemini to model Google dostępny przez własną aplikację i API. Kiedy dziennikarz pisze „ChatGPT nauczyło się…”, technicznie opisuje model, ale wszystkich to rozumie, i nie ma w tym dramatu.
Krótka historia: od transformerów do 900 milionów ludzi
Rok 2017: badacze Google publikują na konferencji NeurIPS architekturę transformer, mechanizm, który potrafi czytać cały tekst naraz i ważyć, które fragmenty są ważne dla siebie nawzajem. To ta praca wywindowała jakość przewidywania kolejnego słowa na poziom, który nagle zrobił się użyteczny. Potem poszło lawinowo: GPT-2 z 1,5 mld parametrów (skrót GPT rozwija się jako Generative Pre-trained Transformer, czyli generatywny pretrenowany transformer, więc nazwa wprost wskazuje na architekturę z 2017 roku), w 2020 GPT-3 ze wspomnianymi 175 mld, a 30 listopada 2022 OpenAI wystawia publiczny czat na bazie dopracowanego modelu. ChatGPT zdobył 100 mln użytkowników w dwa miesiące, a w lutym 2026 osiągnął 900 mln użytkowników tygodniowo, jak zapisano w hasłach Wikipedii o tym produkcie.
Ten wzrost złapał też nasz rynek. Dziś na polskich telefonach siedzą czaty na GPT-6, Claude i Gemini 4, o których piszemy osobno: opinie i benchmarki GPT-6 Astry oraz start Gemini 4 Argon. Z perspektywy początkującego ważniejsze jest co innego: w ciągu czterech lat LLM z publikacji naukowej stał się infrastrukturą codzienną, jak wyszukiwarka.
Co LLM potrafi, a gdzie są granice
Lista umiejętności jest długa: pisanie i przerabianie tekstów, tłumaczenia, streszczanie, kod, klasyfikacja dokumentów, rozmowa z klientem. Granice są równie konkretne. Po pierwsze, wiedza modelu kończy się na dacie cięcia treningu; świeże wydarzenia zna tylko wtedy, gdy dostanie je w oknie kontekstu albo podpięte wyszukiwanie. Po drugie, model halucynuje: skoro jego jedynym zadaniem jest przewidzieć prawdopodobny token, to gdy zabraknie danych, wygeneruje coś płynnego i brzmiącego wiarygodnie, choć zmyślonego. Niezależne indeksy mierzą to w liczbach, na przykład Artificial Analysis odnotował spadek halucynacji GPT-6 Astry z 92 do 51 procent przy maksymalnym wysiłku rozumowania, o czym piszemy w analizie Astry.
Trzecia granica to okno kontekstu: model „widzi” tylko tyle tekstu, ile mieści się w jego oknie, a wszystko, co wypadło, przepada. Dluga rozmowa w czacie po jakimś czasie traci początek, choć aplikacja może go podsyłać w skrócie. Czwarta granica jest bardziej filozoficzna: dopasowywanie wzorców to nie rozumienie w ludzkim sensie, choć granica bywa zaskakująco cienka. Zapisaliśmy to wszystko w Podstawach AI, tam też znajdziesz pytania o pamięć czatu i o to, czym różni się kontekst od treningu.
No i same dane, na których modele trenowano. Korpusy sięgają milionów książek i stron, więc pytanie, czyje teksty i na jakiej podstawie prawnej trafiły do treningu, trafiło do sądów; prowadzimy na bieżąco kronikę procesu wydawców z OpenAI o bibliotekę LibGen, bo rozstrzygnięcie ustali zasady dla całej branży.
LLM po polsku: jakość, ceny i rodzimy Bielik
Po polsku duże modele radzą sobie dobrze: rozumieją odmianę, piszą poprawne teksty, a ChatGPT ma pełny interfejs w naszym języku, co opisaliśmy w rozbiórce chatgpt po polsku. Korzystanie od zera kosztuje zero zł, bo darmowe plany czatów na dużych modelach są standardem; płacisz dopiero za wyższe limity i nowsze modele. Wybór narzędzi przeglądasz w naszym katalogu AI i hubie o ChatGPT.
Jest też model wytrenowany u nas. Bielik to społecznościowy projekt non-profit fundacji SpeakLeash we współpracy m.in. z Cyfronetem, trenowany przede wszystkim na polskich zbiorach tekstów i dziedzictwie kulturowym, na otwartej licencji Apache 2.0 z możliwością użycia komercyjnego. Wagi można pobrać (strona projektu mówi o ponad 4,7 mln pobrań), z modelami rodziny Bielik, włącznie z zaprezentowanym na konferencji NVIDIA GTC Bielikiem Minitron 7B, porozmawiasz w czacie chat.bielik.ai, który obsłużył już ponad 100 tys. użytkowników. Model sprawdzisz w praktyce też u siebie na komputerze, o czym piszemy w przewodniku o lokalnym AI. Na pytanie „jaki jest najlepszy LLM po polsku” nie ma jednej odpowiedzi: do codziennych zadań czaty dużych firm, gdy liczy się prywatność i trzymanie danych u siebie, otwarte modele typu Bielik.
llms.txt: gdy robot LLM wchodzi na twoją stronę
Skoro mowa o stronach: skrót LLM zrobił się tak popularny, że zaczepił nawet w plikach serwisów internetowych. We wrześniu 2024 Jeremy Howard zaproponował standard llms.txt: plik w formacie markdown, kładziony w katalogu głównym serwisu, który ma robotom LLM podać w pigułce, czym jest strona i gdzie znaleźć jej treści. Struktura jest prosta: nagłówek H1 z nazwą projektu, krótki opis, potem sekcje H2 z listami linków do dokumentacji. Wersja druga specyfikacji, opublikowana 10 sierpnia 2026, dodaje pomysł serwowania wersji markdown samych stron.
Cele są inne niż przy robots.txt, co strona standardu podkreśla wprost: robots.txt mówi automatom, co wolno, a llms.txt po prostu daje treści do wykorzystania na żądanie, gdy asystent AI szuka informacji dla człowieka. Standard nie jest treningowy, służy wnioskowaniu. Ma sens głównie dla serwisów z dokumentacją, sklepów i dużych serwisów treściowych; dla małego bloga to na razie ciekawostka, choć skrót „llms txt” już wyświetla się w podpowiedziach Google.
Najczęstsze pytania
Czy ChatGPT to LLM?
ChatGPT to produkt (czat, aplikacja, subskrypcje) zbudowany na modelach LLM rodziny GPT. Sam model, np. GPT-6, to LLM; ChatGPT to opakowanie, przez które z nim rozmawiasz.
Co to jest LLM w prawie?
To inny skrót: Legum Magister, stopień magistra prawa z uniwersytetów anglosaskich. Zbieżność skrótowców bywa myląca w wynikach wyszukiwania, ale prawniczy LLM nie ma nic wspólnego z modelami językowymi.
Czym LLM różni się od LMS?
LMS to Learning Management System, platforma do e-learningu typu Moodle, czyli oprogramowanie do kursów i szkoleń. Modeli językowych nie dotyczy, mimo podobnego skrótu.
Do czego służy parametr temperatury w LLM?
Temperatura steruje losowością wyboru następnego tokena. Niska daje przewidywalne, powtarzalne odpowiedzi (dane, kod), wysoka pobudza kreatywność kosztem precyzji. W aplikacjach konsumenckich jest ustawiana automatycznie.
Co to jest plik llms.txt?
Plik markdown w katalogu głównym serwisu, zaproponowany we wrześniu 2024 jako standard podawania treści robotom LLM: nazwa, krótki opis i linki do dokumentacji. Służy asystentom AI do znajdowania informacji na żądanie, a nie do treningu.
Źródła
- Large language model, Wikipedia (EN): https://en.wikipedia.org/wiki/Large_language_model
- ChatGPT, Wikipedia (EN): https://en.wikipedia.org/wiki/ChatGPT
- Language Models are Few-Shot Learners (GPT-3, 175 mld parametrów), OpenAI, arXiv, maj 2020: https://arxiv.org/abs/2005.14165
- llms.txt, propozycja standardu, Jeremy Howard, wrzesień 2024, v2 sierpień 2026: https://llmstxt.org/
- Bielik, polskie modele językowe, strona projektu: https://bielik.ai/