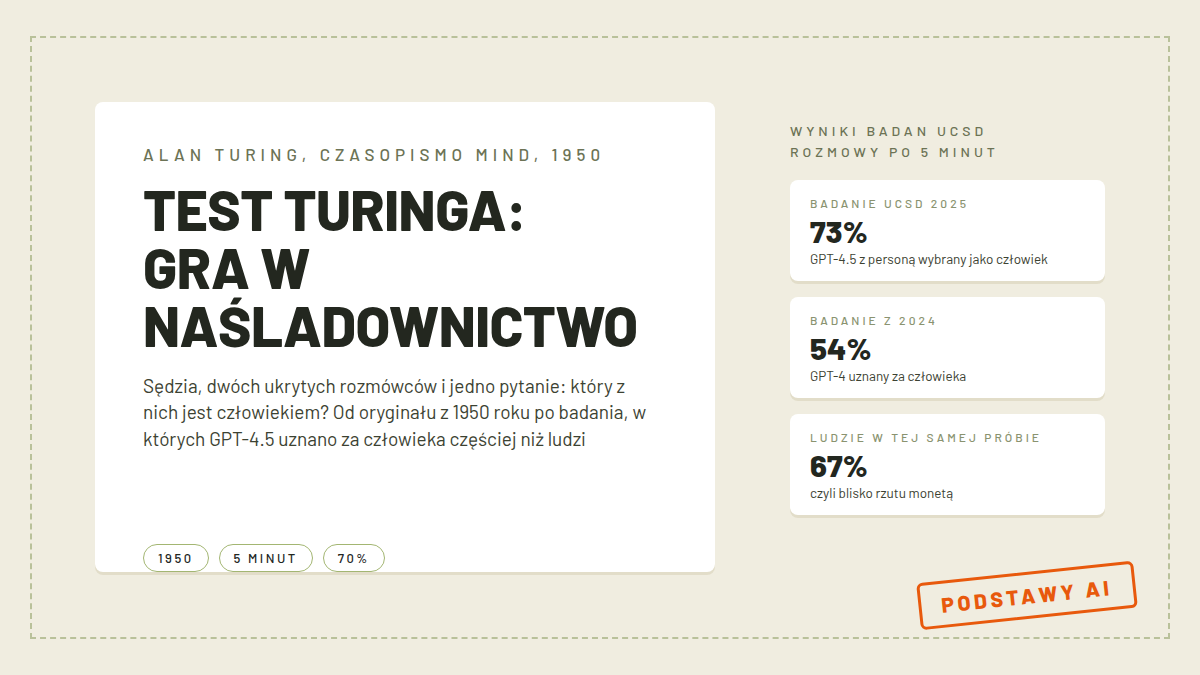
Pytanie „czy maszyny myślą” brzmi jak zaproszenie do dyskusji przy piwie, a nie jak zadanie dla inżyniera. Alan Turing zdawał sobie z tego sprawę i w październiku 1950 roku na łamach czasopisma filozoficznego Mind opublikował tekst „Computing Machinery and Intelligence”, w którym zamiast szukać definicji myślenia zaproponował coś prostszego: grę. Jeśli maszyna prowadzi pisemną rozmowę tak, że człowiek nie potrafi odróżnić jej od drugiego człowieka, pytanie o myślenie traci swoją paraliżującą siłę. Ten pomysł, dziś znany jako test Turinga, został najczęściej przywoływanym sprawdzianem inteligencji maszyn, choć część badaczy uważa go za przestarzały.
W tym tekście pokażę, skąd test się wziął i co Turing faktycznie napisał, bo oryginał bywa mylony z tym, co się o nim powtarza. Rozpiszę przebieg gry w naśladownictwo krok po kroku, razem z różnicami między wersjami, które sam Turing proponował. Potem wejdą warianty, od totalnego testu Turinga po nagrodę Loebnera, i współczesność: czy ChatGPT oraz podobne modele przechodzą ten test. Na koniec odpowiem, po co test dziś komukolwiek służy. Dla pełniejszego tła przyda się nasz słownik Podstaw AI oraz tekst Czy AI myśli.
- Najważniejsze informacje
- Alan Turing i rok 1950
- Jak przebiega gra w naśladownictwo
- Warianty i nieporozumienia
- Czy dzisiejsze czatboty przechodzą test Turinga
- Po co ten test dziś
- FAQ
Najważniejsze informacje
| Co | Stan na odczyt 17.10 |
|---|---|
| Autor i rok | Alan Turing, tekst „Computing Machinery and Intelligence” w czasopiśmie Mind (t. LIX, nr 236), październik 1950 |
| Pierwotna nazwa | gra w naśladownictwo (ang. imitation game) |
| Zamiast pytania „czy maszyny myślą” | sprawdzian operacyjny: czy sędzia odróżni maszynę od człowieka w pisemnej rozmowie |
| Jak przebiega | sędzia pisze równocześnie z dwiema ukrytymi stronami, człowiekiem i maszyną, a po rozmowie wskazuje, która jest którą |
| Czas rozmowy | 5 minut przesłuchania w prognozie Turinga; regulaminy konkursów podawały od 5 do 25 minut |
| Prognoza Turinga | około roku 2000 przeciętny sędzia po 5 minutach rozmowy będzie miał nie więcej niż 70% szans na trafne rozpoznanie |
| Warianty | total Turing test (Stevan Harnad), konkursy o nagrodę Loebnera (pierwsza edycja 1991, ostatnia 2019) |
| Status dziś | w badaniu UCSD z 2025 roku GPT-4.5 z podpowiedzią persony uznano za człowieka w 73% rozmów; spór o to, co test mierzy, trwa |
Alan Turing i rok 1950
Turing nie był filozofem z zawodu, choć jego tekst z 1950 roku wszedł do kanonu filozofii umysłu. Zaczynał się zdaniem, które dziś zna każdy, kto miał styczność z tematem: „I propose to consider the question, 'Can machines think?’”, czyli proponuję rozważyć pytanie, czy maszyny myślą. Turing od razu podkopał własne pytanie: definicje słów „maszyna” i „myślenie” są na tyle płynne, że w tym brzmieniu można je najwyżej ankietować, a prawdy naukowej nie ustala się sondażem. Zamiast definicji proponuje grę, a zamiast pytania o myślenie pytanie o zachowanie, które da się policzyć.
Ta zamiana, dziś powiedzielibyśmy operacjonalizacja, była najmądrzejszym ruchem w historii tej dziedziny: test nie każe zajrzeć maszyny do środka i szukać iskry rozumu, każe postawić ją w sytuacji, w której liczy się tylko to, co potrafi napisać. Zarazem Turing złożył prognozę: „Wierzę, że za około pięćdziesiąt lat będzie można zaprogramować komputery o pamięci rzędu miliarda bitów tak, aby grały w grę w naśladownictwo na tyle dobrze, że przeciętny przesłuchujący po pięciu minutach zadawania pytań nie miałby więcej niż 70 procent szans na trafne rozpoznanie”. Uważał też, że pod koniec wieku ludzie będą mówić o myślących maszynach bez ryzyka skorygowania. Miliard bitów, o którym pisze, to dzisiejszy zapas pamięci z jednego zdjęcia z telefonu. Na koniec jedna rzecz: ta prognoza nie mówiła, że maszyny przechodzą test w 70 procent przypadków. Siedemdziesiąt procent to szansa sędziego na trafną odpowiedź, więc maszyna miała oszukiwać w trzech przypadkach na dziesięć, a to rozróżnienie gubi się w opracowaniach po dzień dzisiejszy.
Jak przebiega gra w naśladownictwo
W oryginale z 1950 roku gra jest trójstronna: biorą w niej udział mężczyzna (A), kobieta (B) i sędzia (C), który może być obu płci. Sędzia siedzi w osobnym pokoju, rozmawia wyłącznie na piśmie, w idealnej wersji przez dalekopis, bo ton głosu by zdradził odpowiedzi. Jego zadaniem jest rozpoznanie, kto jest kim. Mężczyzna skłania go do błędnej decyzji, kobieta pomaga mu trafić, na przykład zdaniem „jestem kobietą, nie słuchaj go”.
Dopiero potem wchodzi maszyna: co stanie się, gdy zajmie miejsce A? Czy sędzia pomyli się tak często, jak przy grze między mężczyzną i kobietą? To pytanie, pisze wprost, zastępuje pierwotne „czy maszyny myślą”. Artykuł pokazuje od razu, jakiej trudnej sztuki wymaga: sędzia każe dodać 34957 do 70764 i po trzydziestosekundowej pauzie dostaje wynik 105621, który jest zły. Maszyna udająca człowieka ma symulować ludzką powolność i potknięcia, a nie imponować rachunkiem.
Z limitem pięciu minut jest ciekawie, bo sprawdziłem oryginał i w opisie samej gry nie ma żadnego zegara. Pięć minut pojawia się dopiero w prognozie („after five minutes of questioning”), a Polska Wikipedia pisze wprost o pięciominutowej rozmowie, co jest uproszczeniem, choć niewinnym: limity faktycznie ustaliły dopiero konkursy, a regulaminy nagrody Loebnera wahały się od 5 minut na stronę do 25 minut rozmowy równoczesnej. Encyklopedia Stanforda przypomina, że procent trafień, długość rozmowy i liczba wymian to parametry regulowane, utrwalone dopiero w konkretnej prognozie.
No i kwestia, o której popularne streszczenia milczą: Turing opisywał grę różnie. Obok wariantu z podmianą płci podaje w tym samym artykule „równoważny” układ, w którym sędzia rozmawia tylko z człowiekiem i maszyną, a w radiowej dyskusji BBC z 1952 roku przedstawia wersję z ławą przesłuchujących. Susan Sterrett dowodzi, że to dwa różne sprawdziany: oryginalna gra w naśladownictwo i standardowy test Turinga. Encyklopedia Stanforda opisuje grę od razu w tej uproszczonej wersji. Po polsku spotkasz obie formy nazwy; tu trzymam się „gra w naśladowanie”, bo jest częstsza w wyszukiwarkach.
Warianty i nieporozumienia
Najgłośniejszy wariant to total Turing test, zaproponowany przez kognitywistę Stevana Harnada. W tej wersji rozmowa nie wystarczy: maszyna ma dodatkowo widzieć, słyszeć i działać w świecie, bo liczy się pełna niemożność odróżnienia, także w ruchu. Paul Schweizer poszedł w 1998 roku jeszcze dalej i opisał truly total Turing test, wymagający w zasadzie pełnego odpowiednika ciała i biografii. Są to warianty spekulatywne, nikt ich nie przeprowadził, ale pokazują kierunek sporu: im więcej wymagamy, tym mniej zostaje z czegoś, co da się zmierzyć.
Drugim wariantem był konkurs. Nagroda Loebnera, ufundowana przez Hugh Loebnera we współpracy z Cambridge Center for Behavioral Studies (konkurs uruchomiono w 1990 roku, pierwsza edycja odbyła się w 1991), to pierwszy turniej testu Turinga w historii. Zasady zmieniały się co chwilę: najpierw rozmowy na jeden narzucony temat, od 1995 roku swobodne, a limity czasu od 5 do 25 minut równoczesnej rozmowy. Marvin Minsky nazwał go akcją reklamową i żartem ofiarował nagrodę każdemu, kto go zlikwiduje. Od 2014 roku organizowało je towarzystwo AISB w Bletchley Park, ostatnia edycja odbyła się w Swansea we wrześniu 2019, już bez panelu sędziów i bez ukrytego człowieka do porównania, a w 2020 BBC pisało o konkursie jako o zamkniętym. Główne nagrody, 25 i 100 tysięcy dolarów (za maszynę nieodróżnialną od człowieka w wersji pisemnej i w wersji z odbiorem tekstu, obrazu i dźwięku), nigdy nie zostały wypłacone.
Konkurs obfitował w „przejścia”, które potem się sypiały. Najgłośniejszy przypadek to Eugene Goostman, czatbot stworzony przez trzech programistów już w 2001 roku. Dostał personę trzynastolatka z Odessy, który mówił po angielsku jak w drugim języku; to tło wymyślono celowo, żeby sędziowie wybaczały mu potknięcia. W 2014 roku przekonał około jednej trzeciej sędziów w jednorazowym konkursie, co ogłoszono jako pierwsze przejście testu, a Stanford Encyclopedia podkreśla, że próba była zbyt mała na jakiekolwiek twarde wnioski. Wspólny mianownik takich epizodów: persony, krótkie rozmowy i sędziowie, którzy nie wiedzieli, że muszą przesłuchiwać. Dobre chatboty zawsze potrafiły wywołać efekt Elizy, w którym człowiek dopisuje maszynie rozum, a dzisiejsze czatboty odziedziczyły ten problem w skali przemysłowej.
Czy dzisiejsze czatboty przechodzą test Turinga
Temat wraca co kilka miesięcy. W lipcu 2023 Celeste Biever pisała w Nature, że „ChatGPT złamał test Turinga”, w lutym 2024 badacze ze Stanforda ogłosili, że najnowszy model ChatGPT „przeszedł rygorystyczny test Turinga”, odbiegając od przeciętnego ludzkiego zachowania głównie nadmierną kooperatywnością, ale były to oceny, nie pomiary. Twardych danych dostarczyli dopiero Cameron Jones i Benjamin Bergen z Uniwersytetu Kalifornijskiego w San Diego.
Ich pierwsze badanie, z maja 2024, było randomizowane, kontrolowane i z prerejestracją: uczestnicy rozmawiali przez 5 minut z jedną ukrytą stroną, człowiekiem albo modelem, i oceniali, z kim gadali. GPT-4 uznano za człowieka w 54 procentach rozmów, ELIZA w 22, prawdziwych ludzi w 67, czyli rzut monetą, choć bliżej człowieka niż klasyki z lat 60. Drugie badanie, z marca 2025 (opublikowane potem w Proceedings of the National Academy of Sciences, o czym poinformował UCSD w maju 2026), przeniosło grę do formatu trójstronnego (sędzia, człowiek, maszyna) z blisko 500 osobami i rozmowami po 5 minutach, a w replikacji po 15. GPT-4.5 z podpowiedzią persony, czyli instrukcją grania konkretnej postaci z własnym stylem, uznano za człowieka w 73 procentach rozmów, istotnie częściej niż prawdziwego człowieka. LLaMa-3.1-405B z tą samą personą dostała 56 procent, statystycznie nie do odróżnienia od ludzi. Bez persony GPT-4.5 spadał do 36 procent, a GPT-4o i ELIZA kończyły na 21 i 23.
Czy to znaczy, że maszyny myślą? Nie i zgadzają się w tym niemal wszyscy, łącznie z autorami badania. Jones i Bergen pisali już w 2024, że o wyniku decydują czynniki stylistyczne i społeczno-emocjonalne, nie tradycyjnie rozumiana inteligencja. Bergen mówi wprost, że test dziś mierzy podobieństwo do człowieka w zachowaniu, nie moc umysłu, i że to nie jest ta inteligencja matematyczno-logiczna, którą Turing sobie wyobrażał. Gary Marcus od lat powtarza, że test pokazuje głównie, jak łatwo oszukać człowieka. Argument Searle’a z chińskiego pokoju (szerzej w tekście Czy AI myśli) podważa sens testu od strony filozoficznej: symulowanie rozumienia nie jest rozumieniem. Do tego dochodzi efekt konfederata: sędziowie regularnie biorą prawdziwych ludzi za maszyny. Najuczciwsze podsumowanie z tych źródeł: najnowsze modele przechodzą konkretne, kontrolowane wersje testu, ale przejście testu nigdy nie było certyfikatem myślenia.
Po co ten test dziś
Pierwszy powód jest smutny i praktyczny: test Turinga stał się miarą oszustwa. „Test Turinga to gra w kłamstwo dla modeli”, mówi Jones. Bergen przypomina, że istnieją ludzie, którzy chcą użyć botów, by przekonać cię do podania numeru ubezpieczenia społecznego, zagłosowania na ich partię albo kupienia produktu. Skoro GPT-4.5 z personą przechodzi jako człowiek w trzech czwartych pięciominutowych rozmów, to deepfake’i rozmów głosowych, boty na portalach i fałszywi „konsultanci” przestają być eksperymentem.
Drugi powód to odwrócony test: od dekad zamiast pytać, czy maszyna poda się za człowieka, sprawdzamy, czy człowiek nie jest maszyną. CAPTCHA to test Turinga na odwrót i jego pozycja słabnie, bo już w 2014 roku Google demonstrował system pokonujący te zadania z 99,8 procent skuteczności. Razem z LLM-ami problem wrócił z wielką siłą.
Trzeci powód to nauka o granicach testów behawioralnych. Zdaniem Bergena podobieństwo do człowieka i inteligencja to nie to samo, a społeczność testuje dziś konkretne zdolności zamiast jednej wielkiej gry: schematy Winograda na rozumienie języka, benchmarki matematyczne, kod. Rozmowa o maszynach, które „przechodzą wszystko”, przeniosła się zaś do kontekstu AGI, sztucznej inteligencji ogólnej (piszemy o tym osobno w Co to jest AGI). Sam Turing był tu ostrożniejszy od swoich spadkobierców: twierdził tylko, że przejście testu nie pozwala wykluczyć maszynowego myślenia, a nie że je dowodzi. Po 75 latach test Turinga nie odpowiada już na pytanie, czy maszyny myślą. Mierzy, jak blisko potrafią podejść. Ja po lekturze oryginału zostałem z jednym wrażeniem: najmocniejsza w tekście z 1950 roku nie jest procedura, tylko decyzja o zamianie pytania niewerifikowalnego na takie, przy którym da się stanąć z danymi.
FAQ
Co to jest test Turinga?
Test Turinga to sprawdzian zaproponowany przez Alana Turinga w 1950 roku. Zamiast pytać, czy maszyny myślą, test pyta, czy sędzia prowadzący pisemną rozmowę z ukrytym człowiekiem i ukrytą maszyną potrafi wskazać, która z nich jest która. Jeśli sędzia myli się tak często jak przy dwóch ludziach, maszyna uchodzi za przechodzącą test.
Na czym polega gra w naśladownictwo?
W oryginalnej wersji z 1950 roku biorą udział trzy osoby: mężczyzna, kobieta i sędzia w osobnym pokoju. Sędzia zadaje pytania na piśmie i zgaduje, kto jest kim, mężczyzna udaje kobietę, a kobieta pomaga mu trafić. W drugim kroku maszynie powierza się rolę mężczyzny i pyta, czy sędzia pomyli się tak samo często.
Kto wymyślił test Turinga i kiedy?
Test wymyślił Alan Turing, brytyjski matematyk i jeden z ojców informatyki. Opublikował go w październiku 1950 roku w artykule „Computing Machinery and Intelligence” w czasopiśmie Mind. Sam pomysł pochodził z popularnej zabawy towarzyskiej: zgadywania, kim jest ukryty rozmówca.
Czy ChatGPT przechodzi test Turinga?
W kontrolowanych badaniach z 2025 roku GPT-4.5, model z rodziny ChatGPT, został uznany za człowieka w 73 procentach trójstronnych rozmów, częściej niż prawdziwy człowiek w tej samej próbie, ale tylko wtedy, gdy dostał podpowiedź, jaką personę ma grać. Bez persony spadał do 36 procent. To nie jest certyfikat, bo próby były ograniczone czasowo i liczebnie, a autorzy sami piszą, że test mierzy podobieństwo do człowieka, nie myślenie.
Czy test Turinga jest dziś jeszcze aktualny?
Jako test na inteligencję: raczej nie, bo najnowsze modele potrafią go przechodzić, a jednocześnie mylą się w zadaniach, które człowiek uznałby za proste. Jako miara ryzyka oszustwa i punkt odniesienia dla badań: tak, bo od 2023 roku badania w duchu testu Turinga dostarczają twardych danych o tym, jak łatwo pomylić model z człowiekiem w pisemnej rozmowie. Filozoficzny spór o to, co wynik testu znaczą, trwa bez rozstrzygnięcia.
Źródła
- Alan Turing, „Computing Machinery and Intelligence”, Mind LIX (236), 1950, s. 433-460 (transkrypt PDF), odczyt 17.10.2026: https://www.csee.umbc.edu/courses/471/papers/turing.pdf
- Graham Oppy, David Dowe, „Turing Test”, Stanford Encyclopedia of Philosophy, odczyt 17.10.2026: https://plato.stanford.edu/entries/turing-test/
- „Test Turinga”, Wikipedia PL, odczyt 17.10.2026: https://pl.wikipedia.org/wiki/Test_Turinga
- „Turing test”, Wikipedia EN, odczyt 17.10.2026: https://en.wikipedia.org/wiki/Turing_test
- „Loebner Prize”, Wikipedia EN, odczyt 17.10.2026: https://en.wikipedia.org/wiki/Loebner_Prize
- Cameron R. Jones, Benjamin K. Bergen, „People cannot distinguish GPT-4 from a human in a Turing test”, arXiv 2405.08007, odczyt 17.10.2026: https://arxiv.org/abs/2405.08007
- Cameron R. Jones, Benjamin K. Bergen, „Large Language Models Pass the Turing Test”, arXiv 2503.23674, odczyt 17.10.2026: https://arxiv.org/abs/2503.23674
- UC San Diego Today, „AI Can Seem More Human Than Real Humans in a Classic Turing Test, Study Finds” (o publikacji w PNAS), odczyt 17.10.2026: https://today.ucsd.edu/story/ai-can-seem-more-human-than-real-humans-in-a-classic-turing-test-study-finds
- Popular Science, „ChatGPT passed the Turing Test. Now what?”, odczyt 17.10.2026: https://www.popsci.com/technology/chatgpt-turing-test/