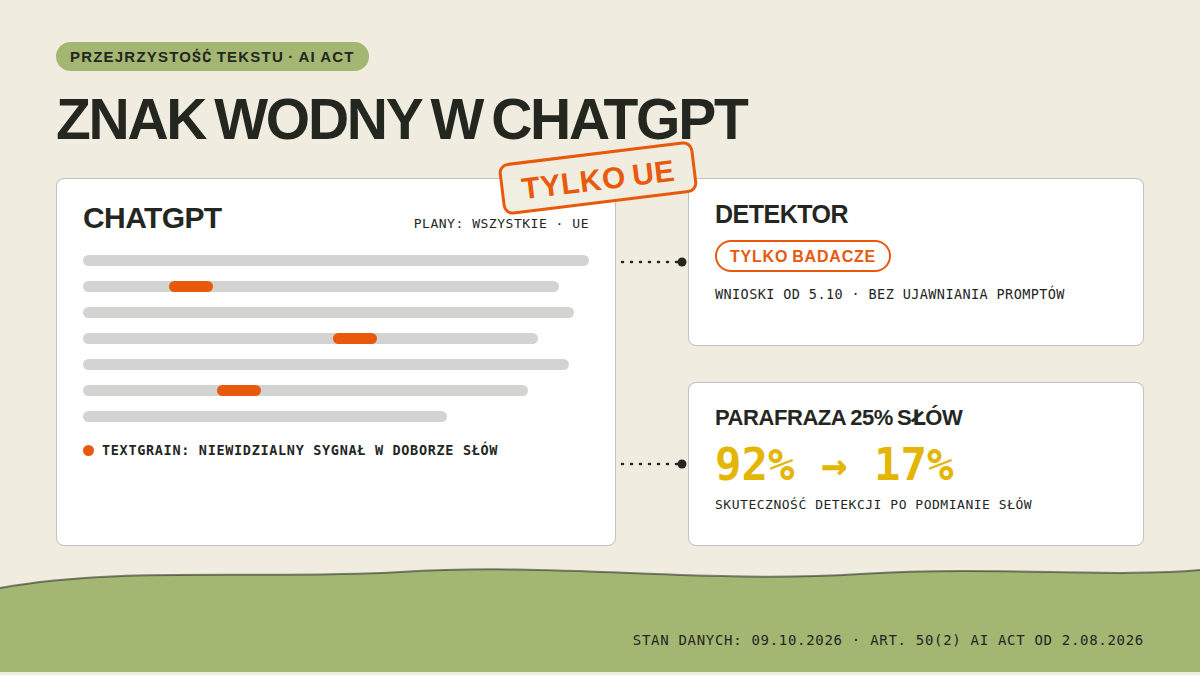
Piątego października OpenAI ogłosiła, co zrobi z wymogiem Unii Europejskiej o oznaczaniu tekstu generowanego przez sztuczną inteligencję, a w poniedziałek i wtorek temat obiegł serwisy technologiczne na całym świecie. Zdecydowano się na niewidzialny znak wodny o nazwie textGrain: statystyczny ślad ukryty w doborze słów, którego czytelnik nie zauważy, a wyspecjalizowany detektor tak. W ChatGPT i Codexie znak włączy się automatycznie, ale tylko dla użytkowników w UE, i to dopiero „w nadchodzących tygodniach”. Do detektora OpenAI wpuści na początek wyłącznie zatwierdzonych badaczy i organizacje eksperckie, więc przez jakiś czas nikt poza nimi nie sprawdzi, czy dany tekst ma znak.
Tekstu nie poprzemy własnym testem, bo detektor jest niedostępny publicznie i nawet gdyby był, testowanie na żywych kontach nie należy do naszego warsztatu. Opisujemy ogłoszenie OpenAI, raport techniczny textGrain i relacje Ars Technica, The Verge i Unite.AI, z linkiem przy każdym twierdzeniu. Liczby detekcji pochodzą z testów OpenAI, nie z naszych pomiarów.
Spis treści:
- Co OpenAI ogłosiła i dlaczego właśnie w UE
- Jak działa textGrain
- Gdzie detekcja zawodzi
- Kto w ogóle może sprawdzić tekst
- Claude znakuje globalnie od sierpnia i już było głośno
- Co to znaczy dla ciebie w Polsce
- Źródła
Co OpenAI ogłosiła i dlaczego właśnie w UE
Ogłoszenie składa się z trzech elementów. Pierwszy: w nadchodzących tygodniach niewidzialny znak wodny trafi do wyjść tekstowych ChatGPT i Codexa dla uprawnionych użytkowników w całej UE, na wszystkich planach, także darmowym. Drugi: klienci API na całym świecie mogą od 5 października dobrowolnie włączyć znakowane wyjścia dla wybranych modeli, domyślnie pozostaje on wyłączony. Trzeci: OpenAI otwiera wnioski o dostęp do detektora, przyznawane indywidualnie zatwierdzonym badaczom i organizacjom eksperckim. Firma wprost pisze, że nie robi ze znaku globalnego domyśla na start i że podejście regionalne daje jej przestrzeń na naukę z realnego użycia.
Powodem jest AI Act, unijne rozporządzenie o sztucznej inteligencji. Jego artykuł 50 ustęp 2 wymaga, by dostawcy systemów generujących treści syntetyczne oznaczali je w sposób czytelny maszynowo, a termin zgodności dla dostawców, także tych na rynku wcześniej, minął 2 sierpnia 2026. OpenAI tłumaczy, że fazowane podejście wynika i z wymogów prawa, i z ograniczeń samej technologii, która według niej pozostaje wczesna i pełna ograniczeń.
Jak działa textGrain
To nie metka doklejana na końcu tekstu ani ukryty napis w metadanych pliku. textGrain osadza niewidzialny sygnał statystyczny w samych wyborach słów, których dokonuje model podczas generowania. Dla człowieka tekst wygląda i czyta się normalnie, ale detektor znający klucz potrafi sprawdzić, czy rozkład słów w fragmencie nosi ślad OpenAI. Szczegóły opisano w raporcie technicznym „textGrain: Entropy-Calibrated Watermarking for Language Model Text” z 5 października, a OpenAI zapowiada udostępnienie technologii jako open source i uzupełnianie raportu w kolejnych tygodniach.
We własnych porównaniach OpenAI pisze, że textGrain dorównał albo przebił inne testowane podejścia, w tym SynthID do tekstu od Google DeepMind, na którym opiera się też znak wodny w Claude. Ważniejsze dla zwykłego użytkownika są benchmarki jakości: na ośmiu testach używanych do oceny modelu Astra wyniki tekstu znakowanego i nieznakowanego mieszają się w granicach błędu pomiaru. Dla przykładu GPQA Diamond dało 94,44 punkta bez znaku i 93,94 ze znakiem, a Terminal-Bench 4.0 wypadł wręcz lepiej na tekście znakowanym, 53,90 wobec 56,06. Chodzi o to, żeby znak niczego nie psuł, i z tych liczb wynika, że nie psuje.
Gdzie detekcja zawodzi
OpenAI sama publikuje liczby, przy których detekcja kruszeje, i to jest chyba najbardziej uczciwy fragment całego ogłoszenia. Przy zakładanej stopie fałszywych alarmów 1% detektor pochwycił znak w około 80% fragmentów o długości 200 tokenów i w około 95% fragmentów 400-tokenowych, na treści psychologicznej. Dla matematyki wyniki były wyraźnie niższe, bo tam dobór słów ma mało swobody. Krótszy tekst jest po prostu trudniejszy do złapania.
Redakcja tekstu zawodzi go jeszcze szybciej. W testach na 400-tokenowych fragmentach zamiana 10% słów na synonimy spadała ze skutecznością detekcji z około 92% do 66%, a zamiana 25% słów zostawiała z 17%. Ars Technica dodaje, że teksty tłumaczone też wykrywają się gorzej i że istniejące standardy, jak SynthID czy C2PA, da się obejść podstawową wiedzą. Wniosek z tych liczb jest prosty: kto chce ukryć pochodzenie tekstu, ten go ukryje, a znak łapie głównie tych, którzy nawet nie wiedzą, że istnieje.
Kto w ogóle może sprawdzić tekst
Na razie prawie nikt. Dostęp do detektora przyznawany jest indywidualnie i na start mają go tylko zatwierdzeni badacze oraz organizacje eksperckie, zgodnie z unijnym kodeksem praktyki dotyczącym przejrzystości treści generowanych przez AI. Wniosek składa się formularzem od 5 października. Samo narzędzie ma odpowiadać na jedno pytanie, czy fragment nosi znak OpenAI, bez ujawniania tożsamości użytkownika, jego promptów ani rozmów.
Oznacza to, że nauczyciel sprawdzający wypracowanie czy rekruter oceniający list motywacyjny nie mają jak zweryfikować tekstu oficjalnym detektorem. OpenAI tłumaczy tę ostrożność ryzykiem fałszywych trafień i pomyłek: przy 1% stopy fałszywych alarmów na milionach tekstów pomyłek będzie sporo. Godzi się też pamiętać, czego wynik detekcji w ogóle nie dowodzi. Znak nie mierzy, ile pracy człowieka siedzi w tekście, nie ustala własności ani odpowiedzialności, nie wskazuje użytkownika, nie weryfikuje prawdziwości, a brak wykrycia nie dowodzi autorstwa ludzkiego: tekst mógł być za krótki, przetłumaczony, mocno redagowany albo pochodzić od innego producenta.
Claude znakuje globalnie od sierpnia i już było głośno
OpenAI nie jest pierwsza. Anthropic włączył znak wodny w Claude globalnie 12 sierpnia, więc dotyczy też użytkowników w Polsce, i zrobił to dla spełnienia tego samego unijnego kodeksu przejrzystości. Reakcja była ostra. Użytkownicy na Reddicie pisali o „cyfrowym tatuażu na czole” dla studenta, który poprosił o porządkowanie akapitu, albo dziennikarza, który kazał streścić dwustustronicowy zapis rozprawy. John Gruber na Daring Fireball ochłodził pomysł nazwaniem watermarkingu „perversion of writing”, a wątek o sprawie zebrał na Hacker News ponad 800 punktów. Nature przytoczyło głosy badaczy sceptycznych wobec tego, że znaki wodne powstrzymają śmietnik treści generowanych masowo przez AI.
To tło warte pamiętać przy ocenie decyzji OpenAI. Włączenie znaku tylko tam, gdzie wymaga tego prawo, z detektorem zamkniętym i jawną listą ograniczeń, wygląda na lekcję wyciągniętą z sierpniowej awantury Anthropica. Zwłaszcza że SynthID do tekstu, techniczna baza znaku w Claude, pochodzi od Google DeepMind, firmy stojącej też za Gemini, o którego bezpieczeństwie pisaliśmy osobno.
Co to znaczy dla ciebie w Polsce
Czy twój ChatGPT już znakuje teksty? Nie, dopiero rollout „w nadchodzących tygodniach”, więc na dziś nic się nie zmieniło. Gdy dojdzie, obejmie wszystkie plany w UE, łącznie z darmowym, oraz Codexa. Przełącznika w ustawieniach aplikacji nie będzie; wybór masz tylko w API, gdzie znak włącza się dobrowolnie i domyślnie jest wyłączony.
Czy da się znak usunąć? Z oficjalnych liczb wynika, że parafraza jednej czwartej tekstu redukuje detekcję do poziomu szumu, a temat „jak usunąć znak wodny chatgpt” już żyje w podpowiedziach Google. Tu krótkie ostrzeżenie, bo ten klaster fraz przyciąga śmieci: strony obiecujące „usunięcie znaku wodnego AI” potrafią prosić o wklejenie tekstu, wgranie dokumentu albo zainstalowanie narzędzia, a to klasyczny schemat, w którym ofiarą padniesz ty, nie znak. Pamiętaj też, że znak to tylko jeden z tropów: że ChatGPT zbiera dane o użytkownikach i po co, opisywaliśmy przy ciasteczku __obi, niezależnie od całej historii ze znakami wodnymi.
Trzecie pytanie, najważniejsze: czy złamanie znaku oznacza złamanie zasad? Nie. OpenAI sama pisze, że wynik detekcji nie mierzy wkładu człowieka i nie rozstrzyga, czy użycie AI było dozwolone. Regulamin szkoły, uczelni albo pracodawcy obowiązuje tak samo, niezależnie od tego, czy tekst nosi znak, czy nie. Do rozstrzygania plagiatów znak na razie się nie nadaje i sama OpenAI tego nie ukrywa.
Źródła
- OpenAI: Our approach to EU text provenance rules (5.10.2026)
- Raport techniczny: textGrain, Entropy-Calibrated Watermarking for Language Model Text (PDF, 5.10.2026)
- Ars Technica 6.10.2026: OpenAI will watermark ChatGPT outputs by default, but only in the EU
- The Verge 6.10.2026: OpenAI is adding text watermarking in ChatGPT and Codex
- Unite.AI 5.10.2026: OpenAI Begins Phased Text Watermarking Under EU AI Act Rules
- Harmonogram stosowania AI Act, artykuł 50 ust. 2 (artificialintelligenceact.eu)
- TechCrunch 12.08.2026: Claude users are mad about Anthropic’s watermarks
- Daring Fireball 16.08.2026: Anthropic’s watermark text adulteration in Claude
- Nature 16.08.2026: Can Anthropic’s invisible watermarks curb AI slop?