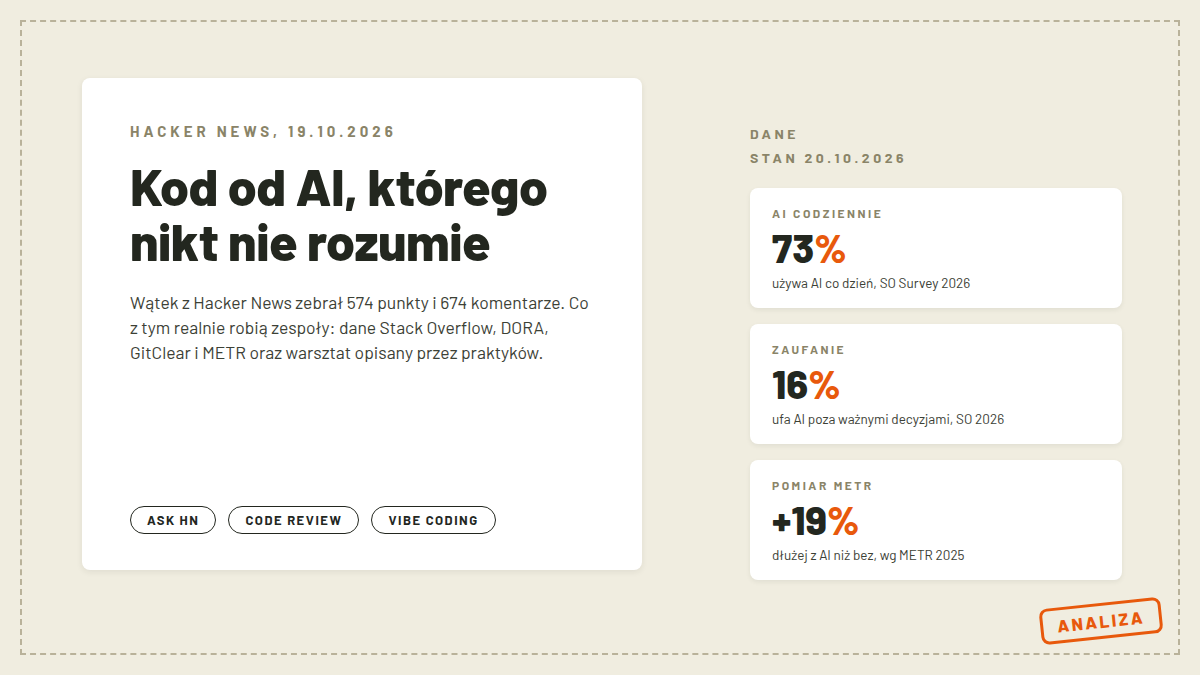
W poniedziałek 19 października o 11:24 UTC na Hacker News wylądowało pytanie, co robić z kodem napisanym przez AI, którego nikt nie rozumie. Autor wątku, rzk, przytoczył post z LinkedIna inżyniera Mety: „Piszę ostatnio kod i wszystko czuję jak czarną skrzynkę. Ten nowy standard shipowania z AI rozpędza się tak, że gdybym miał sprawdzać każdą linię, nigdy bym nie skończył”. Dwie doby później wątek „Ask HN: How to deal with shipping AI-written code you don’t understand?” miał 574 punkty i 674 komentarze w drzewie Algolii (odczyt 20.10.2026, 19:51 UTC).
Dyskusja nie dotyczy jakiejś niszowej praktyki. Dla dużej części programistów to już codzienny tryb pracy bliski vibe codingowi: opisujesz, co ma powstać, agent pisze, ty zatwierdzasz. Ankiety pokazują, że taki podział ról jest masowy, a jednocześnie mało kto ślepo ufa temu, co wypisuje model. Z 674 odpowiedzi da się złożyć konkretny obraz: co zespoły naprawdę robią z kodem, którego nie czytają od pierwszej do ostatniej linii, i jakie dane mówią, czy to działa.
- Wszyscy używają, mało kto ufa
- Cztery postawy z jednego wątku
- Co konkretnie robią zespoły
- Szybciej nie znaczy lepiej
- A w Polsce
Wszyscy używają, mało kto ufa
Rozjazd, który podpalił wątek, widać w liczbach. Stack Overflow Developer Survey 2026 podaje, że 73% respondentów używa narzędzi AI codziennie, a niemal jedna trzecia z tej grupy spędza z nimi ponad cztery godziny dziennie. Asystenci kodowania i agenci (66%) wysunęli się na pierwsze miejsce zastosowań, wyprzedzając ogólne chatboty (63%). Narzędzia weszły w infrastrukturę pracy, tak jak kiedyś systemy kontroli wersji.
Zażyłość nie oznacza zaufania. Gdy ankieta pyta, kiedy wolno polegać na AI, 48% wskazuje sytuacje, w których odpowiedź łatwo zweryfikować, a tylko 16% przenosi to zaufanie na większość zadań poza ważnymi decyzjami. Stąd naturalny podział: 69% generuje kod w obszarach, które dobrze znają, 56% w takich, których nie znają. Czyli częściej tam, gdzie łatwiej wychwycić błąd, rzadziej tam, gdzie błąd byłby najdroższy. Raport DORA 2025, zbadany na prawie 5000 osób z branży, dorzuca drugi koniec tego rozjazdu: 90% używa AI w pracy, ponad 80% deklaruje wzrost produktywności, ale 30% ma mało albo w ogóle nie ma zaufania do generowanego kodu. I najciekawsze: adopcja AI koreluje dodatnio z przepustowością dostaw, a ujemnie ze stabilnością. Autorzy wiążą to z brakiem kontrolnych systemów wokół rosnącej liczby zmian: bez mocnych testów, dojrzałej kontroli wersji i szybkich pętli informacji zwrotnej więcej zmian oznacza więcej awarii.
Cztery postawy z jednego wątku
Pierwsza postawa jest twarda: nie wdrażaj. bitbasher odpowiada wprost: „Przestań shipować kod, którego nie rozumiesz”. W podobnym duchu plastic041 przyznaje, że komentarze w wątku przeraziły go ilością sposobów na omijanie własnego kodu: „Przynajmniej jedna osoba w firmie powinna umieć wyjaśnić, jak ten kod działa”. Dla tej grupy pytanie z tytułu wątku w ogóle nie ma sensownej odpowiedzi innej niż siad i przeczytanie.
Druga postawa mówi: to, co przeżywasz, to zwykłe zarządzanie, tylko że podwładnymi są modele. spacedcowboy, autor kompilatora z autowektoryzacją, opisuje sesje planistyczne, wielogodzinne bramki testowe na pięciu architekturach przed każdym wydaniem i checkiny trzymane na małą skalę. Pisze, że po pół roku pracy z agentem zna jego dziwady jak kollegi. koliber przechodzi przez analogię menedżerską: był pierwszym inżynierem startupu, potem nadzorował ponad 50 osób i i tak rozumiał systemy tylko z wysoka. Model „im ważniejsza i trudniejsza do cofnięcia decyzja, tym więcej czasu na jej sprawdzenie” przenosi się na agentów bez zmian. Skoro tak, to rola się zmienia, a o tym, co vibe coding robi z pracą programisty, pisaliśmy osobno.
Trzecia postawa kłamstwo wygody nazywa po imieniu. mooreds skraca całą dyskusję do jednego zdania: „Odpowiadasz za to. I tak będziesz musiał to zrozumieć, przy pisaniu albo przy debugowaniu”. TZubiri dorzuca: „nie myj rąk”. Najciężej uderza Silhouette, jeden z najaktywniejszych komentatorów wątku (trzynaście odpowiedzi): przyjmowanie odpowiedzialności za kod, nad którym nie miało się władzy, to jego zdaniem „gra dla frajerów” i powód, dla którego zaczął zmieniać zdanie o ruchach pracowniczych i licencjonowaniu w tej branży.
Czwarta postawa jest najbardziej techniczna i dotyczy testów. edwin0 pyta, co robić, gdy AI pisze i kod, i testy: mogą się zgadzać nawzajem i przeoczyć to samo. Silhouette odpowiada w tym samym wątku: pisanie dobrego zestawu testów to jedna z najsłabszych stron obecnych modeli, więc sypiąca się liczba testów z generatora nie jest dowodem jakości. To ważne, bo „mamy testy” to najczęstsza odpowiedź w wątku na zarzut, że nikt nie czyta kodu.
Co konkretnie robią zespoły
Z odpowiedzi, które opisują realny warsztat, a nie filozofię, układa się kilka powtarzalnych ruchów. lp92 budujący oprogramowanie do symulacji i projektowania dronów trzyma dokument projektowy każdej funkcji i każdą poprawkę opatruje analizą przyczyny, a wszystkie te dokumenty zatwierdza osobiście przed dotknięciem kodu. Bramki dokumentowe łapią nieporozumienia zanim agent cokolwiek napisze. bitwizeshift idzie o krok dalej: „Nie pozwalam LLM projektować kodu. On implementuje projekt, który przygotowałem ja”. Sam rozpisuje hierarchię abstrakcji, a modelowi zostawia wypełnienie między nimi, bo w jego doświadczeniu modele notorycznie psują architekturę. Jego zespół dodał do tego wspólne przeglądy projektów, żeby każdy rozumiał zmiany, a nie tylko autor zadania.
Drugi ruch to testy jako kontrakt, ale takie, którym można wierzyć. cadamsdotcom wymaga, żeby test napisany przez agenta najpierw zawiódł na oczach człowieka, a dopiero potem zrobił się zielony po implementacji. dboreham radzi celowo wstrzykiwać błędy i patrzeć, czy suite je wyłapie, bo inaczej nie wiadomo, czy testy w ogóle testują. Trzeci ruch to odwrócenie kierunku czytania: zamiast przedzierać się przez diff, pyta się agenta. PaulHoule ładuje projekt do IDE z agentem i dopytuje „jak z tej biblioteki osiągnąć X” albo „wyjaśnij, dlaczego tu wybrano ten algorytm”. iamwil przywołuje eseja Petera Naura z 1985 roku o teorii systemu w głowie programisty i podaje swoją listę: projektowanie przez przesłuchanie agenta, decyzje produktowe zostawione człowiekowi, generowanie explainerów i quizów z własnego systemu oraz weryfikatory w pętli kodowania.
Czwarty ruch to ograniczenie rozmiaru zmian, bo recenzja 2000 linii po fakcie nie istnieje, niezależnie od tego, kto je napisał. Piąty to mechaniczne zapory na styku: linter, typowanie, statyczna analiza, a na poziomie samego rozumienia git hook przepytujący z kodu od agenta. Nic z tej listy nie jest nową technologią. To stare praktyki inżynierskie dostrojone do tego, że pierwszym autorem zmiany bywa model.
Szybciej nie znaczy lepiej
Dane o jakości są w najlepszym razie mieszane. GitClear, na 211 milionach zmienionych linii z lat 2020-2024 z repozytoriów Google, Microsoftu, Mety i spółek korporacyjnych, odnotował spadek udziału refaktoryzacji z 25% zmienianych linii w 2021 do poniżej 10% w 2024, przy wzroście linii wklejanych z 8,3% do 12,3%. W ich danych kopiuj-wklej po raz pierwszy przebił kod przenoszony, czyli klasyczny sygnał reużycia. Taki kod da się szybko napisać i powoli utrzymywać.
Z pomiarem tempa też bywa śmiesznie. RCT METR z lipca 2025 roku, w którym 16 doświadczonych deweloperów open source pracowało nad 246 prawdziwymi zadaniami ze swoich repozytoriów, wykazało, że z narzędziami AI (Cursor Pro z Claude 3.5/3.7 Sonnet) zadania zajmowały im o 19% więcej czasu. METR sama po czasie dopisała do tego badania ostrzeżenie, a w lutym 2026 przyznała, że kontynuacja eksperymentu daje niewiarygodny sygnał przez efekty selekcji i że prawdopodobnie deweloperzy są dziś przyspieszani, tylko skali nie umieją zmierzyć. Deklaracje respondentów i pomiar na zadaniach rozjeżdżają się w obie strony, co samo w sobie jest argumentem za bramkami zamiast wiary w szybkość. Realokacja pracy, o której piszą komentujący, nie jest teorią: ich wewnętrzne dane pokazuje tekst o tym, jak AI zmienia pracę w Anthropicu.
Najtrafniejsze podsumowanie klimatu należy jednak do Silhouette: „Widzę branżę, która szybko dzieli się na dwa obozy: move fast and break things i to musi naprawdę działać. Pisanie wszystkiego agentami i merge z ledwo zerkanym w PR stało się standardem w pierwszym, ale w drugim wylatujesz z pokoju ze śmiechu”.
A w Polsce
Polski obieg zna temat, ale w wersji pytania, nie pomiaru. ITwiz we wrześniu pytał wprost w tytule, kto sprawdzi kod, który AI pisze w kilka minut. MyCompanyPolska opisała 20 października język programowania Dominika Pichety, zaprojektowany tak, żeby mylić modele AI, żaden nie przeszedł jego testu w całości. ISBtech 19 października pisał o tym, że kod tanieje, a rośnie znaczenie decyzji o tym, co w ogóle budować. Polskich danych o tym, ile kodu trafia na produkcję bez czytania przez człowieka, nie znalazłem. Nikt u nas tego nie policzył.
Najkrótszą odpowiedź w całym wątku dał zresztą chrisjj. Na pytanie z tytułu odpisał: „Recognise you aren’t the one shipping it”. Uświadom sobie, że to nie ty to wdrażasz. Reszta 674 komentarzy to rozpisane szczegóły tej jednej uwagi.
Źródła
- Wątek „Ask HN: How to deal with shipping AI-written code you don’t understand?” (574 pkt, 674 komentarze, odczyt 20.10.2026 19:51 UTC, wraz z cytowanym w nim postem inżyniera Mety z LinkedIna): https://hn.algolia.com/api/v1/items/50151036
- Stack Overflow Developer Survey 2026, sekcja AI, odczyt: https://survey.stackoverflow.co/2026/ai
- Zapowiedź raportu DORA 2025 „State of AI-assisted Software Development” na blogu Google Cloud (23.09.2025), odczyt: https://cloud.google.com/blog/products/ai-machine-learning/announcing-the-2025-dora-report
- GitClear, „AI Copilot Code Quality: 2025 Look Back at 12 Months of Data”, odczyt: https://www.gitclear.com/ai_assistant_code_quality_2025_research
- METR, „Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity” (10.07.2025), odczyt: https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- METR, „We are Changing our Developer Productivity Experiment Design” (24.02.2026), odczyt: https://metr.org/blog/2026-02-24-uplift-update/
- Google News RSS PL, tytuły ITwiz (1.09.2026), MyCompanyPolska (20.10.2026) i ISBtech (19.10.2026), odczyt: https://news.google.com/rss/search?q=kod+AI+rozumienie+programista&hl=pl&gl=PL&ceid=PL:pl