17 października The Verge opisał na jednej stronie to, co użytkownicy agentów AI do tej pory zgłaszali pojedynczo: popularne serwisy odmawiają agentom dostępu do swoich funkcji. Yelp przyjął zasadę, że agent działa tylko wtedy, gdy jego twórca płaci za licencję na dane. Delta nie pozwala agentowi zarezerwować biletu. JPMorgan Chase i Charles Schwab potwierdziły, że blokują agentom dostęp do kont w obawie o bezpieczeństwo. A część serwisów, jak Cars.com albo Amtrak, po prostu przestała działać u użytkowników, bez komunikatu.
Wątek na Hacker News (50141657, 122 punkty i 115 komentarzy, odczyt 18 października) sprowadził całą sprawę do dwóch zdań. Użytkownik bdcravens zwrócił uwagę, że to nie jest klasyczne blokowanie anonimowych scraperów: strony odmawiają agentom nawet wtedy, gdy mają „proper ticket”, czyli konto albo opłacony dostęp. Drugi komentarz, użytkownika spwa4, idzie głębiej: cały internet opiera się na sprzedaży czyjejś uwagi, a AI obiecuje te same usługi bez oddawania uwagi w zamian. Opisuję niżej: kto blokuje, czym, co widzi osoba, której agent utknął, i jak na tym tle wygląda polski internet.
- Kto blokuje i dlaczego
- Czym właściwie blokują
- Co widzi użytkownik, gdy agent dostaje blokadę
- Czy da się to obejść
- Co z tego dla Polski
| Kto | Co się dzieje | Skąd to wiemy |
|---|---|---|
| Yelp | agent tylko w ramach płatnego programu licencji na dane | oświadczenie Yelpa dla TechCrunch, przywołane przez The Verge |
| Delta Air Lines | agent nie zarezerwuje biletu w imieniu użytkownika | The Verge, 17.10.2026 |
| JPMorgan Chase, Charles Schwab | blokada dostępu agentów do kont, powód: bezpieczeństwo | potwierdzenie obu firm dla The Verge |
| Amazon | spór z Perplexity przed sądem; żądanie odcięcia agenta Muse Meta | The Verge; sąd apelacyjny w sierpniu uchylił nakaz, Amazon złożył zmieniony pozew |
| deklaracja w robots.txt: blokada dla wszystkich botów | odczyt robots.txt, 18.10.2026 | |
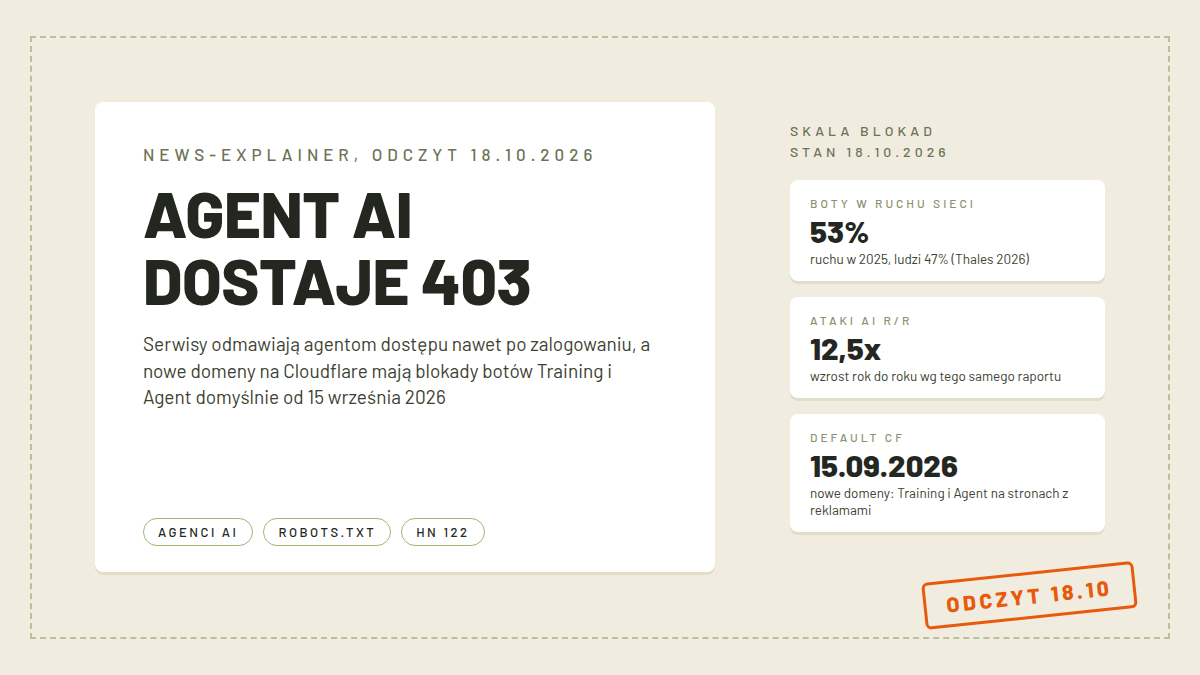
| Cloudflare | od 15.09.2026 nowe domeny mają domyślnie blokować boty typu Training i Agent na stronach z reklamami | dokumentacja Cloudflare, aktualizacja 1.07.2026 |
| Cały rynek | boty to 53% ruchu w 2025, 40% z tego ruchu złośliwe | Thales 2026 Bad Bot Report |
Kto blokuje i dlaczego
Lista z artykułu The Verge jest dłuższa, niż podpowiada intuicja. Użytkownicy zgłaszali blokady w Meta Muse, w agencie xAI Grok, w OpenAI Dots i u Instinct. Nie chodziło o egzotyczne strony, tylko o najpopularniejsze serwisy zakupowe, podróżne i finansowe. Delta potwierdziła, że agent nie kupi biletu w imieniu pasażera, banki odcięły agentom dostęp do kont niezależnie od swojej wielkości, a Cars.com i Amtrak, które wcześniej działały z agentami, przestały odpowiadać. Najbardziej frustrujący typ blokady: nikt nie ogłasza, agent po prostu dostaje odmowę.
Tło tej fali to spór Amazona z Perplexity, ciągnący się od zeszłego roku. Amazon zabronił agentowi Perplexity kupowania na swojej platformie i pozwał firmę, argumentując, że firmy trzecie kupujące w imieniu klientów powinny „działać otwarcie i szanować decyzje dostawców, czy chcą uczestniczyć”. Perplexity odpowiadała, że agent to przedłużenie użytkownika, a Amazon „nie wierzy w twoje prawo do zatrudnienia pracownika działającego w twoim imieniu”. Sąd najpierw nakazał wstrzymanie agentów, apelacja w sierpniu uchyliła ten nakaz, a Amazon złożył zmieniony pozew. Sprawa jest nierozstrzygnięta, ale lista serwisów, które blokują agentów na własną rękę, rośnie szybciej niż orzecznictwo.
Meta odpowiedziała na blokady Muse postem z października: „odwracając się od osobistego agenta, odwracasz się od klienta, który za nim stoi”. Zamiast walczyć z Amazonem firma postawiła na partnerstwa z Walmartem, Gapem, Sephorą i Best Buy, a Shopify otworzył swoje sklepy na agentów. Widać tu nowy podział rynku: albo umowa i licencja, albo odmowa. Chris Canal, szef firmy EquiStamp oceniającej bezpieczeństwo modeli, powiedział The Verge wprost: blokady uderzają w postrzeganą wartość firm takich jak OpenAI czy Anthropic, bo jeśli część sieci aktywnie blokuje agentów, to mają oni po prostu mniej rzeczy, które potrafią zrobić.
Czym właściwie blokują
Pierwsza warstwa to robots.txt, plik, w którym serwis deklaruje, czego nie wolno pobierać. Sprawdziłem kilka dużych robots.txt na żywo, 18 października. Amazon wymienia tam z imienia i blokuje w całości (Disallow: /) między innymi GPTBot, ClaudeBot, CCBot, PerplexityBot, Google-Extended, a także agenty: GoogleAgent-Mariner, GoogleAgent-Shopping, Gemini-Deep-Research, Devin, Copilot. Reddit poszedł dalej i wyłącza wszystkich botów naraz: User-agent: *, Disallow: /. Yelp dzieli boty w pliku na dwie szuflady: crawlery treningowe (GPTBot, ClaudeBot, CCBot, Google-Extended, anthropic-ai) dostają Disallow: / dla całej domeny, a agenty działające na polecenie użytkownika (ChatGPT-User, Claude-User, Perplexity-User) mogą wejść tylko na ścieżki /article, resztę mają zablokowaną. Nad blokami stoi notka „AI / LLM Crawlers and Agents”. Podział dobrze ilustruje to, co Yelp mówi prasie: agent zobaczy tyle, ile Yelp sprzeda w licencji.
Problem w tym, że robots.txt jest deklaracją, nie zaporą. Respektują go uczciwe roboty, ale nie wymusza niczego. Właściwe blokady siedzą warstwę niżej, na poziomie firewalla aplikacji. I tu wchodzi Cloudflare, przez którego przechodzi ogromna część internetu. Firma umożliwiła klientom jednoprzyciskową blokadę crawlerów AI, a 1 lipca 2025 uczyniła z niej domyślne ustawienie dla nowych domen, z opcją „Pay Per Crawl”, płatnego dostępu dla crawlerów. Dokumentacja opisuje teraz trzy kategorie zachowań: Search (indeksowanie do wyszukiwania), Training (zbieranie danych do treningu) i Agent (działanie w czasie rzeczywistym w imieniu człowieka, na przykład boty pobierające strony na żądanie i agent z przeglądarką). Od 15 września 2026 nowe domeny na Cloudflare mają domyślnie blokować Training i Agent na stronach z reklamami. NBC News opisało to jako ultimatum dla crawlerów łączących wyszukiwanie z treningiem.
Są też narzędzia mniejszej skali. Anubis, otwarty reverse proxy, stawia przed podejrzanym ruchem zadanie obliczeniowe (proof of work), zamiast prosić o kliknięcie obrazka. Opis w repozytorium brzmi jak żart, ale jest dosłowny: „wagi duszy przychodzących żądań HTTP”. Projekt wystartował w marcu 2025 i ma ponad 23 tysiące gwiazdek na GitHubie (odczyt 18 października). Przy okazji sam przekonałem się, do czego to prowadzi: strona dokumentacji Anubisa stoi za Anubisem. Zanim przeczytasz dokumentację, musisz udowodnić, że nie jesteś botem. Tak już wygląda internet, do którego zmierzamy.
Co widzi użytkownik, gdy agent dostaje blokadę
Najczęściej nic sensownego. Agent próbuje otworzyć stronę i dostaje błąd dostępu, komunikat o „nietypowej aktywności” albo o „podejrzanej aktywności na koncie”. The Verge opisuje, według zgłoszeń z Reddit, przypadki, gdy Google blokował konta ludzi używających Muse z powodu „suspicious activity”, a inni użytkownicy mieli problemy z finalizacją zakupów w Walmart, mimo że Walmart jest partnerem Meta. Czyli blokada dosięga nawet tam, gdzie formalnie współpraca jest podpisana. Dla zwykłego człowieka wygląda to tak, jakby jego własne konto zostało właśnie przejęte przez kogoś trzeciego.
Chris Canal tłumaczy w tym samym artykule, skąd się to bierze: systemy ochronne na stronach nie były projektowane przeciwko agentom, tylko przeciwko botom oszukującym i łamiącym konta. Agent wykonujący polecenie „zamów pizzę” generuje ruch, który wygląda jak atak: szybkie przejścia, nietypowa kolejność stron, brak naturalnych przerw. Zabezpieczenia traktują go jak intruza. Jego przewidywanie jest mało optymistyczne: więcej stron dojdzie do wniosku, że skoro agentom trzeba blokować, to każdemu trzeba postawić test na człowieczeństwo, także w sklepie spożywczym.
Skala, z którą serwisy się liczą, jest realna. Raport Thales (dawna Imperva) Bad Bot Report 2026 podał, że w 2025 boty wygenerowały 53% ruchu w internecie, z czego 40% sklasyfikowano jako złośliwe, a udział ludzi spadł do 47%. Ataki realizowane przez AI wzrosły rok do roku 12,5 raza, a 27% ataków botów celowało w API. Serwis widzi w logach głównie maszyny i ma coraz mniejsze zaufanie do ruchu, którego nie umie skategoryzować. Agent, który chce działać jak człowiek, ląduje w tej samej szufladzie.
Czy da się to obejść
Operatorzy agentów mają na to własną odpowiedź i opisują ją w dokumentacji wprost. OpenAI w opisie agenta ChatGPT-User pisze, że te akcje są inicjowane przez użytkownika, więc „zasady robots.txt mogą nie mieć zastosowania”. Perplexity w opisie Perplexity-User idzie krok dalej: „ponieważ pobrania zażądał użytkownik, ten pobierający co do zasady ignoruje zasady robots.txt”. Dla operatorów agent jest ręką użytkownika. Dla serwisu to nadal maszyna, która wchodzi bez zgody, więc odpowiedź przenosi się z robots.txt na firewall: serwisy blokują po IP, po odcisku przeglądarki, po zachowaniu. Udawanie człowieka przez podmianę nagłówka User-Agent przestaje działać, bo Cloudflare weryfikuje tożsamość botów kryptograficznie (Web Bot Auth) i wystawia opłatę albo odmowę zamiast strony.
Legalne obejścia istnieją, ale wszystkie wymagają umowy. Yelp sprzedaje dostęp w programie licencyjnym, Meta podpisała partnerstwa z sieciami handlowymi, Shopify otworzył platformę. Amazon i Perplexity swoją sprawę rozstrzygną w sądzie, ale do tego czasu obecność agenta Perplexity na Amazonie to decyzja wstrzymana w rękach prawników, nie inżynierów. Dla użytkownika końcowego wniosek jest brutalnie prosty: agent działa tam, gdzie twórca agenta dogadał się z serwisem. Nikt nie ma obowiązku cię wpuścić tylko dlatego, że zapłaciłeś za abonament modelu.
Co z tego dla Polski
Sprawdziłem robots.txt trzech polskich serwisów, 18 października. Gazeta.pl blokuje w całości GPTBot, anthropic-ai i CCBot, czyli crawlery treningowe, ale nie ma reguł dla agentów typu ClaudeBot czy PerplexityBot. Allegro ma tylko ograniczenia parametrów dla CCBot. Wykop nie blokuje niczego poza /api/. Czyli oficjalnie polskie serwisy nie ogłaszają wojny z agentami. robots.txt to tylko deklaracja: realne blokady mogą siedzieć w firewallu bez ogłoszenia, ale przynajmniej nie ma tu amerykańskiej fali.
Praktyczne wnioski są dwa. Jeśli używasz agenta z przeglądarką, nie dawaj mu kont, których utrata boli: bankowości, portalów medycznych, sklepów z zapisanymi kartami. Banki i tak blokują takie logowania, a komunikat o podejrzanej aktywności po zablokowanej sesji agenta oznacza w najlepszym razie reset hasła. Jeśli prowadzisz stronę: od 15 września 2026 nowe domeny na Cloudflare mają domyślne blokady kategorii Agent, więc decyzja, czy agent widzi twoją stronę, wymaga jednej wizyty w panelu. Protokoły integracji typu MCP ułatwiają agentom wpięcie się w narzędzia, ale nic nie dają, gdy serwis odmawia na poziomie firewalla.
Polskich narzędzi agentowych pierwszej linii nie ma, więc polski użytkownik korzysta z OpenAI, Anthropic, Perplexity albo Meta i dziedziczy wszystkie blokady z listy powyżej, z tym samym komunikatem o podejrzanej aktywności. Spór, który toczy się na Zachodzie o uwagę i licencje, u nas jeszcze się nie zaczął, więc okno, w którym polskie sklepy i serwisy mogą wynegocjować swoje warunki zamiast kopiować odmowy, jest otwarte. Ale to raczej stan przejściowy niż zasada.
Źródła
- The Verge, „Websites are closing their doors to AI agents”, Emma Roth, publikacja 17.10.2026, odczyt 18 października 2026: https://www.theverge.com/ai-artificial-intelligence/1013195/ai-agents-blocked-web
- Wątek Hacker News 50141657 przez Algolia items API (122 punkty, 115 komentarzy z drzewa), odczyt 18 października 2026: https://hn.algolia.com/api/v1/items/50141657
- robots.txt Amazon (lista zablokowanych botów i agentów), odczyt 18 października 2026: https://www.amazon.com/robots.txt
- robots.txt Reddit (blokada dla wszystkich botów), odczyt 18 października 2026: https://www.reddit.com/robots.txt
- robots.txt Yelp (crawlery treningowe
Disallow: /, agenty użytkownika tylko/article, notka AI / LLM Crawlers and Agents), odczyt 18 października 2026: https://www.yelp.com/robots.txt - robots.txt Gazeta.pl (blokada
GPTBot,anthropic-ai,CCBot), odczyt 18 października 2026: https://www.gazeta.pl/robots.txt - robots.txt Allegro (ograniczenia dla
CCBot), odczyt 18 października 2026: https://allegro.pl/robots.txt - robots.txt Wykop.pl (brak reguł AI), odczyt 18 października 2026: https://wykop.pl/robots.txt
- Cloudflare, „Introducing pay per crawl”, publikacja 1.07.2025, odczyt 18 października 2026: https://blog.cloudflare.com/introducing-pay-per-crawl/
- Cloudflare docs, „Block AI Bots”, aktualizacja 1.07.2026, odczyt 18 października 2026: https://developers.cloudflare.com/bots/additional-configurations/block-ai-bots/
- The Verge, „Cloudflare will now block AI crawlers by default”, publikacja 1.07.2025, odczyt 18 października 2026: https://www.theverge.com/news/695501/cloudflare-block-ai-crawlers-default
- NBC News, „Cloudflare sets deadline to block AI crawlers that bundle search with AI training”, Samantha Elkins, publikacja 1.07.2026, odczyt 18 października 2026: https://www.nbcnews.com/tech/tech-news/cloudflare-sets-ai-crawler-deadline-separate-search-blocked-rcna352446
- GitHub, repozytorium TecharoHQ/anubis (utworzone 17.03.2025, 23 508 gwiazdek), odczyt 18 października 2026: https://github.com/TecharoHQ/anubis
- SecurityBrief UK, „Bots make up 53% of web traffic, Thales report says”, publikacja 30.04.2026, odczyt 18 października 2026: https://www.securitybrief.co.uk/story/bots-make-up-53-of-web-traffic-thales-report-says
- OpenAI docs, „OpenAI crawlers and user agents”, odczyt 18 października 2026: https://platform.openai.com/docs/bots
- Perplexity docs, „Perplexity bots”, odczyt 18 października 2026: https://docs.perplexity.ai/guides/bots
- Google News RSS, tytuł komunikatu prasowego Thales „AI-driven Bot Attacks Surged 12.5x According to Thales Bad Bot Report”, 29.04.2026, odczyt 18 października 2026: https://news.google.com/rss/search?q=Imperva%20bad%20bot%20report&hl=en-US&gl=US&ceid=US:en