Pod frazą „transkrypcja audio na tekst za darmo” Google podsuwa głównie konwertery online. Wgrywasz nagranie na obcy serwer, czekasz, a po chwili okazuje się, że bez abonamentu dostaniesz trzy minuty tekstu i prośbę o kartę. Da się inaczej. W tym poradniku opisujemy trzy drogi, które realnie kosztują zero złotych, a środkową z nich, całkiem bez internetu, przetestowaliśmy na własnym laptopie: nagranie z polskiej Wikipedii o długości 16 minut i 53 sekund zamieniło się w tekst w 3 minuty i 29 sekund, na zwykłym procesorze, bez karty graficznej i bez wysyłania czegokolwiek w sieć.
Kolejność jest od najprostszej do najbardziej prywatnej. Najpierw narzędzia online, które obsługują polski od ręki: Gemini, napisy na YouTube, dyktowanie w Dokumentach Google, a przy okazji płatna opcja w Wordzie dla tych, co mają już subskrypcję. Potem Whisper, darmowy model od OpenAI, który pracuje wyłącznie na twojej maszynie. To lustrzany temat wobec poradnika o zamianie tekstu na mowę, gdzie szliśmy w drugą stronę: z tekstu robiło się nagranie, tutaj nagranie wraca do postaci tekstu, na przykład wykładu, wywiadu albo godzinnego spotkania.
Spis treści:
- Trzy drogi online, zanim zainstalujesz cokolwiek
- Whisper: model od OpenAI, który nie potrzebuje internetu
- Test: trzy modele na tym samym polskim nagraniu
- Test podcastera: 16 minut i 53 sekundy
- Buzz: to samo bez terminala
- Ściąga: która droga do czego
- Nota uczciwości
- Źródła
Trzy drogi online, zanim zainstalujesz cokolwiek
Najprostsza droga prowadzi przez aplikację Gemini. Po zalogowaniu zwykłym kontem Google przeciągasz plik audio do okna rozmowy i prosisz o przepisanie. Strona wsparcia Google podaje granicę wprost: łącznie dziesięć minut audio na darmowym koncie, przy plikach do 100 MB, a po dokupieniu Google AI Pro albo Ultra limit rośnie do trzech godzin. To najwygodniejsza opcja na krótkie nagrania, na przykład notatkę głosową albo fragment wywiadu.
Google ma też model czysto do tej roboty, Gemini 3.5 Transcribe, ogłoszony 26 sierpnia 2026. Deklaruje automatyczne rozpoznawanie ponad 85 języków, znaczniki czasu z dokładnością do słowa i rozdzielenie do trzech mówców, a w pomiarach Artificial Analysis osiąga średnio 2,6% błędnych słów w trybie pracy na nagraniu. Na razie jest w podglądzie publicznym dla programistów w AI Studio, w samej aplikacji Gemini działa jego ograniczona wersja, a cennik Google nigdzie nie podaje, więc o kosztach pracy tego modelu w API niczego nie twierdzimy.
Druga droga jest wmontowana w YouTube. Serwis sam generuje napisy rozpoznawaniem mowy i publikuje je pod filmem, tylko w domyślnym języku nagrania, a Google odstrasza od materiałów dłuższych niż godzina i o słabym dźwięku. W praktyce to darmowy sposób na przepisanie własnego materiału wideo: wgrywasz film na niepubliczny kanał, a po chwili masz napisy, z których wychodzi tekst do poprawki.
Trzecia droga to dyktowanie na żywo w Dokumentach Google: Narzędzia, następnie Wpisywanie głosowe, polski jest na liście języków, wystarczy konto Google i mikrofon. To jednak nie transkrypcja pliku, tylko przepisywanie tego, co mówisz w danym momencie, więc do nagrania z telefonu się nie nada. Google zaznacza zresztą, że interpunkcja nie w każdym języku działa w pełni.
W Wordzie siedzi z kolei funkcja Transkrybuj, która przyjmuje nagrane pliki i rozpoznaje ponad 80 wariantów językowych, z polskim włącznie. Z kategorii „za darmo” wykluczają ją dwie rzeczy: wymaga subskrypcji Microsoft 365, a limit wgranych nagrań wynosi 300 minut miesięcznie. Jeśli subskrypcję już masz, to naturalna droga, bo tekst od razu ląduje w dokumencie.
Wszystkie te ścieżki mają dwie wspólne cechy: nagranie opuszcza twój komputer i każda z nich kończy się limitem, dziesięciu minut, godziny albo 300 minut na miesiąc. Przy dłuższym albo poufnym materiale zostaje trzecia rodzina narzędzi, ta z modelu Whisper.
Whisper: model od OpenAI, który nie potrzebuje internetu
Whisper to model rozpoznawania mowy wydany przez OpenAI w 2022 roku razem z pracą naukową i wagami na licencji MIT. Wytrenowano go na 680 tysiącach godzin mowy, z czego 117 tysięcy w 96 językach innych niż angielski, i to ta masa danych odpowiada za to, że polski obsługuje bez żadnej konfiguracji. Modeli jest sześć rozmiarów: tiny (39 mln parametrów), base (74 mln), small (244 mln), medium (769 mln) i large (1,55 mld), a osobny turbo (809 mln) to zoptymalizowany large-v3, osiągający w benchmarku OpenAI osiem razy prędkość wersji large. Wersje z dopiskiem .en są wyłącznie angielskie, więc nas interesują wielojęzyczne.
Jakość dla polskiego OpenAI mierzy we wskaźniku WER, czyli procencie błędnie rozpoznanych słów. W załącznikach paperu czytamy: 5,4% dla large-v2 na zbiorze Common Voice, 8,0% dla medium i 14,7% dla small. To zbiory czytanej mowy, więc traktuj te liczby jak punkt odniesienia, nie obietnicę; nagranie z pogłosem i nachodzącymi mówcami będzie trudniejsze.
Oryginalna implementacja Whisperra jest na zwykłym procesorze powolna, więc w teście użyliśmy faster-whisper: ponownej implementacji na silniku CTranslate2, według benchmarku autorów do czterech razy szybszej przy tej samej dokładności i z mniejszym zużyciem pamięci. Wymaga jedynie Pythona 3.9 albo nowszego, a FFmpeg nie jest potrzebny, bo dekodowanie audio robi wewnętrzna biblioteka. Dla skali: w benchmarku SYSTRAN model small na procesorze i7-12700K przepisał 13 minut audio w minutę i 42 sekundy, w 8-bitach.
Test: trzy modele na tym samym polskim nagraniu
Za materiał posłużyło nagranie ze Spoken Wikipedia, czyli czytany przez człowieka artykuł z polskiej Wikipedii o deflegmatorze: 68,2 sekundy, mono, licencja Commons. Maszyna testowa to zwykły laptop z procesorem Intel Core i7-10850H 2,70 GHz i dwunastoma wątkami, bez karty graficznej. Zainstalowaliśmy faster-whisper w wersji 1.2.1, modele liczyliśmy w 8-bitowej precyzji int8, z włączonym filtrem VAD, który przycina ciszę, żeby model nie dopisywał słów do pauz. Rozmiary pobrania: base 142 MB, small 464 MB, medium 1,5 GB. Pierwsze uruchomienie dociąga wagi z Hugging Face (u nas: 10, 31 i 86 sekund), a kolejne ładują model z lokalnego cache w 1,1 sekundy.
Cała instalacja i uruchomienie mieszczą się w dwóch wklejkach:
pip install faster-whisperfrom faster_whisper import WhisperModel
model = WhisperModel("small", device="cpu", compute_type="int8")
segments, info = model.transcribe("nagranie.ogg", language="pl", vad_filter=True)
for segment in segments:
print(f"[{segment.start:.1f} -> {segment.end:.1f}] {segment.text.strip()}")Wynik na tym samym 68-sekundowym nagraniu:
| Model | Pobranie | 68,2 s audio w | Tempo | Błędy na ok. 96 słów |
|---|---|---|---|---|
| base | 142 MB | 4,0 s | 17x realtime | ok. 9 |
| small | 464 MB | 11,2 s | 6,1x realtime | 4-5 |
| medium | 1,5 GB | 29,0 s | 2,3x realtime | 1 |
Rozpiętość jakości widać najlepiej na tym samym zdaniu. Wzorzec z nagrania brzmi „z Wikipedii, wolnej encyklopedii”. Base usłyszał „z wigipedi, wolnej encyklopedi” i przy okazji zgubił końcówki w „kolbę destylacyjną”, którą zapisał jako „kolbe destylacyjno”. Small pomylił nazwę własną („Vigipedii”) i „naczynie”, które usłyszał jako „na czynie”. Medium popełnił jeden błąd na 96 słów, znów w tej samej nazwie Wikipedii. Polskie znaki diakrytyczne w small i medium ocalały wszystkie, a każdy z trzech modeli sam wstawiał interpunkcję i dzielił tekst na segmenty ze znacznikami czasu. Detekcja języka na obu nagraniach wskazała polski z pewnością 1,00, więc parametru language nie trzeba ustawiać sztywno.
Test podcastera: 16 minut i 53 sekundy
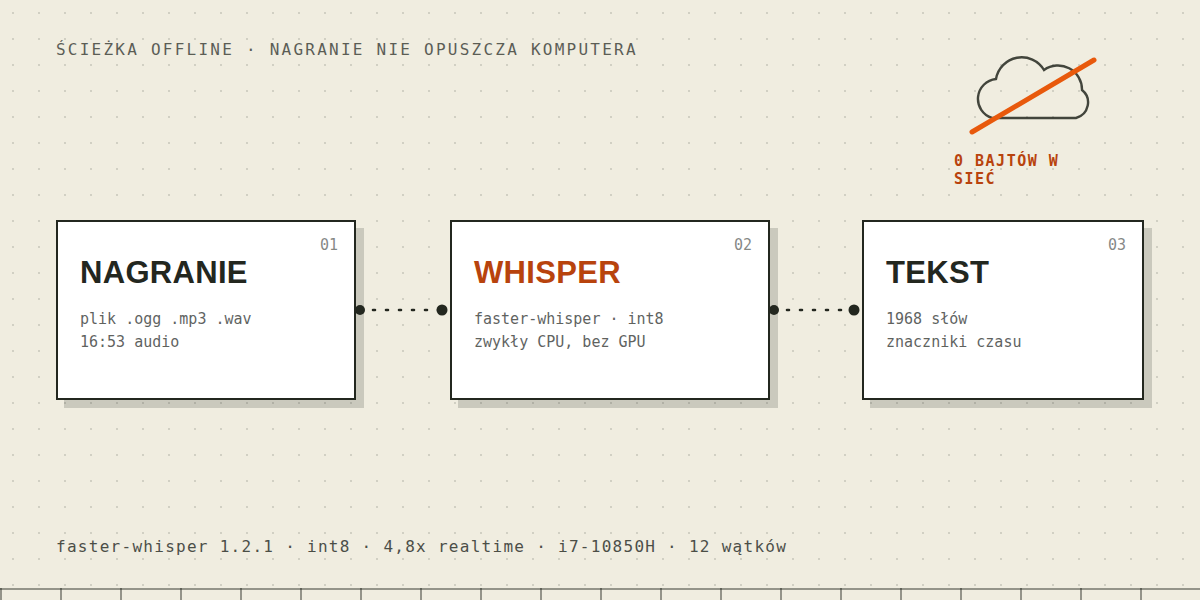
Druga próba to czytany artykuł o ustroju Australii: 1013 sekund nagrania, 1968 słów po przepisaniu. Model small przepisał je w 209,5 sekundy, czyli 3 minuty i 29 sekund, 4,8 raza szybciej niż trwa samo nagranie. Wyszło 302 segmenty ze znacznikami czasu, gotowe po drobnej poprawce na napisy pod filmem.
Tekst ciągły wyszedł czytelnie, z liczbami i datami bez pudła: „1 stycznia 1901 roku”, „senat liczy 76 członków”, „po 12 senatorów z każdego stanu”. Zgrzyty skupiły się tam, gdzie się spodziewało: w nazwach własnych i słowach trudnych. Tytuł „Ustrój polityczny Australii” wyszedł jako „Puszczuj polityczny Australii”, „Commonwealth of Australia” jako „Komodów o Wostrelia”, a „kadencja” i „reprezentantów” zamieniły się w „Redencję” i „prezentantów”. Po poprawieniu nazw własnych transkrypt nadawał się do dalszej pracy bez grzebania w reszcie.
Jedno zastrzeżenie: czytany artykuł to przyjazny materiał, jedna osoba czyta spokojnie, bez pogłosu. Spontaniczne spotkanie nagrane na laptopie będzie trudniejsze i częściej będzie potrzebowało ręcznej poprawki, zwłaszcza przy mówcach nachodzących na siebie.
Buzz: to samo bez terminala
Jeśli terminal odstrasza, jest Buzz: darmowa aplikacja z oknem dla Windows, macOS i Linuksa, budowana na Whisperrze, z ponad 21,8 tysiąca gwiazdek na GitHubie i rozwojem na żywo. Przyciągasz plik, wybierasz model, czekasz; praca dzieje się lokalnie, więc nagranie też nie opuszcza komputera. To ten sam Whisper co wyżej, tyle że zamiast wiersza poleceń dostajesz okno. A jeśli temat lokalnego AI cię wciąga, o uruchamianiu małych modeli językowych w przeglądarce pisaliśmy w poradniku o AI bez internetu.
Ściąga: która droga do czego
| Sytuacja | Droga | Koszt | Granica |
|---|---|---|---|
| Krótkie nagranie, jednorazowo | Gemini, plik w rozmowie | 0 zł | 10 minut audio na darmowym koncie |
| Własny materiał wideo | napisy na YouTube | 0 zł | tylko domyślny język filmu |
| Dyktowanie na żywo | Wpisywanie głosowe w Docs | 0 zł | nie przepisuje plików |
| Dłuższe albo poufne nagrania | Whisper offline (faster-whisper, Buzz) | 0 zł | wymaga instalacji, jakość zależy od modelu |
| Masz subskrypcję Microsoft 365 | Transkrybuj w Wordzie | w cenie M365 | 300 minut na miesiąc |
Nota uczciwości
Test przeprowadziliśmy sami: dwa nagrania czytanych artykułów ze Spoken Wikipedia, mono, bez pogłosu, to łatwiejszy materiał niż spontaniczna mowa, więc nasze liczby traktuj jako dolny próg trudności. Błędy liczyliśmy na oko, porównując transkrypt z tekstem artykułu, bez własnej metodologii WER; liczby WER w tekście pochodzą z paperu OpenAI i benchmarków twórców narzędzi. Limitów Gemini i Worda nie potwierdzaliśmy na żywych kontach, ścieżki opisujemy według oficjalnych stron Google i Microsoftu ze stanu na 2 października 2026.
Źródła
- Whisper, repozytorium OpenAI na GitHubie, tabela modeli i licencja MIT
- OpenAI: Robust Speech Recognition via Large-Scale Weak Supervision (arXiv 2212.04356), załączniki z WER dla polskiego, 2022
- SYSTRAN: faster-whisper, README z benchmarkiem CPU
- Google: Upload & analyze files in Gemini Apps, limity audio
- Google Blog: Gemini 3.5 Transcribe, 26.08.2026
- Microsoft: Transcribe your recordings, limity i języki
- YouTube: Use automatic captioning
- Google Docs: Type with your voice
- Buzz, repozytorium na GitHubie
- Nagrania testowe na Wikimedia Commons (Pl-Deflegmator-article.ogg oraz Pl-Ustroj polityczny Australii-article.ogg)