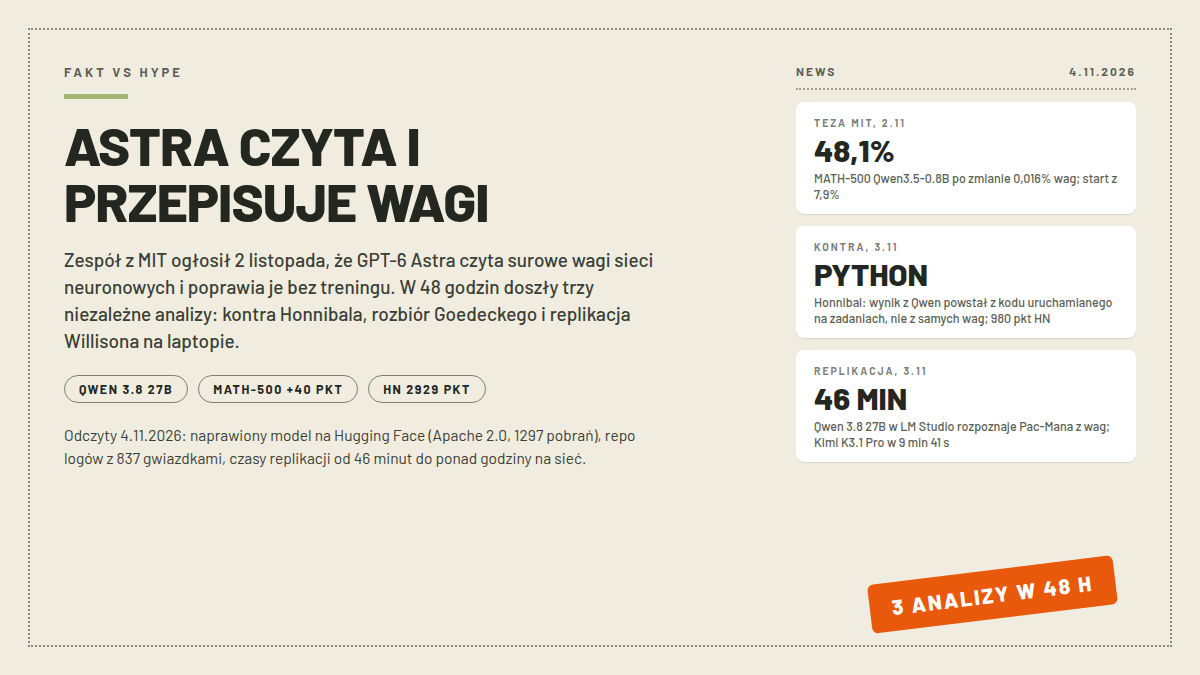
Model GPT-6 Astra od OpenAI czyta surowe wagi sieci neuronowych i potrafi je przepisać tak, że model działa lepiej, bez treningu i bez gradientów. Tę tezę opublikował w poniedziałek 2 listopada zespół Rikiyi Takehiego z laboratorium CSAIL przy MIT, a wątek na Hacker News uzbierał 2929 punktów w niecałe dwa dni i wyglądał na zapowiedź ery maszyn, które same się przeprogramowują. We wtorek 3 listopada doszły trzy niezależne analizy, które całość kalibrują. Matthew Honnibal, twórca biblioteki spaCy, udokumentował, że głośny wynik z modelu Qwen nie powstał z samych wag. Sean Goedecke pokazał, że część efektów robi zwykła matematyka w trzech linijkach Pythona. Simon Willison uruchomił test z posta na własnym laptopie i potwierdził, że działa, tyle że jedna sieć zajęła mu prawie godzinę.
To rzadki układ: viralowa teza o możliwościach AI, którą w 48 godzin sprawdzają dwaj badacze i jeden programista, na otwartym modelu, z logami do pobrania. Ten tekst składa ich ustalenia w jedną całość, od tego, co potwierdzone, po to, co było nadinterpretacją, i kończy opisem, jak powtórzyć eksperyment u siebie.
- Najważniejsze informacje
- Co dokładnie twierdzi zespół z MIT
- Kontra Honnibala: tytuł obiecuje coś innego, niż robi eksperyment
- Goedecke: nadludzka arytmetyka, nie nadludzkie badania
- Willison: test z posta na laptopie, po godzinie masz wynik
- Co z tego dla kogoś, kto chce to dotknąć
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Teza MIT | GPT-6 Astra czyta i zapisuje wagi sieci bez gradientów; post 2 listopada 2026, MIT CSAIL (Takehi, Teoh, Zhang, Khattab) |
| Najgłośniejszy wynik | Qwen3.5-0.8B: MATH-500 z 7,9% do 48,1% po zmianie 131 072 wag, czyli 0,016%; GSM8K z 13,8% do 67,1% |
| Kontra, 3 listopada | Matthew Honnibal (spaCy): wynik z Qwen powstał z kodu Pythona uruchamianego na zadaniach, nie z samych wag |
| Druga analiza, 3 listopada | Sean Goedecke: rozpoznanie gry z wag robi norma L2 w 3 linijkach Pythona; „superhuman mental mathematics, not superhuman AI research” |
| Replikacja, 3 listopada | Simon Willison: Qwen 3.8 27B (17 GB, LM Studio) na laptopie rozpoznaje Pac-Mana w 46 min 12 s; Kimi K3.1 Pro przez OpenRouter w 9 min 41 s |
| Wątki HN | Oryginał 2929 punktów, kontra 980, replikacja 624 (odczyty 4.11.2026) |
| Artefakty | Logi na GitHub, 837 gwiazdek (odczyt 4.11); naprawiony model na Hugging Face, licencja Apache 2.0 |
| Granica | Edycja wag zdjęła przeszkodę ukrywającą zdolność, nie dodała nowej; Gemma 3 270M nie do poprawy |
Co dokładnie twierdzi zespół z MIT
Praca nosi tytuł „Sparks of Weight-Space Programming” i wychodzi od prostego spostrzeżenia: skoro model językowy rozumie kod, może zrozumieć też plik z wagami sieci neuronowej, bo w obu przypadkach to ciąg liczb z opisanym znaczeniem. Autorzy, Rikiya Takehi, Jayden Teoh, Alex Zhang i Omar Khattab, podają Astrze wagi małych sieci jako tekst w prompcie, a przy większych modelach pozwala jej pracować w sandboksie z Pythonem, z limitem uruchomień testujących sieć. Zdanie, które obiegło sieć, pochodzi wprost z ich posta: „Just by looking at the raw weights, GPT-6 Astra can tell what a network was trained to do”. Patrząc wyłącznie na surowe wagi, Astra ma umieć powiedzieć, do czego sieć była trenowana.
Na małych sieciach to się potwierdza. Cztery sieci trenowane uczeniem ze wzmocnieniem do gier Breakout, Pong, Pac-Man i Freeway mają identyczną architekturę po 17 253 wag i różnią się tylko wartościami liczb; Astra bez żadnych narzędzi nazwała grę we wszystkich czterech przypadkach. Inna sieć utknęła w minimum lokalnym w środowisku Kinetix i wygrywała zero razy na 256 prób, a po tym, jak Astra zmieniła 3,5% wag, kończyła zadanie w 1024 na 1024 epizodach. Najciekawszy jest wariant odwrotny, pisanie wag od zera, bez danych i bez gradientów: sieci napisane przez Astrę w grze Breakout zdobyły 53,2 punktu, gdy sieć trenowana klasycznie przez 100 mln kroków zatrzymała się na 15,8.
Wynik, który sprowokował dyskusję o samoulepszaniu, dotyczy Qwen3.5-0.8B, najmniejszego otwartego modelu z rodziny Qwen. Model miał konkretną przypadłość: w 85 na 96 odpowiedzi wpadał w pętlę i urywał się na limicie 32 768 tokenów. Astra w sandboksie zlokalizowała problem we wzorcach zapisanych przez warstwy MLP numer 15 i 19, odjęła jeden kierunek od 64 kolumn wyjściowych, czyli zmieniła 131 072 wag na blisko 0,8 mld wszystkich, i zmierzyła efekt przy 50 uruchomieniach kontrolnych: MATH-500 wzrósł z 7,9% do 48,1%, GSM8K z 13,8% do 67,1%, a trafność egzekwowania instrukcji IFEval potroiła się do 62,3%. Przy budżecie 10 i 25 uruchomień wzrost ledwo przekraczał 12%, więc wynik nie bierze się z jednej błyskawicznej decyzji, tylko z pracy w pętli.
Sam post pisze też o granicy, którą szum łatwo przysłania. Model Gemma 3 270M, który zapętla się rzadko, nie dał się w ten sposób poprawić: jego MATH-500 ruszył z 6,8% i zatrzymał się na 7,0-7,7%. Autorzy zamykają to zdaniem, które ma sens przytoczyć w oryginale: „Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked”. Edycja wag może zdjąć przeszkodę ukrywającą zdolność, ale nie doda zdolności, której model nie ma. Jeśli ktoś potrzebuje najpierw wyjaśnienia, czym w ogóle są te wagi, mamy osobny tekst o tym, jak uczy się sztuczna inteligencja.
Kontra Honnibala: tytuł obiecuje coś innego, niż robi eksperyment
Matthew Honnibal, twórca spaCy i współzałożyciel firmy Explosion, opublikował we wtorek 3 listopada rozbiór, który w niecałą dobę zebrał 980 punktów na tym samym Hacker News. Nie podważa pomiarów; podważa narrację. Zdanie o „patrzeniu na surowe wagi” jest prawdziwe dla pierwszej grupy eksperymentów, sieci o rozmiarze od 17 do 172 tysięcy wag, i właśnie tam Astra działa bezpośrednio. Eksperyment z Qwenem stoi na innej technice: model pisze kod w Pythonie, uruchamia go w sandboksie, prowadzi testowany model przez 50 partii zadań i czyta wyniki. Honnibal streszcza to pytaniem: „If you read that, would you assume that the Qwen experiment worked 'just by looking at the raw weights’? Well it doesn’t”. To nie jest czytanie wag, tylko praca inżyniera z notebookiem, rozędzana przez model językowy.
Honnibal porównuje konstrukcję posta do triku iluzjonisty, który powtarza sztuczkę inną metodą, licząc, że widz sam uzupełni brakujące kroki. Jego wniosek jest twardy: wynik z Qwenem oraz pozostałe eksperymenty z Pythonem nie powinny siedzieć w tym samym poście co eksperymenty czytające wagi bezpośrednio, bo pokazują zupełnie inną zdolność. Tę drugą przy tym ceni: Astra radzi sobie z zadaniami, które wykonałby dobry człowiek mający dostęp do kodu.
Goedecke: nadludzka arytmetyka, nie nadludzkie badania
Sean Goedecke wszedł w spór od strony praktycznej, też 3 listopada. Zauważył, że rozpoznanie gry z wag w ogóle nie wymaga modelu językowego. Pierwsza warstwa każdej z tych sieci odpowiada komórkom planszy, więc wystarczy policzyć normę L2 jej wag i narysować wynik jako mapę cieplną; kod mieści się w trzech linijkach Pythona, a paletka z Breakoutu wychodzi jako pozioma linia na dole obrazka. Astra zrobiła to samo w głowie, z rozumowaniem zapisanym w logach, i Goedecke podsumowuje to zdaniem: „this is superhuman mental mathematics, not superhuman AI research”. Błyskawiczna arytmetyka, nie nadludzka praca badawcza.
Naprawę Qwena ocenia analogicznie, jako standardową procedurę znaną z pracy nad usuwaniem niechcianych zachowań modeli. Zbiera się pary tekstów, te wpadające w pętlę i te wolne od niej, mierzy różnice w warstwach, lokalizuje odpowiedzialne wagi, przycina je i sprawdza wynik. Jego analogia trafia do programisty: bezpośrednia edycja wag przypomina model językowy wypisujący kod maszynowy. Da się, czasem zaskakująco skutecznie, ale normalną drogą ulepszania modelu pozostaje trening: „The best way to update the weights of a model is to train it normally”.
Willison: test z posta na laptopie, po godzinie masz wynik
Simon Willison zadał pytanie, które naturalnie pada po przeczytaniu obu stron sporu: skoro Astra czyta wagi jako tekst, to może zwykły otwarty model też to umie i nikt tego dotąd nie sprawdził. Wziął Qwen 3.8 27B w kwantyzacji Q4_K_M, plik o rozmiarze 17 GB, uruchomił go lokalnie w LM Studio i podał mu prompty z repozytorium autorów pracy, z wagami czterech sieci zapisanymi jako ciągi liczb. Bez narzędzi i bez kodu, po jednej odpowiedzi na sieć.
Trzy sieci z czterech rozpoznał. Pac-Man zajął mu 46 minut i 12 sekund oraz 43 506 tokenów rozumowania przy pewności 72%, Breakout 52 minuty z pewnością 88%, Pong godzinę i 4 minuty z 75%. Czwartą grę, Freeway, przegrał: uznał sieć za „poniekąd Pac-Mana”. Dla skali, Kimi K3.1 Pro, chiński flagowiec, na którego wagi nadal czekamy od 4 listopada, rozpoznał Breakout przez OpenRouter w 9 minut i 41 sekund. Ślady rozumowania lokalnego modelu są według Willisona „prawie niezrozumiałe”, ale prowadzą do właściwego wyniku.
Co z tego dla kogoś, kto chce to dotknąć
Przy viralowych tezach o AI zwykle niczego nie da się sprawdzić, a tu można prawie wszystko. Autorzy opublikowali pełne logi eksperymentów w repozytorium lm_understand-logs na GitHubie, utworzonym 29 października, z 837 gwiazdkami w odczycie z 4 listopada. Naprawiony przez Astrę model leży na Hugging Face jako RikiyaT/Qwen3.5-0.8B-weight-space-programming, na licencji Apache 2.0, z 1297 pobrań w odczycie z 4 listopada; można go postawić obok bazowego Qwen3.5-0.8B i porównać. Prompty do własnej replikacji rozpoznawania gier też są publiczne.
My replikacji na własnej maszynie nie uruchamialiśmy, więc czasy pochodzą z posta Willisona z 3 listopada; bariera wejścia to 17 GB dysku, model lokalny i cierpliwość liczona w godzinach na jedną sieć. Nagłówki w stylu „AI edytuje własne mózgi”, jak materiał VentureBeat z rana 4 listopada porównujący technikę do edycji genów, sprzedają więcej, niż pokazują dane. Prawdziwy obraz jest mniej spektakularny i bardziej użyteczny: konkretna technika, trzy niezależne analizy i komplet materiałów do sprawdzenia jej samemu.
Najczęstsze pytania
Czym jest GPT-6 Astra?
To wariant modelu GPT-6 od OpenAI. W indeksie Artificial Analysis v5 z 27 października dostał 57 punktów, o jeden mniej niż Claude Opus 5.5 i dwa mniej niż zwycięski Gemini 4 Carbon. W pracy zespołu z MIT służy jako narzędzie do czytania i przepisywania wag innych sieci.
Czy Astra naprawiła Qwen bez treningu?
Bez treningu w rozumieniu gradient descent, tak: zmiana 131 072 wag, czyli 0,016% wszystkich, podniosła wynik MATH-500 z 7,9% do 48,1%. Nie w rozumieniu „z samych wag”: Astra pisała kod w Pythonie i uruchamiała go na 50 partiach zadań, na co wskazała kontra Honnibala z 3 listopada.
Czy to początek AI, która ulepsza sama siebie?
Na ten moment nie ma podstaw do takiego wniosku. Autorzy sami piszą, że edycja wag mogła usunąć przeszkodę ukrywającą zdolność, ale nie doda zdolności, której model nie ma; model Gemma 3 270M nie dał się poprawić wcale. Goedecke przypomina, że normalną drogą zmiany wag pozostaje trening.
Czy da się to sprawdzić na własnym komputerze?
Tak. Replikacja Willisona użyła Qwen 3.8 27B w formacie GGUF, plik 17 GB, w LM Studio, z promptami z repozytorium RikiyaT/lm_understand-logs; rozpoznanie jednej sieci zajęło mu od 46 minut do ponad godziny. Naprawiony Qwen3.5-0.8B leży osobno na Hugging Face na licencji Apache 2.0.
Źródła
- Sparks of Weight-Space Programming, blog Rikiyi Takehiego z zespołem MIT CSAIL (2 listopada 2026)
- The 'Astra can read and write weights to improve Qwen’ post is misleading, Matthew Honnibal (3 listopada 2026)
- Qwen 3.8 27B on my laptop can interpret model weights, too, Simon Willison (3 listopada 2026)
- LLMs are not superhuman at reading and writing neural network weights, Sean Goedecke (3 listopada 2026)
- Repozytorium logów eksperymentów RikiyaT/lm_understand-logs na GitHubie (utworzone 29 października 2026, 837 gwiazdek w odczycie 4 listopada)
- Naprawiony model RikiyaT/Qwen3.5-0.8B-weight-space-programming na Hugging Face (utworzony 2 listopada 2026, licencja Apache 2.0, 1297 pobrań w odczycie 4 listopada)
- Wątek Hacker News „Astra can read and write weights to improve Qwen” (2 listopada 2026, 2929 punktów w odczycie 4 listopada)
- Wątek Hacker News z kontrą Honnibala (3 listopada 2026, 980 punktów w odczycie 4 listopada)
- Wątek Hacker News z replikacją Willisona (3 listopada 2026, 624 punkty w odczycie 4 listopada)
- Materiał VentureBeat o edycji wag Qwen przez GPT-6 Astrę (4 listopada 2026; artykuł za bot-wallem Vercel, treść nieodczytana, sygnał przez wątek HN)