Pytanie „embedding co to” pojawia się w dokumentacjach, ogłoszeniach o pracę i ustawieniach aplikacji, a pod angielskim słowem kryje się rzecz przydatna każdemu, kto ma na dysku setki notatek i dokumentów: sposób zapisania znaczenia tekstu w liczbach, ułożony tak, że komputer potrafi porównywać sensy zamiast liter. Tłumaczę to tu bez wzorów i wykresów, na przykładzie szukania we własnych notatkach, a ceny i limity biorę z dokumentacji OpenAI i Google, z odczytem z 14 października 2026. Tekst jest częścią przewodnika dla początkujących, całość trzyma strona Podstawy AI: 30 pytań i odpowiedzi.
- Najważniejsze informacje
- Szukanie po znaczeniu, nie po słowach
- Embedding na twoich notatkach, krok po kroku
- RAG po ludzku: czat, który najpierw czyta twoje dokumenty
- Podobne obrazy i pozostałe zastosowania
- Ile to kosztuje i co dzieje się z twoimi danymi
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Definicja | Opis znaczenia kawałka tekstu zapisany liczbami; zbliżone sensy dostają zbliżone opisy |
| Po polsku | osadzenie; liczba mnoga: embeddingi albo osadzenia |
| Historia | „Słowo poznajesz po towarzystwie”, Firth, 1957; word2vec, Google, 2013 |
| Modele osadzeń | text-embedding-3-small i 3-large (OpenAI), gemini-embedding-2 (Google) |
| Ceny API | 0,02 USD za milion tokenów (OpenAI 3-small), 0,20 USD (gemini-embedding-2) |
| Darmowa droga | Warstwa darmowa Gemini API: osadzenia bez opłat |
| Zastosowania | szukanie w notatkach i dokumentach, RAG, rekomendacje, podobne obrazy |
Szukanie po znaczeniu, nie po słowach
Wyszukiwanie znane z edytora tekstu jest ślepe na sens. Ctrl+F znajdzie „podatek” wtedy i tylko wtedy, gdy to słowo dosłownie stoi w pliku; pytanie o zwrot nadpłaconego podatku i notatka o rozliczaniu niemieckich dochodów mogą nie mieć wspólnej litery, choć mówią o tym samym. Wielkie wyszukiwarki internetowe poradziły sobie z tym lata temu, a teraz to samo schodzi do aplikacji, czatów i firmowych baz dokumentów. Embedding jest nazwą tej sztuczki.
Sam pomysł jest starszy niż komputery, na których go policzono. Językoznawca John Rupert Firth zapisał w 1957 roku myśl, którą Wikipedia oddaje jako „słowo charakteryzuje towarzystwo, w którym się pojawia”: znaczenie poznajesz po otoczeniu. Modele językowe robią to samo w skali miliardów zdań, notując, które słowa łapią podobne konteksty. „Pies” i „kot” występują w zbliżonych zdaniach, „pies” i „arkusz kalkulacyjny” prawie nigdy. W 2013 roku zespół Tomasa Mikolova w Google zamienił tę obserwację w praktyczne narzędzie word2vec, a od czasów modeli typu BERT mechanizm objął całe zdania i akapity, nie pojedyncze słowa.
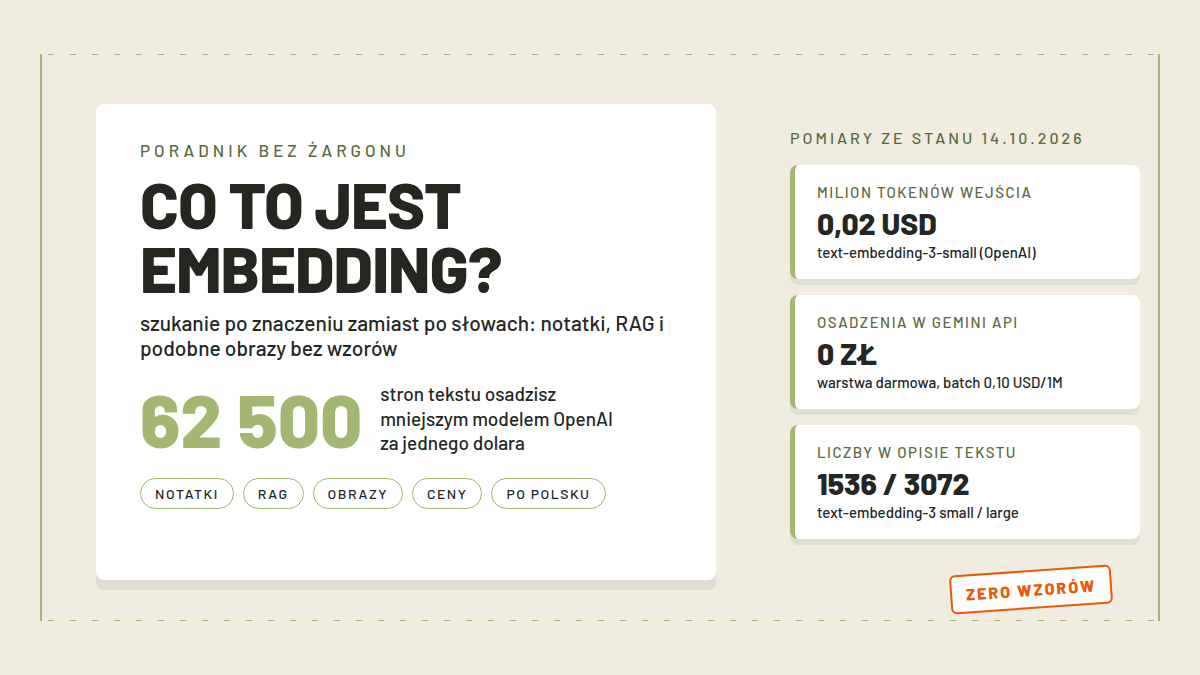
Dzieje się to tak: model osadzeń czyta kawałek tekstu i wypisuje jego opis, długi ciąg liczb streszczający, co dany tekst znaczy. U OpenAI domyślnie 1536 liczb dla mniejszego modelu i 3072 dla większego, w gemini-embedding-2 również 3072. Zasada jest jedna: teksty o zbliżonym znaczeniu dostają zbliżone opisy, a dokumentacja OpenAI formułuje to krótko, mała odległość między opisami oznacza duże pokrewieństwo treści. Gdy program porówna dwa opisy, dostaje jedną liczbę mówiącą, jak blisko leżą ich sensy. W dokumentacjach spotkasz nazwę podobieństwo kosinusowe; to techniczna etykieta sposobu mierzenia tej odległości i do korzystania z osadzeń nie jest ci potrzebna.
Pytanie i notatka nie muszą mieć ani jednego wspólnego słowa, żeby się dopasować. Liczą się znaczenia, a te już zostały porównane.
Embedding na twoich notatkach, krok po kroku
Zanim cokolwiek znajdziesz, program musi przejść po twoich plikach i pociąć każdą notatkę na kawałki wielkości akapitu albo sekcji, bo model ma limit długości: 8192 tokenów naraz w modelach osadzeń OpenAI i w gemini-embedding-2, 2048 tokenów w starszym gemini-embedding-001. Dokumentacja OpenAI przyjmuje, że strona tekstu to około 800 tokenów, więc najdłuższy limit mieści w jednym kawałku z grubsza dziesięć stron; dłużej trzeba ciąć. Każdy kawałek leci do modelu, wraca z opisem liczbowym, a program odkłada go w bazie razem ze ścieżką do pliku i tytułem notatki. To robota jednokrotna, powtarzana dopiero przy dodaniu albo zmianie pliku.
Od tego momentu szukanie jest proste. Wpisujesz pytanie naturalnym językiem, na przykład „co robiłem z wnioskiem o zwrot”, pytanie przechodzi przez ten sam model, a program porównuje jego opis z opisami wszystkich kawałków i sortuje od najbliższego. Zapytanie o nadpłacony podatek wyciągnie notatkę o niemieckim rozliczeniu rocznym, w której słowo „podatek” nigdzie nie pada, bo opisy znaczeń się zgadzają, choć słownictwo nie. Tego nie mierzyłem na swoim dysku, opisuję mechanikę z dokumentacji; efekt w postaci trafień bez wspólnych słów jest z definicji tego, po co się osadzeń używa.
Przy setkach kawałków program po prostu porównuje opisy po kolei. Przy milionach dokumentacja OpenAI radzi sięgnąć po bazę budowaną specjalnie do szybkiego szukania najbliższych opisów, bo liniowe przeglądanie wszystkiego przestaje nadążać.
Gotowe produkty mają to wbudowane: firmowe wyszukiwarki w dokumentach, aplikacje do notatek z wyszukiwaniem semantycznym, usługi indeksowania repozytoriów kodu. Programista dobije się do tego przez API producenta, każdy inny przez aplikację, która osadzenia ma pod maską. Drobiazg z dokumentacji OpenAI, który potrafi zaskoczyć: modele serii 3 nie znają wydarzeń po wrześniu 2021 roku, więc nazwy i słownictwo, które narodziły się później, opisują gorzej niż te z ich epoki treningu.
RAG po ludzku: czat, który najpierw czyta twoje dokumenty
Skrót RAG rozwija się jako retrieval augmented generation, po polsku mówi się o generowaniu wspartym wyszukiwaniem. Amazon Web Services definiuje to jako optymalizowanie odpowiedzi dużego modelu tak, żeby opierał się na wskazanej bazie wiedzy zamiast na samym materiale treningowym, i to bez douczania modelu. Nazwa jest mniej ważna niż mechanika, a mechanika to notatnikowy przykład z poprzedniej sekcji plus jeden krok na końcu.
Najpierw ktoś przygotowuje bazę: dokumenty firmy, instrukcje i umowy przechodzą przez model osadzeń, a ich opisy liczbowe lądują w bazie zbudowanej specjalnie do przechowywania i porównywania takich opisów. Gdy przychodzi pytanie, system zamienia je na opis, wybiera z bazy najbliższe fragmenty i dokleja je do zapytania skierowanego do czatu. Model odpowiada, mając przed sobą właściwe ustępy, i może podać źródło, bo wie, z czego skorzystał. Na końcu dokumenty trzeba odświeżać, równolegle do pracy systemu, i to wszystko; AWS opisuje ten cykl czterema krokami od tworzenia bazy po jej aktualizację.
Konstrukcja łata trzy słabości dużych modeli naraz. Wiedza z treningu się kończy, a baza żyje i przyjmuje nowe dokumenty każdego dnia. Model bez źródeł zmyśla z pełnym przekonaniem, a model z RAG cytuje fragmenty, które możesz sprawdzić sam. Trzecia sprawa to pieniądze: douczanie dużego modelu kosztuje majątek, a przepuszczenie dokumentów przez model osadzeń rozliczany w groszach za tysiące stron. AWS dopisuje czwartą zaletę, kontrolę: do bazy trafiają tylko wybrane dokumenty, a wrażliwe treści da się ogrodzić poziomami uprawnień.
AWS porównuje model bez dostępu do wiedzy zewnętrznej do pewnego siebie pracownika, który nie czyta bieżących wiadomości; jego przykładowy bot kadrowy na pytanie o wymiar urlopu odpowiada z polityki firmy i z rekordu konkretnego pracownika, a wyszukiwanie semantyczne na pytanie o zeszłoroczne wydatki na naprawy maszyn zwraca właściwy fragment raportu zamiast listy plików o podobnych nazwach. Czaty, które opisaliśmy w przewodniku o darmowym chatbocie, po podpięciu plików użytkownika wykonują dokładnie ten cykl, choć producent nie zawsze chwali się tym skrótem.
Podobne obrazy i pozostałe zastosowania
Tekst nie jest jedynym materiałem do osadzania. Dokumentacja Gemini wymienia gemini-embedding-2 jako pierwszy model osadzeń multimodalnych w tym API: przyjmuje tekst, obrazy (do sześciu na zapytanie), pliki audio (do 180 sekund), wideo (do 120 sekund) i dokumenty PDF (do sześciu stron, każda liczona jako 258 tokenów). Zasada zostaje ta sama, więc przycisk „znajdź podobne” w galerii czy sklepie porównuje opisy liczbowe obrazów tak samo, jak wyszukiwarka notatek porównuje opisy akapitów.
Dokumentacja OpenAI wylicza zastosowania sucho: wyszukiwanie, grupowanie, rekomendacje, wykrywanie anomalii, mierzenie różnorodności, klasyfikacja. Rozpisane na ludzkie sytuacje: sklep podpowiada produkty podobne do oglądanego, serwis porządkuje setki zgłoszeń w tematy bez ręcznego tagowania, system podnosi alarm, gdy nowe zgłoszenie odstaje od wszystkiego, co dotąd widział, a filtr antyspamowy sortuje wiadomości po sensie, nie po liście słów, którą spamer łatwo ominie. Jest tam też wyszukiwanie w kodzie: pytanie opisane po angielsku znajduje funkcję w repozytorium, nawet gdy jej nazwa pochodzi z zupełnie innego słownika. Starszy model Google, gemini-embedding-001, dostaje zresztą osobne tryby zadaniowe, osobny dla pytania i osobny dla dokumentu, bo te dwa rodzaje tekstu opłaca się liczyć odrobinę inaczej; swoje tryby mają też klasyfikacja, grupowanie i sprawdzanie faktów.
Na tej samej zasadzie działa deduplikacja zdjęć w chmurze i szukanie nagrań głosowych po treści rozmowy, bo audio też się osadza.
Ile to kosztuje i co dzieje się z twoimi danymi
Ceny osadzeń są niskie na tle reszty oferty AI. Cennik OpenAI liczy 0,02 USD za milion tokenów wejścia w text-embedding-3-small i 0,13 USD w text-embedding-3-large; Google bierze 0,20 USD za milion tokenów tekstu w gemini-embedding-2, a w trybie batch połowę tego. Obraz w gemini-embedding-2 wyceniono na 0,45 USD za milion tokenów, czyli 0,00012 USD za sztukę. Żeby to poczuć: przewodnik OpenAI szacuje, że za jednego dolara przełożysz mniejszym modelem około 62 500 stron, większym około 9 615, przy ich założeniu 800 tokenów na stronę. Przy takich stawkach osadzenie całej prywatnej biblioteki notatek to wydatek liczony w groszach, a raczej ułamkach grosza.
Da się też za zero złotych. Warstwa darmowa Gemini API wycenia osadzenia jako bezpłatne, z jednym zastrzeżeniem z cennika: treści przetworzone w warstwie darmowej Google może wykorzystywać do ulepszania swoich produktów, a w warstwie płatnej nie. OpenAI w przewodniku o osadzeniach pisze wprost, że klient pozostaje właścicielem tego, co wysłał i co dostał, łącznie z samymi opisami liczbowymi. Dokumentacja to jedno, a twoje notatki to drugie, więc przy plikach, których nie chcesz nikomu pokazywać, zostaje trzeci kierunek: modele osadzeń open source policzone na własnym komputerze, o czym piszemy w przewodniku o lokalnym AI, i wtedy żadna liczba nie opuszcza twojego dysku.
Jeszcze jedna rzecz przy wyborze modelu, z dokumentacji Google: opisy liczbowe różnych modeli nie są wymienne, bo każdy liczy w swoim własnym układzie znaczeń. Zmiana modelu osadzeń oznacza przeliczenie całej bazy od zera, co przy groszowych cenach boli mniej, niż brzmi.
Najczęstsze pytania
Embedding co to jest w prostych słowach?
To opis znaczenia kawałka tekstu zapisany jako długi ciąg liczb, wyliczony przez wyszkolony model. Zbliżone znaczenia dostają zbliżone opisy, więc program potrafi porównywać sensy: pytanie i dokument nie muszą mieć wspólnego słowa, a mimo to pasują.
Do czego służy embedding model?
Do zadań opartych na podobieństwie znaczeń: wyszukiwania w dokumentach i notatkach, rekomendacji, grupowania i klasyfikacji tekstów, wykrywania anomalii, szukania podobnych obrazów. Pod maską RAG odpowiada za znalezienie fragmentów, na których czat opiera odpowiedź.
Czym jest RAG po ludzku?
To czat, który przed odpowiedzią wyszukuje w twoich dokumentach fragmenty dopasowane do pytania po znaczeniu, dokleja je do zapytania i dopiero wtedy pisze, z możliwością podania źródła. Dokumenty odświeża się obok, bez ponownego treningu modelu.
Czy embeddingi działają po polsku?
Dokumentacja Gemini deklaruje obsługę ponad 100 języków w gemini-embedding-2; OpenAI listy języków dla serii 3 nie podaje. Własnych pomiarów jakości po polsku nie wykonaliśmy, więc nie zgadujemy: skoro osadzenia porównują znaczenia, polskie notatki szuka się polskimi pytaniami z synonimami.
Czy korzystanie z embeddingów jest płatne?
Może być darmowe albo kosztować grosze. Warstwa darmowa Gemini API liczy osadzenia bez opłat; w API płatnym OpenAI bierze 0,02 USD za milion tokenów wejścia w text-embedding-3-small, a Google 0,20 USD za milion w gemini-embedding-2. Milion tokenów to przy szacunku OpenAI grubo ponad tysiąc stron tekstu.
Źródła
- Embeddings, przewodnik API OpenAI: https://developers.openai.com/api/docs/guides/embeddings
- Cennik API OpenAI, modele osadzeń: https://developers.openai.com/api/docs/pricing
- Embeddings, dokumentacja Gemini API, Google: https://ai.google.dev/gemini-api/docs/embeddings
- Cennik Gemini API, Google: https://ai.google.dev/gemini-api/docs/pricing
- What is Retrieval-Augmented Generation?, Amazon Web Services: https://aws.amazon.com/what-is/retrieval-augmented-generation/
- Word embedding, Wikipedia (EN): https://en.wikipedia.org/wiki/Word_embedding