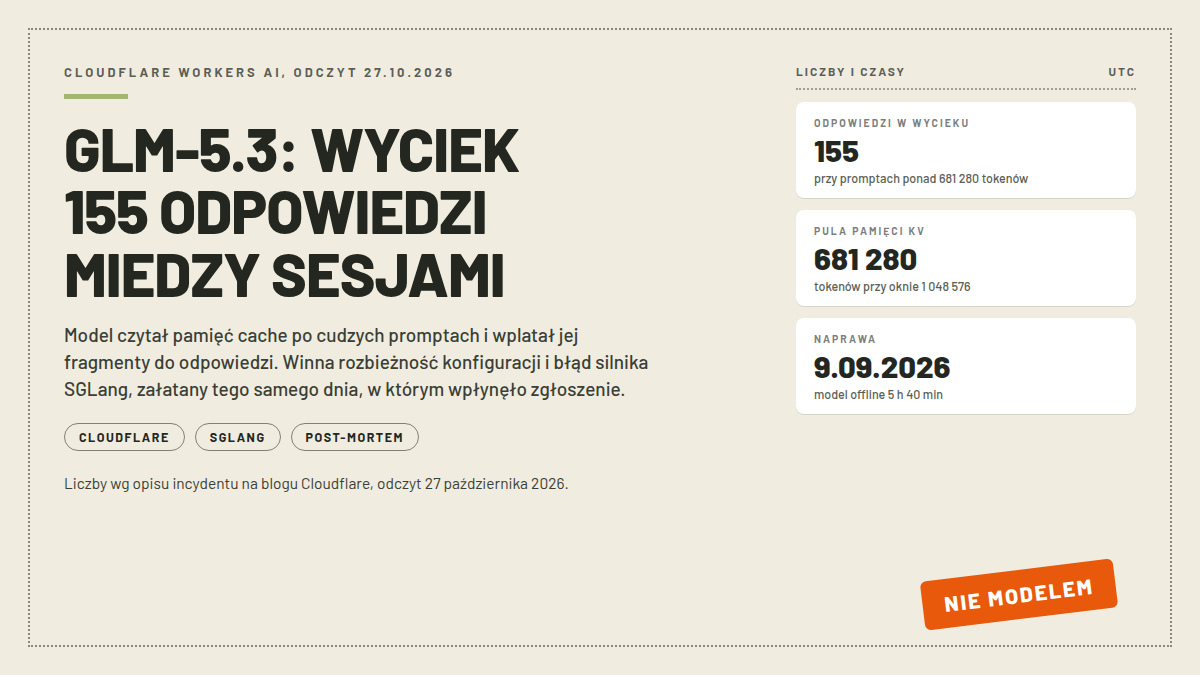
26 października 2026 Cloudflare opublikowało opis incydentu, który przez dwa tygodnie września dotyczył modelu GLM-5.3 uruchamianego w serwisie Workers AI. Łącznie 155 odpowiedzi zawierało fragmenty danych z sesji innych użytkowników: silnik inferencji brał gotowe strony pamięci cache, na których wciąż leżały wyniki poprzednich zapytań, i dokładał do nich odpowiedź dla nowego klienta. Model wyłączono tego samego dnia, w którym napłynęło zgłoszenie, a naprawiona wersja wróciła do serwisu wieczorem 9 września, na siedem tygodni przed publicznym opisem całej sprawy.
Ta luka w czasie nie jest przypadekiem: Cloudflare skoordynowało publikację z twórcami silnika SGLang, żeby najpierw trafiły do niego poprawki. Dla praktyka najciekawsze w tym incydencie jest to, że nie chodziło o złamanie szyfrowania ani o atak. Wystarczyło, że jeden parametr konfiguracji nie zgadzał się z drugim, a silnik zamiast zgłosić błąd po cichu dorabiał sobie brakujące dane. Zgłoszenie przyszło przez HackerOne od Gadia Evrona z firmy Knostic.
- Najważniejsze informacje
- Co dokładnie pękło
- Oś czasu incydentu
- Kto był narażony i co wiadomo o skutkach
- Co mówią na Hacker News
- Co to znaczy dla self-hostingu i dla Polski
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Serwis | Workers AI, endpoint modelu GLM-5.3; żaden inny model na platformie nie był dotknięty |
| Skala | 155 odpowiedzi z treścią z cudzych sesji; wszystkie przy promptach powyżej 681 280 tokenów |
| Przyczyna 1 | pula pamięci KV na GPU prefill mieściła 681 280 tokenów, a model reklamowano z oknem 1 048 576 |
| Przyczyna 2 | błąd SGLang w trybie rozdzielonym prefill/decode: prompt ponad pulę zastępowano jednym tokenem zastępczym bez błędu do klienta |
| Odkrywca | Gadi Evron (Knostic), zgłoszenie HackerOne 8 września o 23:11 UTC |
| Naprawa | model prywatny 9 września o 14:00, powrót z poprawką 19:40 UTC tego samego dnia |
| Publikacja | 26 października 2026, po wydaniu poprawek SGLang w wersjach od v0.5.20 do v0.5.22 |
| CVE | brak numeru CVE; opisana jest seria poprawek w repozytorium SGLang, m.in. PR #36988 i #38935 |
Co dokładnie pękło
Model GLM-5.3 oferuje okno kontekstowe o rozmiarze 1 048 576 tokenów i dokładnie tak był skonfigurowany w serwisie. Pula pamięci KV, czyli roboczej pamięci, w której silnik trzyma skróty obliczeń dla wczytanego promptu, mieściła na GPU prefill tylko 681 280 tokenów. Cloudflare pisze wprost, że znało tę rozbieżność przed startem, ale zakładało, że silnik zwróci błąd dla każdego promptu, którego nie da się obsłużyć. Testy długiego kontekstu kończyły się poprawnymi odpowiedziami, więc uznano to za bezpieczne.
Zakładanie okazało się błędne z powodu drugiego elementu: SGLang w trybie, w którym prefill i dekodowanie działają na osobnych węzłach. Gdy prompt był dłuższy niż pula, silnik wewnętrznie go odrzucał i podstawiał jeden token zastępczy, po czym wysyłał wynik prefillu do węzła dekodującego. Ten sądził, że dostał pełny obraz promptu, a w rzeczywistości większość stron pamięci zawierała resztki poprzednich zapytań innych użytkowników. Model czytał te śmieci jako kontekst i czasem wplatał je do odpowiedzi. Nie było błędu, ostrzeżenia ani żadnego sygnału, że coś poszło nie tak, poza treścią, która nie miała prawa tam być.
Oś czasu incydentu
Wszystkie czasy w UTC. Błąd siedział w konfiguracji od startu modelu na platformie, ale jego skutki ujawniły się dopiero, gdy ktoś wysłał prompt dłuższy niż pula pamięci.
| Data | Zdarzenie |
|---|---|
| 27.08.2026 | start GLM-5.3 na Workers AI z błędną konfiguracją |
| 08.09 23:11 | zgłoszenie od Knostic przez HackerOne |
| 09.09 13:22 | Cloudflare potwierdza incydent, reprodukcja zajmuje 25 minut |
| 09.09 14:00 | endpoint modelu przełączony na prywatny, żądania dostają HTTP 400 |
| 09.09 19:40 | model wraca publicznie z poprawioną konfiguracją i poprawką silnika |
| 10.10 | spotkanie z utrzymującymi SGLang (RadixArk), start napraw w silniku |
| 26.10 | skoordynowana publikacja opisu i poprawek |
Kto był narażony i co wiadomo o skutkach
Warunek był jeden: prompt dłuższy niż 681 280 tokenów, czyli blisko milion znaków tekstu. To wyklucza zwykłe rozmowy, a wskazuje zadania typu wrzucenie całej dokumentacji albo dużego repozytorium w jedno żądanie. Cloudflare potwierdza 155 odpowiedzi z cudzą treścią i pisze, że wzorce użycia zgadzają się z normalną, długokontekstową pracą, bez śladów celowej eksploatacji. Nie znamy liczby dotkniętych kont, bo platforma nie podała tego w opisie, i taki brak danych trzeba tu zapisać wprost.
Osobna sprawa to tytuł całej sprawy. Wątek na Hacker News rozszarpał sformułowanie „cross-request KV cache exposure in the GLM-5.3 Workers AI model”, bo sugeruje defekt modelu, a model nie ma tu nic do rzeczy. Komentarz broniący tytułu („We name the model in the title because our customers need to know which of our endpoints was affected”) zdradza perspektywę strony Cloudflare, a inny użytkownik odpowiada propozycją uczciwszego nagłówka: „Cloudflare configuration error leaked data between user sessions”. Po treści: owszem, winę ponosi konfiguracja i silnik, nie wagi modelu.
Co mówią na Hacker News
Dyskusja pod opisem (105 punktów i 35 komentarzy na odczyt 27.10 rano) jest zaskakująco konstruktywna jak na temat bezpieczeństwa. Komentarz segmondego wyciątuje z bloga zdanie „We were aware of this mismatch before launch” i pyta: czy reklamowali okno miliona tokenów, mając na nie miejsce na 681 tysięcy? Odpowiedź z bloga, że testy długiego kontekstu „returned successful responses, so we did not believe this to be an issue”, wywołuje konsternację: test sprawdzał tylko, czy odpowiedź przyjdzie, a ona przychodziła, bo treścią domykała ją cudza pamięć.
Najciekawszy wątek dotyczy szerszej lekcji: „Other providers probably don’t even know/care that this is happening” (thehamkercat) i obserwacja 0xbadcafebee, że przy współdzieleniu sprzętu między klientami klasy ataków na wspólne cache istniały od zawsze, a nikt nie ma prawa zakładać, że dostawca magicznie izoluje tokeny. Pojawiają się też anegdoty o dostaniu cudzej odpowiedzi w popularnych API, u ChatGPT i u Anthropic, jednorazowe i niepotwierdzone, więc traktuję je wyłącznie jako anegdoty. Na pochwałę zasłużyło rzetelne post-mortem: „I like this RCA a lot more than most. I appreciate the ownership and clear explanation of why their testing did not catch this bug” (kami23).
Co to znaczy dla self-hostingu i dla Polski
Jeśli uruchamiasz modele przez Workers AI, endpoint modelu GLM-5.3 działa dziś na poprawionej konfiguracji i nic nie wskazuje na potrzebę działań po stronie klienta. Gorzej, jeśli sami stawiacie inferencję na SGLang: poprawki izolacji żądań trafiły do wersji od v0.5.20 do v0.5.22, a Cloudflare opisuje w PR #36988 i #38935 dokładnie ten mechanizm podmiany promptu tokenem zastępczym. Aktualizacja silnika to tu nie porządek dla porządku, tylko zamknięcie realnej ścieżki przecieku między sesjami, także na pojedynczym serwerze firmy.
Poza SGLang lekcja jest bardziej ogólna: pula pamięci KV ma pokrywać okno kontekstu, które reklamujesz, z zapasem na równoległe żądania, a silnik ma jawnie odrzucać to, czego nie da się obsłużyć. To banalna rachunkowość zasobów, ale jak widać, łatwo o nią potknąć się i dużej platformie. Dla polskiego rynku temat jest wciąż pusty: autocomplete przy frazie „glm-5.3” podpowiada huggingface, benchmarki i cennik, ale żadnej treści o wycieku, więc ktoś szuka tej informacji po polsku, dziś ją tu znajdzie pierwszy. Osobom stawiającym pierwsze lokalne modele polecam przegląd, jaki model wybrać pod słabszy komputer, a własne bramy API omawiam w tekście o własnym proxy do LLM.
Źródła
- [Cloudflare: Cross-request KV cache exposure in the GLM-5.3 Workers AI model, and our remediation with SGLang](https://blog.cloudflare.com/kv-cache-exposure-remediation/) (odczyt 27.10)
- [Dyskusja Hacker News](https://news.ycombinator.com/item?id=50252159) (odczyt 27.10 przez API Algolii)
- [Unite.AI: Cloudflare Says GLM-5.3 Bug Leaked 155 Responses Across Tenant Sessions](https://www.unite.ai/cloudflare-says-glm-5-3-bug-leaked-155-responses-across-tenant-sessions/) (tytuł z RSS Google News z 27.10, treść nieodczytana)
- [SGLang, repozytorium poprawek](https://github.com/sgl-project/sglang) (wersje v0.5.20-v0.5.22 wg opisu Cloudflare)