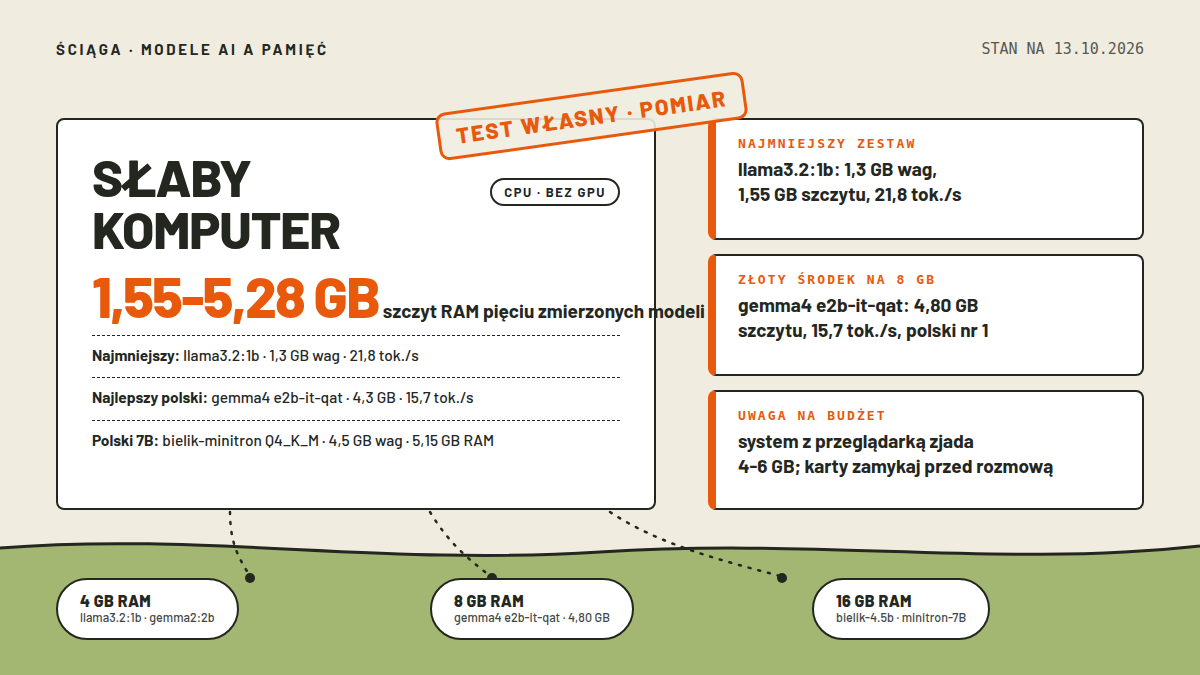
Pytanie „jaki model AI na słaby komputer” ma krótką odpowiedź i długą tabelę. Krótka odpowiedź brzmi: dobór modelu to najpierw budżet pamięci operacyjnej, dopiero potem procesor i cała reszta. Długa tabela jest niżej, a liczby w niej nie pochodzą z materiałów producentów. Pobrałem pięć modeli do Ollamy na laptopie z 2020 roku, bez karty graficznej, i przy każdym generowaniu zapisywałem szczytowe zużycie pamięci przez całe drzewo procesów serwera oraz prędkość zwracaną przez API. Jeśli twój komputer kupiony był do pracy, nie do sieciówek, ta strona powie ci, co na nim realnie ruszy.
Sprzęt testowy nie jest niczym specjalnym: procesor i7 dziesiątej generacji, dwanaście wątków, sześć lat na karku, zero dodatkowej grafiki. Dokładnie kategoria maszyny, o jaką pyta większość ludzi z tym problemem. Pełny opis metody, razem z uczciwym zastrzeżeniem, co te liczby mierzą, a czego nie, znajdziesz w sekcji o stanowisku testowym; na początek wystarczy wiedzieć, że każda wartość w tabelach przyszła z pomiaru, nie z obietnic na stronach rejestrów modeli.
- Najważniejsze informacje
- Stanowisko testowe: laptop bez karty graficznej
- Ściąga: trzy progi pamięci
- Pięć modeli na jednym procesorze
- 4 GB RAM: najmniejszy zestaw, który działa
- 8 GB RAM: złoty środek bez zapasu
- 16 GB i więcej: po polsku pełnią gębą
- Kwantyzacja: czemu Q4 waży cztery razy mniej
- Co wymienić w komputerze najpierw
- Czego nie oczekiwać od małego modelu
- Najczęstsze pytania
Najważniejsze informacje
| Pytanie | Krótka odpowiedź |
|---|---|
| Ile RAM-u na start? | model 1B mieści się w 1,55 GB szczytu; komputer z 4 GB wystarczy, nic więcej nie odpalaj |
| Jaki model na 8 GB RAM? | gemma2:2b (2,14 GB) swobodnie; gemma4:e2b-it-qat (4,80 GB) na styk, przy zamkniętej przeglądarce |
| Jaki model na 16 GB RAM? | cała polska rodzina: bielik-4.5b (5,28 GB) i bielik-minitron-7B (5,15 GB) |
| Najmniejszy sensowny model? | llama3.2:1b: 1,3 GB na dysku, 21,8 tok./s, po polsku miejscami kulawy |
| Najlepszy polski w teście? | gemma4:e2b-it-qat: 4,3 GB wag, 15,7 tok./s, najdłuższa spójna polszczyzna |
| Serwer sam w sobie | Ollama bez modelu zajęła 0,04 GB RAM |
Stanowisko testowe: laptop bez karty graficznej
Metoda w skrócie, żeby było jasne, co dokładnie kupujesz tymi liczbami. Silnikiem była Ollama w wersji 0.40.3 uruchomiona lokalnie, ta sama, której instalację opisujemy w poradniku o Ollamie po polsku. Pomiar pamięci to suma pamięci rezydentnej procesu głównego serwera i wszystkich jego procesów potomnych, próbkowana dziesięć razy na sekundę w trakcie generowania odpowiedzi. Liczby obejmują więc wagi modelu, bufor kontekstu i nadmiarowe alokacje, a nie sam rozmiar pliku na dysku; ten podajemy obok, w osobnej kolumnie. Prędkość czytamy z odpowiedzi API, bo Ollama zwraca w niej gotowe wyliczenie tokenów na sekundę, więc nie mierzyliśmy stoperem tego, co biblioteka raportuje sama.
Dwa zastrzeżenia dla uczciwości. Komputer ma 62 GB pamięci, więc progów dla maszyn z 4, 8 czy 16 GB nie sprawdzaliśmy przez doprowadzanie systemu do wymiany, tylko przez porównanie zmierzonych szczytów z tym, co na słabszych maszynach realnie zostaje po uruchomieniu systemu i przeglądarki. I drugie: jakość polszczyzny to nasza ocena odpowiedzi z tych testów, opisana słowami przy każdym modelu, a nie jakiś punktowy benchmark. Całość stanu na 13 października 2026, wersje modeli takie, jakie pobrała Ollama tego dnia.
Ściąga: trzy progi pamięci
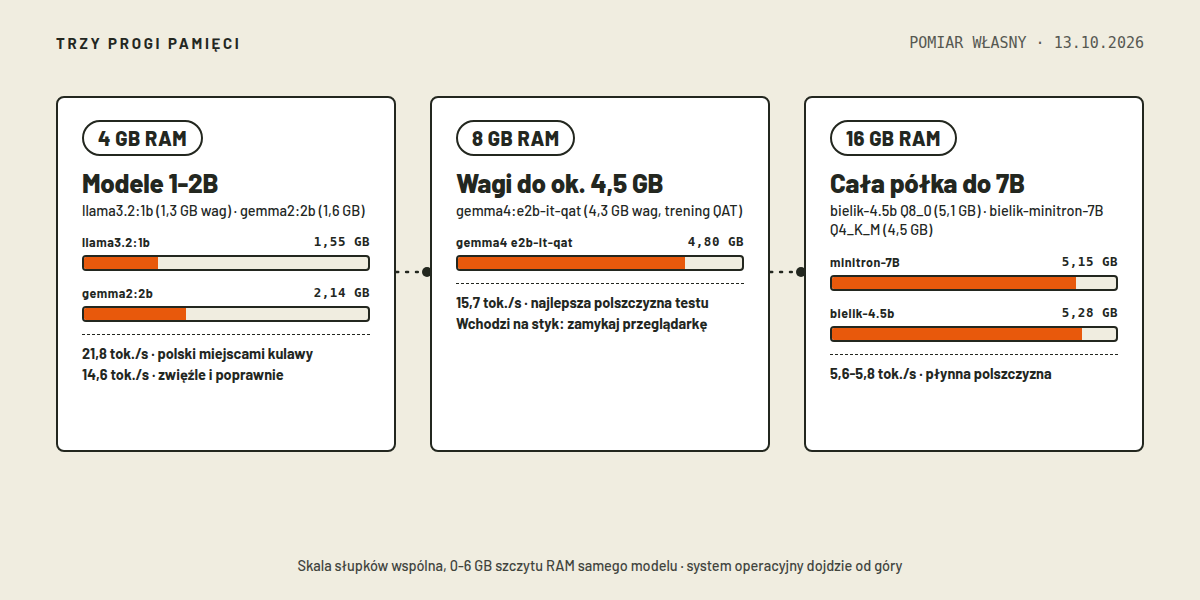
| RAM komputera | Co realnie wchodzi | Przykład z pomiaru |
|---|---|---|
| 4 GB | modele 1-2B | llama3.2:1b (1,55 GB szczytu), gemma2:2b (2,14 GB) |
| 8 GB | wagi do ok. 4,5 GB | gemma2:2b z zapasem; gemma4:e2b-it-qat (4,80 GB) na styk |
| 16 GB | wszystko do 7B włącznie | bielik-4.5b (5,28 GB), bielik-minitron-7B (5,15 GB) |
| 32 GB i więcej | 7B komfortowo, wchodzi duże MoE | Qwen 3.8 Flash 125B w Stracie: 12 GB VRAM i 32 GB RAM |
Do każdej z tych liczb dosiądzie od góry system operacyjny z tym, co akurat masz otwarte. Windows z przeglądarką i komunikatorem potrafi zjeść 4 do 6 GB, lżejsze pulpity Linuksa mniej, więc progi z tabeli traktuj jako budżet na sam model, z którego musisz jeszcze wyżyć. Przy 8 GB RAM oznacza to praktyczną regułę: zamykasz przeglądarkę przed rozmową albo przepraszasz model, że myśli w stoperach. Przy 16 GB przestajesz o tym myśleć, i to jest najtańsza granica komfortu.
Pięć modeli na jednym procesorze
Centralna tabela tego wpisu. Kolejność od najmniejszego zużycia pamięci do największego.
| Model | Szczyt RAM | Prędkość | Polski w teście |
|---|---|---|---|
| llama3.2:1b | 1,55 GB | 21,8 tok./s | krótko, miejscami kulawo |
| gemma2:2b | 2,14 GB | 14,6 tok./s | zwięźle i poprawnie |
| gemma4:e2b-it-qat | 4,80 GB | 15,7 tok./s | najdłuższa spójna polszczyzna |
| bielik-4.5b Q8_0 | 5,28 GB | 5,8 tok./s | poprawnie, ale uparcie listami |
| bielik-minitron-7B Q4_K_M | 5,15 GB | 5,6 tok./s | płynna polszczyzna |
Wagi na dysku dla tej piątki, w tej samej kolejności: 1,3 GB, 1,6 GB, 4,3 GB, 5,1 GB i 4,5 GB; różnica między plikiem a szczytem pamięci to bufor kontekstu i alokacje serwera, u małych modeli ledwo zauważalna, u większych około piętnaście procent.
Dwie rzeczy w tej tabeli mogą zaskoczyć, więc omówię je od razu. Prędkość nie rośnie z rozmiarem modelu; największa gemma w teście okazała się szybsza od mniejszego wagowo bielika, bo tempo na procesorze wyznacza między innymi architektura i kompresja wag, a nie sama liczba gigabajtów. I druga: 5,6 tokena na sekundę brzmi żałośnie na papierze, a w praktyce oznacza, że pełne zdanie pojawia się mniej więcej co dwie sekundy. Do pisania maila czy dopytywania o szczegóły wystarcza; o filmowy płynny streaming przy takim tempie można co najwyżej pomarzyć.
4 GB RAM: najmniejszy zestaw, który działa
Na takiej maszynie wybór zawęża się do dwóch modeli z naszego zestawienia i oba mają charakter. llama3.2:1b to najmniejsza sensowna pozycja w rejestrze Ollamy: 1,3 GB na dysku, 1,55 GB szczytu pamięci, tempo 21,8 tokena na sekundę, przy którym odpowiedzi dosłownie sypią się z ekranu. Haczyk siedzi w językach, bo karta modelu deklaruje osiem języków oficjalnie wspieranych, a polskiego na tej liście nie ma. W naszym teście na polskie pytanie odpowiedział po polsku, krótko i miejscami kulawo, jak ktoś, kto język zna z podwórka, nie ze szkoły. Do prostych rzeczy wystarczy, do pisania dłuższych tekstów nie.
Druga pozycja, gemma2:2b, jest moim typem na tej półce. W zasadzie wszystko ma lepsze: 1,6 GB wag, 2,14 GB szczytu, wciąż szybkie 14,6 tokena na sekundę, a po polsku pisze zwięźle i poprawnie, bez tych zgrzytów llamy. Karta modelu podaje, że w kompresji Q4_0 liczba parametrów to 2,61 miliarda przy 1,6 GB pliku, i te proporcje czuję w odpowiedziach: model wyraźnie więcej rozumie, niż waży. Jeśli twój komputer ma 4 GB i marzy ci się lokalny czat, zaczynasz od tej.
8 GB RAM: złoty środek bez zapasu
Środkowa półka wygląda najlepiej ceniono-jakościowo, ale wymaga dyscypliny. Gwiazdą naszego pomiaru okazała się gemma4:e2b-it-qat: 4,3 GB wag, 4,80 GB szczytu pamięci, 15,7 tokena na sekundę i zdecydowanie najlepsza polszczyzna w całym teście, bo na prośbę o rozdział o pszczołach wygenerowała najdłuższą spójną odpowiedź ze wszystkich pięciu modeli, i to bez gubienia wątku. Sufiks it-qat w nazwie to nie ozdoba, tylko trening świadomy kompresji, o którym piszę niżej; w rejestrze Ollamy ten tag jest najmniejszą pozycją całej rodziny gemma4 i wyraźnie najlepszą pod względem rozmiaru do jakości.
Matematyka pamięciowa na 8 GB jest jednak bezlitosna. Do 4,80 GB szczytu dosiada się system z przeglądarką i komunikatorem, czyli 4 do 6 GB zależnie od maszyny, i nagle budżet się kończy. Dlatego reguła tej półki: gemma4:e2b-it-qat wchodzi na 8 GB przy zamkniętej przeglądarce i bez piętnastu kart na zapas, a jeśli nie zamierzasz zamykać, zostań przy gemma2:2b, której nic nie zabraknie. Alternatywnie czyść kartę po karcie i obserwuj, czy odpowiedzi zaczęły się ciągnąć, bo pełna pamięć to wymiana na dysku, a dysk liczy te operacje wiele razy wolniej niż RAM.
16 GB i więcej: po polsku pełnią gębą
Nad progiem 16 GB przestają boleć kompromisy i wchodzą polskie modele właściwe. W teście były dwa. bielik-4.5b w kompresji Q8_0 zajął 5,28 GB szczytu przy 5,1 GB wag i pisał poprawnie, choć uparcie formatował odpowiedzi listami nawet wtedy, kiedy prosiliśmy o zdania ciągłe; ma to w sobie i tyle. Ciekawszy jest bielik-minitron-7B w Q4_K_M: 4,5 GB wag, 5,15 GB szczytu, 5,6 tokena na sekundę i płynna polszczyzna, którą pokazujemy z cytatami we wpisie o Bieliku. Siedem miliardów parametrów wytrenowanych z naciskiem na polski robi różnicę w jakości, jakiej mniejsze modele po prostu nie podadzą, a całość i tak mieści się w pamięci, jaką dziś ma przeciętny laptop biurowy.
Program do prowadzenia rozmów jest drugorzędny, ale skoro już tu jesteśmy: poza Ollamą, której instalację opisaliśmy krok po kroku, istnieje LM Studio z interfejsem okienkowym, opisane w osobnym poradniku o LM Studio; jego oficjalne wymagania mówią wprost, że maszyną minimalną jest komputer z 8 GB pamięci na wersjach z mniejszymi modelami i 16 GB zalecanymi na start. Na tym samym Bieliku w naszych pomiarach Ollama osiągała okazyjnie ponad dwukrotnie wyższe tempo niż domyślne ustawienia LM Studio, więc jeśli liczysz się z każdą sekundą na słabym sprzęcie, silnik ma znaczenie.
Kwantyzacja: czemu Q4 waży cztery razy mniej
Skoro cała ściągka kręci się wokół gigabajtów, trzeba rozbroić magiczne sufiksy w nazwach tagów. Wagi modelu w pełnej precyzji to liczby zmiennoprzecinkowe; dla modelu siedmiomiliardowego daje to pigułkę rzędu 14 GB, policzone prosto: 7 mld parametrów razy 2 bajty. Kwantyzacja Q8 zapisuje każdy parametr na jednym bajcie, więc ten sam model schodzi do okolic 7 GB, a Q4 zgrubnie do połowy tego. Nasze bielik-4.5b w Q8_0 waży 5,1 GB, co do liczby pasuje do tej arytmetyki jak ulane. Za kompresję płaci się dokładnością: im mocniej ściśniesz wagi, tym więcej drobnych decyzji model podejmuje po omacku, choć w praktyce Q4_K_M bywa rozsądnym kompromisem, zanim jakość zacznie się sypać gołym okiem.
Sufiks qat w gemma4:e2b-it-qat oznacza podejście sprytniejsze niż dociskanie gotowego modelu: trening od początku prowadzi się tak, by model wiedział, że będzie skompresowany. Efekt widać w naszym teście, gdzie najmniejszy tag rodziny gemma4 pisał po polsku lepiej od modeli dwukrotnie większych wagowo. Przy wyborze kieruj się prostą heurystyką: na słaby komputer bierz Q4_K_M albo tagi qat, Q8 tylko gdy masz zapas pamięci, a pełną precyzję zostaw maszynom z kartami graficznymi. Warto przy tym wiedzieć, że nie każdy model ma każdy tag; polski bielik-4.5b w rejestrze SpeakLeash występuje w Q8_0 i FP16, ale Q4 dla niego nie ma, więc jego mniejszy brat z kompresją jest po prostu nieosiągalny i na słabsze maszyny lepszy jest minitron.
Co wymienić w komputerze najpierw
Kolejność inwestycji przy słabym sprzęcie jest ważniejsza niż jej wysokość. Pierwsze miejsce należy się pamięci operacyjnej: wymiana z 8 na 16 GB otwiera całą półkę polskich bielików i jest najtańszym skokiem użyteczności w całym lokalnym AI, często tańszym niż miesiąc subskrypcji czatu chmurowego. Drugie miejsce to szybki dysk NVMe, bo oprócz skrócenia pierwszego uruchomienia modelu zmniejsza bóle przy pełnej pamięci, gdy system zaczyna wymieniać na dysk. Pełna pamięć to jeszcze nie ściana: system zaczyna wymieniać rzadko używane strony na dysk, rozmowa wciąż działa, tylko odpowiedzi wyraźnie się ciągną. Właśnie dlatego szybki dysk zajmuje drugie miejsce w kolejce, bo zamienia tę awaryjną prędkość z nerwowego czekania w coś, co da się wytrzymać do końca zdania. A przy okazji skraca pierwsze ładowanie modelu po restarcie, które na starym dysku talerzowym potrafi zająć dobrą minutę.
Procesor trzeci: różnica między dwoma a dwunastoma wątkami jest odczuwalna, ale mająca dwanaście wątków maszyna biurowa z 2020 roku liczyłaby te same 5,6 tokena na sekundę, które my zmierzyliśmy, więc nie wymieniaj procesora pod AI w pierwszej kolejności. Karta graficzna na tym etapie w ogóle nie jest koniecznością; wszystkie liczby na tej stronie powstały bez jednej, a jeśli już GPU, to liczy się pamięć karty, nie jej marka.
Czego nie oczekiwać od małego modelu
Ściągę sprzętową trzeba dopełnić uczciwą listą ograniczeń, bo rozczarowanie psuje używanie bardziej niż wolne tempo. Małe modele tracą wątek w długich rozmowach, gorzej rozumują na wielu poziomach naraz, a ich wiedza kończy się w chwili zakończenia treningu, więc o bieżących wydarzeniach nie powiedzą nic sensownego. Jeszcze mniejszą skalę reprezentują modele działające w samej przeglądarce, które testowaliśmy osobno we wpisie o AI w przeglądarce; tam po polsku bywa po prostu władczo źle i traktujemy to jako ciekawostkę techniczną. Jeśli potrzeby rosną, dwie drogi: chmura, którą opisujemy w zbiorze narzędzi AI, albo duży model lokalny w duchu Qwen 3.8 Flash z wpisu o lokalnym AI na komputerze, gdzie 12 GB VRAM i 32 GB RAM podnosi poprzeczkę wyraźnie ponad to, co tu opisujemy. Cały nasz klaster poradników lokalnych trzymamy w jednym miejscu, na stronie lokalne AI.
Najczęstsze pytania
Czy sztuczna inteligencja działa na słabym komputerze?
Tak, jeśli przez słaby rozumiesz brak karty graficznej i 4 do 8 GB RAM. Procesorowy laptop z 2020 roku w naszym teście prowadził rozmowy z pięcioma modelami, a najmniejszy z nich zajął 1,55 GB pamięci w szczycie. Warunkiem jest wybór modelu dopasowany do pamięci według tabel powyżej; odwrotna kolejność, czyli pobranie największego modelu i liczenie na cud, kończy się wymianą na dysk i tempem mierzalnym w minutach.
Ile RAM-u na lokalne AI?
Na samego modelu: od 1,55 GB dla llama3.2:1b przez 4,80 GB dla gemma4:e2b-it-qat do 5,28 GB dla bielik-4.5b. Do tego dolicz system z tym, co masz otwarte: na Windowsie z przeglądarką realnie 4 do 6 GB. Stąd nasze trzy progi: 4 GB RAM na modele 1-2B, 8 GB na wagi do około 4,5 GB, 16 GB na całą półkę do 7B włącznie.
Jaki jest najmniejszy model AI do lokalnego uruchomienia?
Z naszego zestawienia llama3.2:1b: 1,3 GB na dysku, 1,55 GB szczytu RAM, 21,8 tok./s na procesorze. Haczyk: oficjalne języki karty to osiem pozycji bez polskiego, więc dla polszczyzny lepszym najmniejszym wyborem jest gemma2:2b przy 2,14 GB szczytu. Mniejsze jeszcze tworzywa istnieją, głównie jako modele przeglądarkowe, ale po polsku odpowiadają tak słabo, że nie polecamy ich do pracy.
Jaki model AI po polsku na słabym komputerze?
Do 8 GB RAM: gemma2:2b (zwięźle, poprawnie) albo gemma4:e2b-it-qat przy zamkniętej przeglądarce (najlepsza polszczyzna w teście). Od 16 GB wzwyż: bielik-minitron-7B w Q4_K_M, wytrenowany z naciskiem na polski, 5,15 GB szczytu. Pełne omówienie polskiego modelu z komendami pobrania mamy we wpisie o Bieliku.
Czy Ollama działa na słabym komputerze?
Tak, i to z dużym zapasem: sam serwer Ollamy bez załadowanego modelu zajął w naszym pomiarze 0,04 GB pamięci. Cały ciężar stanowią wagi modelu, więc bariera pamięciowa dotyczy wyboru modelu, nie samego programu. Instalację i pierwsze kroki opisujemy w poradniku Ollama po polsku.
Nota uczciwości
Pomiary wykonaliśmy 13 października 2026 na jednym komputerze (i7-10850H, 12 wątków, 62 GB RAM, Linux, bez karty graficznej) w Ollamie v0.40.3; pamięć mierzyliśmy jako sumę dla drzewa procesów serwera, próbkując co 0,1 s podczas generowania, a prędkości pochodzą z raportów API. Progi dla maszyn o 4, 8 i 16 GB wyliczyliśmy z tych szczytów i typowego obciążenia systemu, bo komputer testowy ma 62 GB; nie uruchamialiśmy modeli na fizycznie ograniczonych maszynach. Oceny polszczyzny to opis pojedynczych odpowiedzi z naszych testów, nie benchmark. Wersje i rozmiary modeli zgodne z rejestrami Ollamy na dzień pomiaru; cudzych kompilacji nie pobieraliśmy.
Źródła
- Ollama, karta modelu llama3.2, lista języków i rozmiary (pobrane 13.10.2026): https://ollama.com/library/llama3.2
- Ollama, karta modelu gemma2, parametry i kompresja Q4_0 (pobrane 13.10.2026): https://ollama.com/library/gemma2
- Ollama, tagi rodziny gemma4, pozycja e2b-it-qat jako najmniejszej (pobrane 13.10.2026): https://ollama.com/library/gemma4/tags
- Ollama, rejestr SpeakLeash, bielik-4.5b, dostępne kompresje (pobrane 13.10.2026): https://ollama.com/speakleash/bielik-4.5b-v3.0-instruct
- Ollama, rejestr SpeakLeash, bielik-minitron-7B (pobrane 13.10.2026): https://ollama.com/speakleash/bielik-minitron-7B-v3.0-instruct
- LM Studio, wymagania systemowe aplikacji (pobrane 13.10.2026): https://lmstudio.ai/docs/app/system-requirements