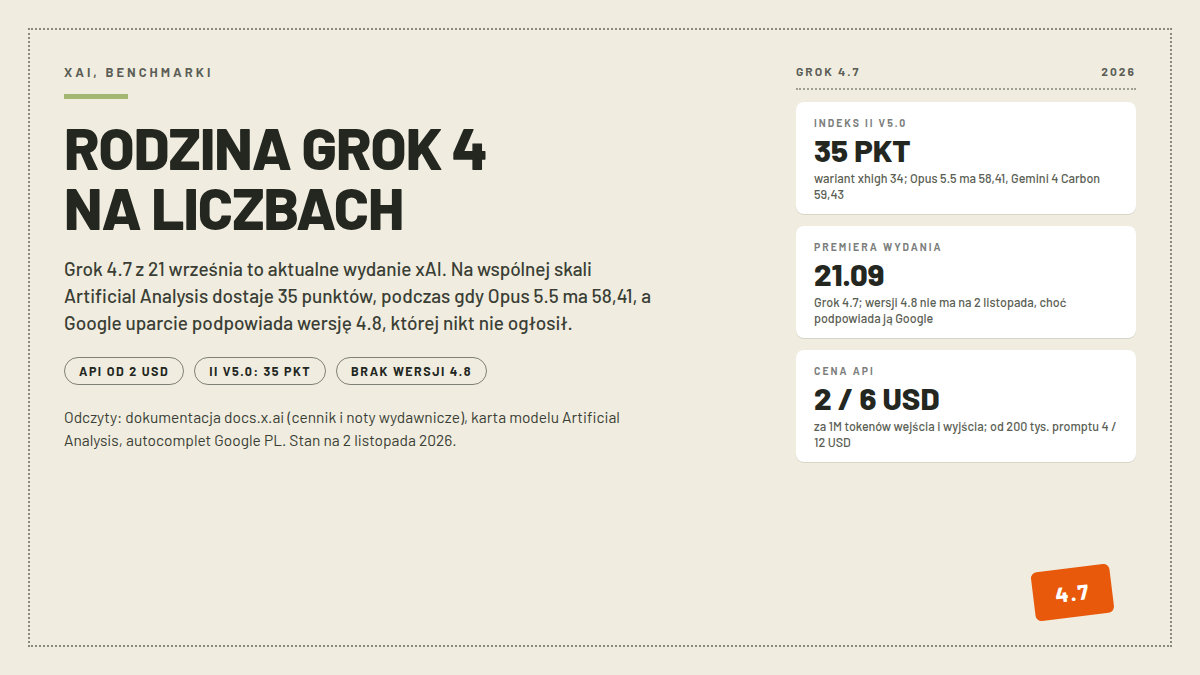
Podpowiedzi Google dla frazy „grok 4” czytają się dziś jak spis wydań jednej rodziny: 4.5, 4.6, 4.7 i 4.8 (odczyt 2 listopada 2026). Tyle że ostatniej z tych wersji nie ma. Aktualnym modelem xAI jest Grok 4.7, wydany 21 września 2026, i to jemu przyglądam się na liczbach: cennik API czytam z dokumentacji developerów xAI, pozycję sprawdzam na wspólnej skali Artificial Analysis, a do porównania biorę kotwice z naszego tekstu o Gemini 4 Carbon, czyli 59,43 punktu dla Carbona i 58,41 dla Claude Opus 5.5. Przy okazji rozstrzygam, skąd wziął się „Grok 4.8”, skoro xAI niczego takiego nie ogłosiła.
Grok 4 to flagowa linia modeli xAI, laboratorium przejętego 2 lutego 2026 przez SpaceX, o czym szeroko pisaliśmy w osobnym tekście o Groku. Rodzina rośnie szybko: od lipca 2025, kiedy wyszedł pierwotny Grok 4, lab wydał pięć kolejnych numerów, a każdy numer zostawia po sobie stare porównania z Anthropicem i OpenAI, które ludzie wciąż wpisują w wyszukiwarkę. Stąd w podpowiedziach para „grok 4.6 vs opus 5” albo „grok 4.5 benchmark”, choć żadna z tych wersji nie jest już czołówką rodziny. Dzięki mapie wydań z datami widać, które porównanie odnosi się do czego.
- Najważniejsze informacje
- Rodzina Grok 4: wszystkie wydania z datami
- Grok 4.8: Google podpowiada, xAI milczy
- Grok 4.7 pricing: cennik API na żywo
- Grok 4.7 benchmarks: gdzie siedzi na wspólnej skali
- Zamknięte wagi i amerykańskie regiony
- FAQ
Całość opieram na odczytach z datą: dokumentacji docs.x.ai (cennik, noty wydawnicze), karty modelu na Artificial Analysis i polskiej Wikipedii z przypisami do kolejnych ogłoszeń xAI. Wyniki producenta oznaczam zawsze jako głos producenta, opinii z Reddita nie cytuję, a tam gdzie danych nie dało się przeczytać, piszę wprost, że ich nie ma.
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Aktualna wersja | Grok 4.7, wydany 21 września 2026; kontekst 500 tys. tokenów, wiedza do maja 2026 |
| Indeks II v5.0 | 35 punktów (odczyt 2 listopada); Gemini 4 Carbon 59,43, Opus 5.5 58,41, Astra 56,85 |
| Cena API | 2 USD za 1M wejścia, 6 USD za 1M wyjścia (cache 0,50); od 200 tys. promptu 4 i 12 USD |
| Plany czatowe | darmowy z limitami; Plus 8, Premium 30, Super 100, Ultra 200 USD miesięcznie (snapshot 26.10) |
| Grok 4.8 | brak wydania na 2 listopada; fraza żyje tylko w podpowiedziach Google |
Rodzina Grok 4: wszystkie wydania z datami
Kolejność wygląda tak: Grok 4 wyszedł 9 lipca 2025 z natywną obsługą narzędzi i dostępem do wyszukiwania w czasie rzeczywistym, Grok 4.1 pojawił się 17 listopada 2025, a w 2026 roku nadeszły 4.5 (16 lipca), 4.6 (12 sierpnia, w opisie producenta z naciskiem na długotrwałą pracę agentową) i wreszcie 4.7 (21 września). Daty brałem z dwóch miejsc czytanych 2 listopada: z polskiej Wikipedii, której przypisy prowadzą do kolejnych ogłoszeń xAI, oraz z not wydawniczych docs.x.ai. Jest w tej kolekcji też dziwak o numerze 4.20: w API istnieje jako grok-4.20-0309 z wariantami reasoning, non-reasoning i multi-agent, noty wydawnicze umieszczają go w marcu 2026, a Artificial Analysis wycofała go już ze swoich tabel jako przestarzały (odczyt 2 listopada). Numer bywa mylący: wygląda na nowszy niż 4.7, a jest starszym wydaniem z marca, które xAI w notach nazywa wprost Grokiem 4.20.
Sam Grok 4.7 dostał kontekst 500 tysięcy tokenów, wejście tekstowe i obrazkowe z tekstowym wyjściem bez limitu długości, oraz rozumowanie w czterech ustawieniach: low, medium, high (domyślne) i xhigh. Wiedza modelu kończy się w maju 2026, a na Responses API zawsze zwraca zaszyfrowany ślad rozumowania, nawet gdy go nie prosisz. Wątek na Hacker News z dnia premiery uzbierał 609 punktów. Jest też wariant Grok 4.7 Fast: to ten sam model pod podwójną stawką (półtora raza droższy przy długim kontekście), sprzedawany wyłącznie przez Cursor i Grok Build, nie przez publiczne API xAI. Fast jest więc produktem dla platform, które chcą szybszego toru dla swoich klientów, a nie opcją w cenniku dla programisty z kartą.
Grok 4.8: Google podpowiada, xAI milczy
Fraza „grok 4.8” siedzi na czwartej pozycji podpowiedzi dla „grok 4”, więc sprawdziłem trzy miejsca, w których takie wydanie powinno zostawić ślad. Dokumentacja API (cennik, indeks stron dla maszyn, noty wydawnicze prowadzone do października) kończy się na 4.7. Polska Wikipedia w haśle aktualnym na 2 listopada nazywa stabilną wersją Groka 4.7 i o nowszym nie wspomina. W archiwum Hacker News nie znalazłem wątku o wydaniu 4.8. Samej strony x.ai nie wczytałem na żywo, bo Cloudflare odcina zautomatyzowane odczyty, więc teoretycznie mogła powstać zapowiedź sprzed kilku godzin; na stan 2 listopada jednak ani dokumentacja, ani encyklopedia nie znają Groka 4.8. Gdy lab coś takiego ogłosi, dopiszę tu aktualizację z datą.
Grok 4.7 pricing: cennik API na żywo
Tabelę czytam z dokumentacji xAI z odczytem 2 listopada 2026. Stawki podane na milion tokenów, w formacie wejście / cache / wyjście.
| Model | Poniżej 200 tys. promptu | Od 200 tys. promptu |
|---|---|---|
| grok-4.7 i grok-4.6 | 2,00 / 0,50 / 6,00 USD | 4,00 / 1,00 / 12,00 USD |
| grok-4.5 | 2,00 / 0,30 / 6,00 USD | 4,00 / 0,60 / 12,00 USD |
| grok-4.3 i grok-4.20 (kontekst 1M) | 1,25 / 0,20 / 2,50 USD | 2,50 / 0,40 / 5,00 USD |
| grok-build-0.1 (kontekst 256k) | 1,00 / 0,20 / 2,00 USD | 2,00 / 0,40 / 4,00 USD |
Haczyk siedzi w progu 200 tysięcy: gdy prompt go przekroczy, droższa stawka obejmuje całe zapytanie, nie tylko nadwyżkę ponad limit. Dokumentacja nazywa to rozliczeniem long context i warto to policzyć przed wrzuceniem dużego korpusu w jedno zapytanie, bo rachunek podwaja się skokowo. Przetwarzanie wsadowe przez Batch API jest o 20 procent tańsze od standardowych stawek, a limity dla grok-4.7 wynoszą 150 zapytań na sekundę i 50 milionów tokenów na minutę. Obok tekstu xAI sprzedaje też mowę i obraz: rozmowa głosowa po 0,08 dolara za minutę, zapis mowy 0,10-0,20 dolara za godzinę zależnie od trybu, syntez mowy 15 dolarów za milion znaków, obrazy od 0,02 do 0,05 dolara za sztukę i wideo od 0,02 do 0,08 dolara za sekundę.
W czacie poza API xAI ma plan darmowy z limitami, których liczbowo nie publikuje, a nad nim drabinkę Plus 8, Premium 30, Super 100 i Ultra 200 dolarów miesięcznie z snapshotu cennika z 26 października, bez VAT. Ekonomię darmowej warstwy rozpisujemy w poradniku o Groku za darmo, a kwestie językowe w tekście o Groku po polsku.
Grok 4.7 benchmarks: gdzie siedzi na wspólnej skali
Na wspólnej skali Artificial Analysis w wersji v5.0, tej przeliczonej 27 października, wydanie Grok 4.7 ma 35 punktów z odczytu 2 listopada; strona modelu otwiera się domyślnie na wariancie (Xhigh), którego AA liczy na 34, wobec mediany 38 dla porównywalnych modeli. Kotwice stoją wysoko: Gemini 4 Carbon 59,43, Opus 5.5 58,41, Astra 56,85 (nasz wcześniejszy odczyt pisał o 57, dziś skala pokazuje 56,85). Bezpośredni sąsiad Groka od góry to Claude Haiku 5.5 z 36,23, a od dołu Qwen3.8 Max z 33,55. Z chińskiej półki, którą mapowaliśmy w tekście o wagach Kimi K3.1 Pro, K3.1 Pro ma 46 punktów, GLM-5.3 31,65; Grok siedzi więc między nimi, bliżej GLM-a niż Kimi.
Do tego dochodzi rachunek. AA policzyło koszt jednego zadania indeksu dla wariantu (Xhigh) na 7,51 dolara, bo model wygenerował na cały indeks 140 milionów tokenów przy medianie 71 milionów, czyli jest wyraźnie gadatliwy, a do tego wolniejszy od średniej (80 tokenów na sekundę wobec mediany 83). Serwis podsumowuje to bez owijania: poniżej średniej inteligencji, bardzo gadatliwy, rozsądnie wyceniony tylko na tle modeli o podobnej cenie. To lekcja z naszej mapy chińskich modeli: gadatliwość potrafi zjeść przewagę taniego tokenu, więc samą stawkę trzeba czytać ostrożnie.
Deklaracje producenta trzymają inną tonację. Dokumentacja xAI nazywa 4.7 „most capable model we’ve built”, czyli najzdolniejszym modelem, jaki zbudowali, i opisuje go jako czołowy w kodowaniu, zadaniach agentowych i pracy z wiedzą. To głos producenta, którego AA swoim pomiarem na razie nie potwierdza, i obie te informacje mogą stać obok siebie, bo mierzą co innego: deklaracja opisuje ambicję, indeks zmierzoną klasę pracy agentowej.
Frazy porównawcze z podpowiedzi wymagają osobnej, uczciwej notki. „Grok 4.6 vs opus 5”, „grok 4.5 benchmark” i „grok 4.5 vs opus 4.8” odnoszą się do miesięcy, gdy 4.5 i 4.6 były aktualne; Artificial Analysis nie ma dziś w aktywnych tabelach świeżych punktów dla żadnej z tych starszych wersji Groka (odczyt 2 listopada), a wyników sprzed przeliczenia indeksu z 27 października nie sposób uczciwie postawić obok liczb v5.0. Aktualne porównanie z Anthropicem wygląda więc tak: Grok 4.7, 35 punktów, wobec Opus 5.5 z 58,41. Wobec Astry OpenAI: 35 wobec 56,85. Frazę „grok 4.7 reddit” zostawiam bez cytowania: wątki, które tam siedzą, nie są czymś, co potrafię zweryfikować, a rozstrzygać te pytania może pomiar na wspólnej skali, nie cudze wrażenia.
Zamknięte wagi i amerykańskie regiony
Grok 4.x to modele zamknięte; Artificial Analysis klasyfikuje je jako własnościowe z odczytu 2 listopada, a jedyny otwarty Grok w historii to Grok-1 z 17 marca 2024, wystawiony na licencji Apache 2.0 z 314 miliardami parametrów w architekturze MoE. Dla porównania Moonshot obiecał pełne wagi K3.1 Pro najpóźniej 4 listopada 2026, więc jeśli waga otwartego modelu jest warunkiem wyboru, rodzina Groka wypada poza grę z definicji. Druga rzecz dla zespołów poza Ameryką: karta modelu grok-4.7 wymienia wyłącznie regiony amerykańskie (us-east-1, us-west-2, us-central-1), a dostęp wersji 4.5 w europejskiej konsoli API dopisano w notach dopiero w lipcu. Flagowiec chodzi dziś na endpointach w USA, co ma znaczenie dla opóźnień i dla zespołów, które muszą wiedzieć, gdzie lądują ich dane.
Do darmowego czatu wystarczy plan zero, o czym pisze poradnik o darmowym Groku; do pracy po polsku przyda się tekst o Groku po polsku; pojedynku z OpenAI poświęciliśmy osobny wpis. Programista, który myśli o API, wyczyta z tego tekstu tyle: Grok 4.7 ma przyzwoite stawki, 2 i 6 dolarów z cache po 0,50, ale koszt zadania 7,51 dolara przy gadatliwości daleko powyżej mediany zjada tę przewagę, a na wspólnej skali jakości siedzi ponad 20 punktów niżej od czołówki. Kto buduje coś taniego i masowego, policzy własny profil użycia na stawkach z tabeli; kto kupuje najwyższą zmierzoną klasę pracy agentowej, dziś znajdzie ją po stronie konkurencji.
FAQ
Grok 4.7 vs Opus 5.5: który jest lepszy?
Na wspólnej skali Artificial Analysis v5.0 (odczyt 2 listopada 2026) Opus 5.5 ma 58,41 punktu, Grok 4.7 około 35. Koszt zadania dokłada swoje: 7,51 dolara dla wariantu xhigh przy gadatliwości dwukrotnie powyżej mediany. Skala mierzy zadania agentowe, więc werdykt dotyczy tej klasy pracy, a nie rozmów czy pisania tekstów.
Grok 4.7 kiedy wyszedł?
21 września 2026. Na 2 listopada 2026 jest to najnowsze wydanie xAI: ani dokumentacja API z notami wydawniczymi, ani Wikipedia, ani wątki Hacker News nie znają niczego nowszego. Fraza „grok 4.8” w podpowiedziach Google nie ma pokrycia w żadnym ogłoszeniu.
Grok 4.6 vs Opus 5: czy to wciąż aktualne porównanie?
Grok 4.6 wyszedł 12 sierpnia 2026 i w API kosztuje dokładnie tyle, co 4.7, ale przestał być aktualną czołówką rodziny. Świeżego punktu 4.6 na skali v5.0 nie ma (odczyt 2 listopada), a porównania sprzed 27 października, gdy AA przeliczyło indeks na v5.0, odnoszą się do innej skali. Dla samego Opus 5 bez dopisku „5.5” nie mamy u siebie świeżego odczytu i zamiast zgadywać, odsyłamy do aktualnej pary: 4.7 wobec Opus 5.5.
Grok 4.7 pricing: ile kosztuje?
API: 2 dolary za milion tokenów wejścia i 6 za wyjście, trafienia cache po 0,50; od 200 tysięcy tokenów promptu 4 i 12 dolarów. Batch API wychodzi o 20 procent taniej. Grok 4.7 Fast kosztuje podwójnie, ale kupisz go tylko w Cursorze i Grok Build. W czacie od zera: warstwa darmowa z limitami, potem Plus 8, Premium 30, Super 100 i Ultra 200 dolarów miesięcznie (snapshot 26 października, bez VAT).
Źródła
- Cennik API xAI z tabelą long context, https://docs.x.ai/developers/models.md (odczyt 2 listopada 2026)
- Noty wydawnicze xAI z datami wydań 4.20, 4.5 i 4.7 oraz opisem Fast, https://docs.x.ai/developers/release-notes.md (odczyt 2 listopada 2026)
- Karta modelu grok-4.7: kontekst, rozumowanie, limity, regiony, https://docs.x.ai/developers/models/grok-4.7.md (odczyt 2 listopada 2026)
- Indeks II v5.0 Artificial Analysis dla Grok 4.7 z kosztem zadania i gadatliwością, https://artificialanalysis.ai/models/grok-4-7 (odczyt 2 listopada 2026)
- Hasło Grok w polskiej Wikipedii z datami wydań i przypisami do ogłoszeń xAI, https://pl.wikipedia.org/wiki/Grok (odczyt 2 listopada 2026)
- Wątek Hacker News z dnia premiery Grok 4.7 (609 punktów), https://news.ycombinator.com/item?id=49788838 (odczyt 2 listopada 2026, wyszukiwarka Algolia)
- Żywy autocomplet Google PL dla fraz „grok 4” i „grok 4.7”, https://suggestqueries.google.com/complete/search?client=firefox&hl=pl&gl=pl&q=grok%204 (odczyt 2 listopada 2026)
- Nasz tekst o Groku: przejęcie przez SpaceX, plany, darmowa warstwa, https://technetblog.pl/2026/11/grok-co-to-jest/ (opublikowany 1 listopada 2026)
- Nasz pojedynek Grok vs ChatGPT, https://technetblog.pl/2026/10/grok-vs-chatgpt/
- Nasz tekst o Gemini 4 Carbon z kotwicami skali AA, https://technetblog.pl/2026/10/gemini-4-carbon/ (opublikowany 29 października 2026)
- Nasz tekst o Kimi K3.1 Pro i wagach otwartych, https://technetblog.pl/2026/10/kimi-k3-1-pro/ (opublikowany 23 października 2026)
- Nasz poradnik o darmowej warstwie Groka, https://technetblog.pl/2026/11/grok-za-darmo/ (opublikowany 2 listopada 2026)
- Nasz poradnik o Groku po polsku, https://technetblog.pl/2026/11/grok-po-polsku/ (opublikowany 2 listopada 2026)