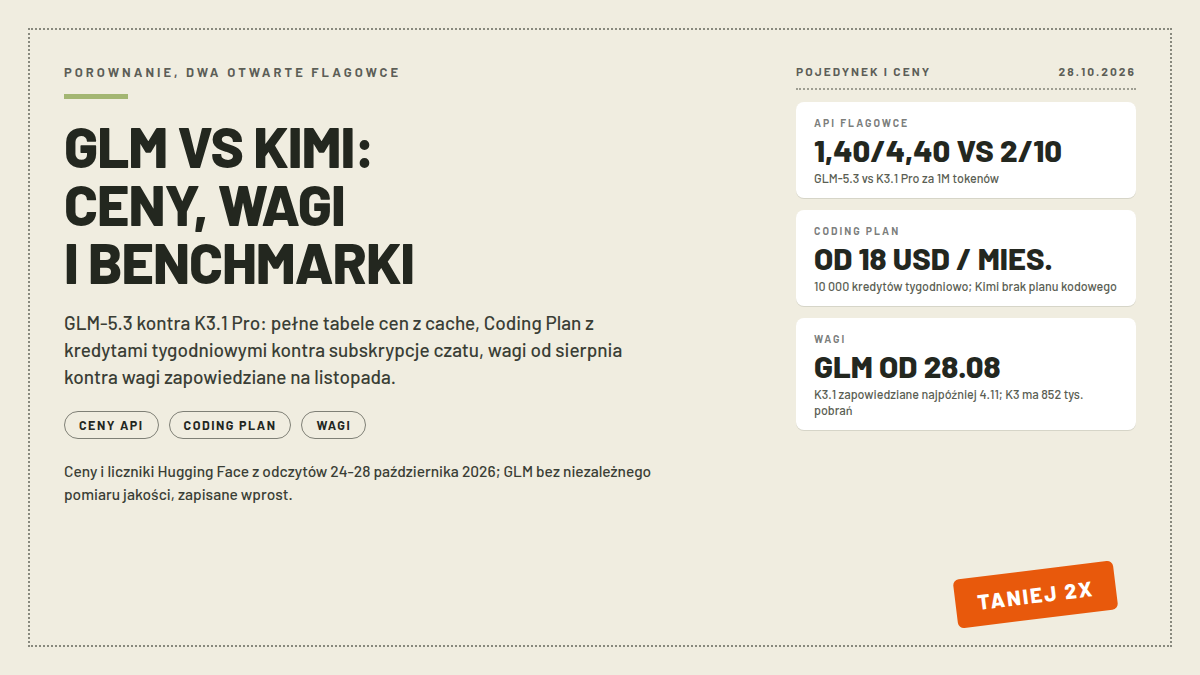
Zestawienie „glm vs kimi” ma w autocomplecie Google dziesięć podpowiedzi i dziwną cechę: większość pyta o konkretne wersje (k2, k3, 5.2), a jedna o „roleplay”. Jeszcze 28 października próg tego zestawienia wyglądał inaczej: Artificial Analysis nie pokazywało GLM-5.3 w czytelnej formie, a jedyne wyniki tego modelu pochodziły z własnego benchmarku producenta o nazwie Z.ai Code Bench. Dziś pomiar jest i to na wspólnej skali: w wersji v5.0 indeksu, przeliczonej 27 października, K3.1 Pro ma 46 punktów, GLM-5.3 zaś 32 (odczyty 2 listopada). Porównuję więc wszystko, co jest twarde po obu stronach: ceny, wagi, plany, ekosystem, a o jakości tyle, ile da się udokumentować z datą.
Oba modele opisane są u nas osobno i szeroko: GLM z darmowym czatem Z.ai i Kimi z planami od zera do 199 dolarów, a całą chińską czwórkę mapuje osobny poradnik. Pozostałe pary też mają swoje teksty: Kimi kontra ChatGPT i Kimi kontra DeepSeek.
- Ceny API: GLM tańszy na każdym piętrze
- Coding Plan kontra subskrypcje czatu
- Wagi otwarte: sierpień kontra listopad
- Benchmarki: co wolno powiedzieć, a czego nie
- Bezpieczeństwo stosu i wątek zaufania
- Roleplay i pisanie kreatywne
- FAQ
Obie rodziny rozwijały się w 2026 roku równolegle i szybko. GLM przeszedł od 5.1 z kwietnia przez 5.2 z czerwca (premiera z deklaracją przewagi nad Claude we własnych benchmarkach, wątek na Hacker News z 1113 punktami), 5.3 z 14 sierpnia, po model Legal z 10 października i zapowiedziany Ox Alpha. Moonshot od K3 z 13 czerwca przeszedł na K3.1 Pro i Highspeed 23 października, z wagami zapowiedzianymi na początek listopada. Wersje w autocomplecie (k2, 5.2, 5.1) to dziś porównania z modelami, które w ofercie już nie są aktualną czołówką; aktualna para to GLM-5.3 kontra K3.1 Pro, i takiej trzymam się w całym tekście.
Ceny API: GLM tańszy na każdym piętrze
To najtwardsza część porównania, bo pełne tabele po obu stronach czytają się z publicznych cenników (odczyty 24 i 28 października). GLM-5.3 kosztuje 1,40 dolara za milion tokenów wejścia i 4,40 za wyjście, z trafieniami cache po 0,26 dolara; Kimi K3.1 Pro płaci 2 i 10 dolarów z cache po 0,20. Na poziomie szybkich wariantów różnica robi się przepaścią: GLM-5.3-Flash to 0,15 i 0,50 dolara z cache po zaledwie 0,03, a K3.1 Pro Highspeed kosztuje 4 i 20 dolarów z tym samym cache 0,20 co zwykły Pro.
Przeliczając na typowy profil agenta (dużo wejścia, cache’owane dokumenty, umiarkowane wyjście), GLM wychodzi taniej w każdym scenariuszu, który mogę policzyć z tych tabel, i nie ma tu żadnego haczyka w stylu godzin szczytu, bo cennik Z.ai jest płaski w dobie. Na samych tokenach przewaga GLM-a broni się bez zmian; pomiar kosztu całego zadania z indeksu AA (o nim niżej) pokazuje jednak, że gadatliwość potrafi ten rachunek odwrócić, więc decyzja brzmi: tańszy token i zmierzony wyższy koszt pracy kontra droższy token i wyższy zmierzony wynik.
Przy cenach tego rzędu najmniejsza pozycja robi różnicę. Trafienie cache u Kimi kosztuje 0,20 dolara za milion tokenów, u GLM-5.3 0,26, ale na Flashu tylko 0,03, więc agent wielokrotnie czytający te same dokumenty na GLM-Flash płaci za odczyty kontekstu grosze. Z drugiej strony pomiar kosztu całego zadania ma dziś obie strony: AA liczy K3.1 Pro na 3,68 dolara za zadanie indeksu, GLM-5.3 na 5,01 dolara (odczyty 2 listopada), przy gadatliwości 140 milionów tokenów wyjścia po stronie GLM-a wobec 110 milionów u Kimi. Oszczędność na stawce potrafi więc zjeść dłuższa odpowiedź. Kto buduje dużą automatyzację, powinien policzyć własne proporcje wejścia, cache i wyjścia zamiast patrzeć wyłącznie na dwie główne liczby.
Coding Plan kontra subskrypcje czatu
Obaj producenci sprzedają abonamenty, ale zupełnie innym klientom. Z.ai ma GLM Coding Plan z kredytami użycia odnawianymi co tydzień: poziom Lite daje 10 tysięcy kredytów tygodniowo za 18 dolarów, przy rozliczeniu kwartalnym 14,40, a przy rocznym 12,60; poziom Pro daje sześciokrotność limitu za 80 dolarów, Max czternastokrotność za 168. Moonshot nie ma w naszych odczytach planu dla programistów w ogóle; sprzedaje drabinkę czatową od darmowego przez Plus 19 i Pro Highspeed 39 po Max 99 i Ultra 199 dolarów, a programista bierze API za token.
To rozróżnienie robi praktyczną różnicę w codziennym rachunku: Coding Plan z limitem tygodniowym premiuje stały, przewidywalny rytm pracy z kodem, bo płacisz raz i intensywnie używasz do wyczerpania kredytów, a model API z cennikiem za token premiuje prace skokowe. Kto koduje codziennie po kilka godzin, u Z.ai wie z góry, ile wyda w miesiącu; kto odpala zadania nieregularnie, nie zechce płacić za kredyty, których nie zdąży spożytkować, bo kredyty niewykorzystane w danym tygodniu przepadają.
Wagi otwarte: sierpień kontra listopad
GLM-5.3 ma wagi otwarte od 28 sierpnia 2026, a szybszy Flash zebrał na Hugging Face 6,4 miliona pobrań, sam GLM-5.3 2,18 miliona (odczyty 28 października). Po stronie Moonshota K3 jest do pobrania od 13 czerwca z 852 tysiącami pobrań, ale flagowy K3.1 Pro czeka na pełne wagi zapowiedziane najpóźniej na 4 listopada 2026. Dla kogoś, kto chce dziś postawić mocny chiński model u siebie, oferta Z.ai jest kompletna od ponad dwóch miesięcy; wagi Kimi dopiero wyjdą, a wtedy dopiszę tu realne rozmiary plików i kwantyzacje. Ekosystem wag wykorzystujących GLM-5.3-Flash jako bazę widać już po naszych stronach, przykładem Ultramarine-1 Flash.
Produktowo różni je klient, do którego mówią. GLM wystawia darmowy czat chat.z.ai (producent deklaruje używanie bez logowania; co dokładnie widać bez konta, opisaliśmy w poradniku GLM, bo kont nie zakładamy), aplikacje mobilne i plany z kredytami dla kodujących. Kimi buduje wokół czatu pakiet narzędzi pracy: Kimi Work do dłuższych zadań, Kimi Code do kodowania, projekty i dokumenty, o czym szeroko w poradniku Kimi. Abonament Moonshota kupuje więc wygodę gotowych narzędzi, abonament Z.ai kredyty na własne narzędzia; oba podejścia mają sens dla innego stylu pracy.
Benchmarki: co wolno powiedzieć, a czego nie
Wolno dziś powiedzieć więcej niż tydzień temu. Artificial Analysis zmierzyło K3.1 Pro na 67% w Terminal-Bench 4.0, najwyżej ze wszystkich modeli w tej miarze, dało mu czwarte miejsce w indeksie ogólnym (55) i trzecie na GDPval-AA (1846 Elo, odczyty 24 października); 27 października przeliczyło indeks na wersję v5.0 i na wspólnej skali z odczytu 2 listopada K3.1 Pro ma 46 punktów, a GLM-5.3 zaledwie 32. Z.ai dla swojej flagowej rodziny publikuje własny Z.ai Code Bench i deklaracje porównawcze z konkurencją, bez zewnętrznego pomiaru w naszych źródłach. Wcześniej, przy premierze rodziny 5.2 w czerwcu, producent chwalił się przewagą nad Claude w swoich benchmarkach i wątek na Hacker News uzbierał 1113 punktów, ale to nadal głos producenta. Frazy „glm vs kimi reddit” prowadzą głównie do wypowiedzi, których nie weryfikowałem i cytować ich nie będę; rozstrzygać dziś można pomiarem AA na wspólnej skali, nie cudzymi opiniami.
Jedna twarda obserwacja zostaje: pomiar kosztu zadania wynika w dużej mierze z gadatliwości modelu i po odczycie 2 listopada ma obie strony, 3,68 dolara dla K3.1 Pro wobec 5,01 dolara dla GLM-5.3. Cena tokena przestała być jedyną oszczędnością po stronie GLM-a; kupowanie go wyłącznie przez najniższą stawkę to zakład, który AA policzyło na niekorzyść.
Bezpieczeństwo stosu i wątek zaufania
W ostatnich tygodniach incydent miał GLM, nie Kimi: model serwowany na Workers AI od Cloudflare zwracał fragmenty cudzych sesji, przez błędną konfigurację puli pamięci KV i błąd silnika SGLang, co rozpisaliśmy w tekście o wycieku. Podkreślam uczciwie obie strony tej sprawy: wina leżała po stronie konfiguracji dostawcy i błędu narzędzia serwującego, nie wag modelu, a incydent pokazuje, że stos, na którym model stoi, bywa równie ważny jak sam model. Po stronie Kimi incydentów bezpieczeństwa w naszych odczytach nie ma, co nie znaczy, że ryzyka nie ma; znaczy tylko, że nic go u nas nie udokumentowano. Obie firmy siedzą w Chinach i podlegają temu samemu prawu, o czym pisze mapa chińskiego AI.
Roleplay i pisanie kreatywne
Frazy o „roleplay” pojawiają się w obu rodzinach autocompletu, więc zostawię tu uczciwą notkę zamiast milczenia. Pisanie kreatywne i odgrywanie postaci to zastosowania, których nie da się porównać benchmarkami z odczytów, bo żadna z dwóch firm nie publikuje w tym obszarze miar, które można zacytować z datą, a własnych testów nie prowadziliśmy. Gdyby ktoś szukał tu zgody na omijanie zabezpieczeń albo wersji bez filtrów, to nie tu: obaj producenci mają własne polityki użycia i ich nie obalimy. Czaty obu firm mają plany darmowe, więc każdy może przeprowadzić taki test rozmowy samodzielnie i na własnych przykładach.
Jeśli zebrać wybór w jedno zdanie bez tabelek: programista z budżetem i przewidywalnym rytmem pracy dostaje od Z.ai tańszy token, tańszy cache i kredyty tygodniowe, więc jego rachunek jest niższy z definicji cennika. Zespół albo osoba budująca agentów na najwyższej mierzonej jakości ma dziś dokumentację pomiarów po stronie K3.1 Pro i twardy argument w Terminal-Bench, za co płaci cennikiem dwukrotnie droższym. Kto chce model na własny sprzęt już dziś, bierze wagi GLM-5.3, które chodzą w społeczności od sierpnia; kto może poczekać do wyjścia wag K3.1, dostanie wtedy trzeci wariant do porównania kwantyzacji. I wreszcie ktoś, kto chce po prostu darmowego czatu bez decyzji o planie: obaj producenci mają plan zero, więc test własny kosztuje tylko wieczór.
FAQ
GLM czy Kimi do kodowania?
GLM ma dedykowany Coding Plan (Lite 10 tysięcy kredytów tygodniowo od 18 dolarów, 12,60 przy rocznym rozliczeniu) i tańsze API z cache po 3 centach na Flashu. Kimi odpowiada wyższym zmierzonym wynikiem agentowym (Terminal-Bench 4.0: 67% wg AA, odczyt 24 października; na wspólnej skali indeksu v5.0 z odczytu 2 listopada 46 punktów wobec 32), ale bez planu abonamentowego dla programistów. Wybór sprowadza się do przewidywalnego rachunku kontra najwyższy zmierzony wynik.
Który jest tańszy, GLM czy Kimi?
Na poziomie tokenów GLM wygrywa w każdym wymiarze cennika: flagowce 1,40/4,40 dolara za milion tokenów wobec 2/10 u K3.1 Pro, szybkie warianty 0,15/0,50 wobec 4/20 u Highspeed (odczyty 24-28 października 2026). Pomiar kosztu całego zadania odwraca jednak obraz: 5,01 dolara dla GLM-5.3 wobec 3,68 u K3.1 Pro wg AA z 2 listopada 2026.
Czy GLM i Kimi mają otwarte wagi?
Tak, obie rodziny: GLM-5.3 od 28 sierpnia 2026 (Flash z 6,4 miliona pobrań), Kimi K3 od 13 czerwca (852 tysiące). Pełne wagi K3.1 Pro są zapowiedziane najpóźniej na 4 listopada 2026.
Co z wersjami K2 i porównaniami starszymi?
Kimi K2 jest wygaszany: od 31 października 2026 nowym kontom już nie będzie dostępny, a starsze porównania z K2 w autocomplecie odnoszą się do modelu schodzącego z oferty. Aktualna para to GLM-5.3 i K3.1 Pro.
Źródła
- Cennik API Z.ai z rodziną GLM-5.3, https://z.ai (odczyt 28 października 2026, headless)
- GLM Coding Plan z kredytami tygodniowymi, https://z.ai (odczyt 28 października 2026, headless)
- Cennik API Moonshot AI, https://platform.kimi.ai/ (odczyt 28 października 2026)
- Plany konsumenckie Kimi, https://www.kimi.com/membership/pricing (odczyt 28 października 2026, interfejs chiński)
- Indeks v5.0 Artificial Analysis dla GLM-5.3 i K3.1 Pro, https://artificialanalysis.ai/models/glm-5-3 (odczyt 2 listopada 2026)
- Nasz tekst o GLM z historią rodziny i cenami, https://technetblog.pl/2026/10/glm-ai/ (opublikowany 28 października 2026)
- Nasz tekst o Kimi z tabelą planów, https://technetblog.pl/2026/10/kimi-ai/ (opublikowany 28 października 2026)
- Nasz tekst o wycieku GLM-5.3 na Workers AI, https://technetblog.pl/2026/10/glm-53-wyciek-cache/ (opublikowany 27 października 2026)