Uczenie maszynowe to sposób budowania programów, w których komputer wyciąga reguły z danych, zamiast dostawać je zapisane linijka po linijce przez człowieka. Definicja jest prosta, ale zaraz za nią zaczyna się bałagan, bo w mediach i ofertach „AI”, „uczenie maszynowe” i „deep learning” brzmią jak synonimy, a nimi nie są: to zagnieżdżone zbiory. Sztuczna inteligencja to parasol, uczenie maszynowe jest jego częścią, deep learning częścią tej części, a modele językowe, o których piszę w Podstawy AI, siedzą jeszcze głębiej, w samym deep learningu. Rozdzielam je w tym tekście bez jednego wzoru, na przykładach z codzienności: filtr spamu, rekomendacje w sklepie, podejrzana transakcja na karcie. Dorzucam krótką historię nazwy i wyjaśnienie, czemu marketing woła „AI” na wszystko, co ma model w środku. Definicje sprawdziłem w dokumentacji IBM, AWS i Google oraz w Wikipedii, z odczytem z 15 października 2026.
- Uczenie maszynowe co to właściwie znaczy?
- Trzy pojęcia, jeden parasol: jak te nazwy się zagnieżdżają?
- Skąd wzięła się nazwa „uczenie maszynowe”?
- Jak maszyna się uczy, skoro nikt nie wpisuje jej reguł?
- Głębokie uczenie maszynowe co to jest i gdzie w tym siedzą LLM-y?
- Gdzie codziennie dotykasz uczenia maszynowego?
- Kiedy „AI” w opisie produktu to tylko marketing?
- Najważniejsze informacje
- Najczęstsze pytania
Uczenie maszynowe co to właściwie znaczy?
Wikipedia podaje definicję, od której można zacząć bez strachu: uczenie maszynowe to dziedzina sztucznej inteligencji zajmująca się algorytmami statystycznymi, które uczą się z danych, uogólniają na dane, których wcześniej nie widziały, i dzięki temu wykonują zadania „bez bycia jawnie zaprogramowanymi” („without being explicitly programmed”). AWS mówi krócej: to rodzaj sztucznej inteligencji, która analizuje dane „bez jawnych instrukcji” („without explicit instructions”), znajduje wzorce w danych historycznych i przewiduje relacje, których wcześniej nikt nie zestawił. Nie ma w środku listy reguł wpisanej przez programistę. Jest zbiór przykładów i procedura, która z nich korzysta.
Różnica widać najlepiej na zwykłym filtrze spamu. W podejściu regułkowym analityk musiałby ręcznie wymyślić uniwersalne kryteria, na przykład „jeśli w tytule jest nagroda, wyrzuć wiadomość”. Dokumentacja IBM układa to wprost: przy regułkach potrzeba człowieka, który takie kryteria wymyśli, a przy uczeniu maszynowym wystarczy dobrać algorytm i porządny zbiór przykładowych maili. Model w trakcie treningu dostaje wiadomości, przewiduje, które są spamem, mierzy swój błąd i poprawia ustawienia, aż trafia coraz lepiej. Reguły wynikają z danych, a nie z głowy człowieka. Stąd cała nazwa: maszyna, która się uczy, a nie maszyna, która wie.
Trzy pojęcia, jeden parasol: jak te nazwy się zagnieżdżają?
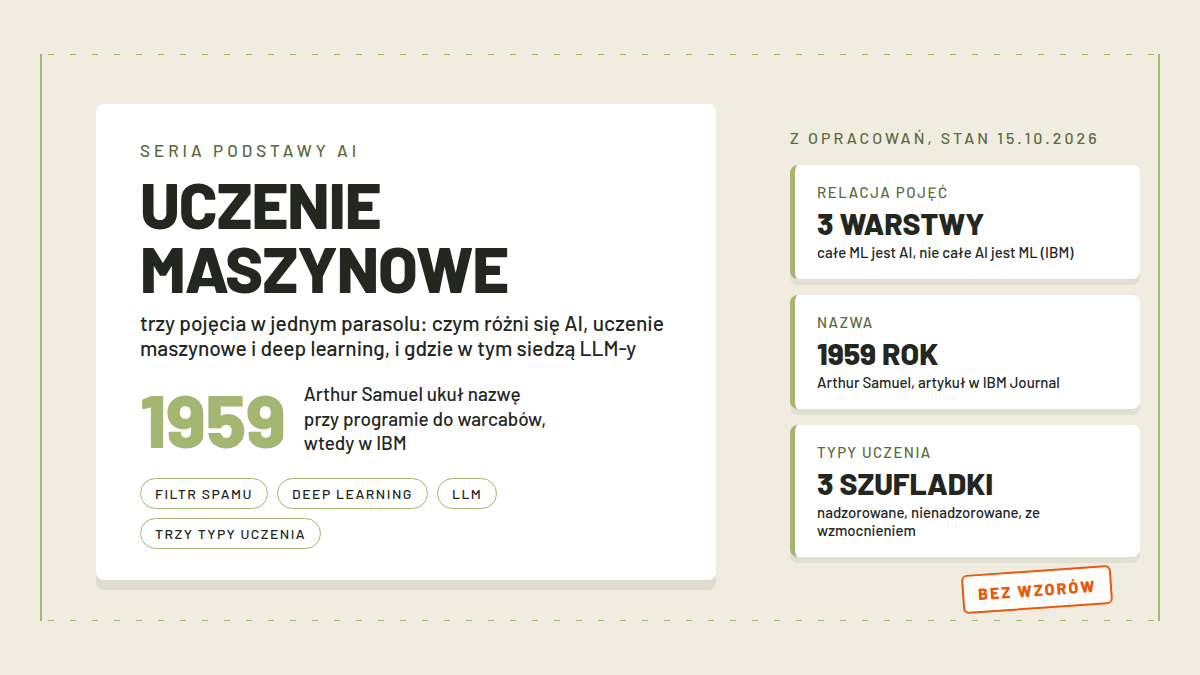
Najkrótsze wyjaśnienie relacji daje IBM: „wszystkie uczenie maszynowe to AI, ale nie całe AI to uczenie maszynowe” („all machine learning is AI, but not all AI is machine learning”). AI obejmuje bowiem także systemy sterowane zwykłymi regułkami, bez śladu uczenia. IBM jako przykład podaje termostat z regułą w stylu „jeśli temperatura spadnie poniżej progu, włącz ogrzewanie”: to sztuczna inteligencja w luźnym, potocznym sensie i zero uczenia w ścisłym.
| Pojęcie | Co obejmuje | Przykład z życia |
|---|---|---|
| AI | każde zadanie kojarzone z inteligencją, także systemy regułkowe | termostat włączający grzanie poniżej progu |
| Uczenie maszynowe | część AI, w której reguły model wyciąga z danych | filtr spamu uczony na mailach oznaczonych przez ludzi |
| Deep learning | część ML oparta na sieciach neuronowych o wielu warstwach | rozpoznawanie mowy i tłumaczenie maszynowe |
| LLM | część deep learningu przewidująca tokeny tekstu | modele stojące za czatami odpowiadającymi po polsku |
Z tej kaskady wynika jedna praktyczna rzecz. Ktoś mówi „to jest AI” i zdanie jest prawdziwe o każdym z poziomów, tylko nie mówi prawie nic: mogła to być sieć neuronowa albo trzy warunki w skrypcie. Ktoś mówi „to deep learning” i już zawęża: na pewno sieci neuronowe, na pewno dużo danych. Ktoś mówi „LLM” i wiadomo, że mowa o modelu przewidującym tokeny w tekście.
Skąd wzięła się nazwa „uczenie maszynowe”?
Nazwa nie wypadła z powietrza i ma jednego autora. Według Wikipedii termin „machine learning” ukuł w 1959 roku Arthur Samuel, amerykański informatyk, pionier gier komputerowych i sztucznej inteligencji, pracujący wtedy w IBM, a później przeniesiony na Stanford. Wikipedia dodaje ciekawostkę językową: przez pewien czas obok niego funkcjonował synonim „self-teaching computers”, komputery, które uczą się same.
Samuel jest też autorem programu grającego w warcaby, jednego z pierwszych na świecie udanych programów samouczących się, jak ocenia Wikipedia. Punktem odniesienia dla całej dziedziny jest artykuł Samuela z 1959 roku w IBM Journal zatytułowany „Some Studies in Machine Learning Using the Game of Checkers”. Dokumentacja IBM cytuje z jego wstępu zdanie, które dziś czyta się jak manifest: „komputer można zaprogramować tak, by nauczył się grać w warcaby lepiej, niż gra osoba, która go napisała” („a computer can be programmed so that it will learn to play a better game of checkers than can be played by the person who wrote the program”). Maszyna miała pobijać wyniki własnego twórcy: taki był cel projektu.
IBM dodaje uczciwe zastrzeżenie: nazwa jest „często przypisywana” artykułowi Samuela, choć sama koncepcja jest starsza. W praktyce wystarczy tyle: słowo ma ponad 65 lat i narodziło się przy planszy do warcabów, nie przy czatach.
Jak maszyna się uczy, skoro nikt nie wpisuje jej reguł?
Pętla jest w zarysie zawsze ta sama. Na wejściu są dane, które trzeba najpierw posprzątać: AWS opisuje cztery etapy pracy, przygotowanie danych, trening modelu, ocenę na osobnym zbiorze walidacyjnym i optymalizację. W trakcie treningu model dostaje przykłady, coś przewiduje, porównuje wynik z prawdziwą odpowiedzią i koryguje swoje parametry, żeby następnym razem pomylić się mniejszym błędem. IBM pisze o „optymalizowaniu regulowanych parametrów algorytmu dla większej dokładności”. Nic w tym nie jest magią: statystyka powtarzana tysiące razy pod rząd.
Wewnątrz tej pętli mieszczą się trzy rodzaje uczenia. IBM zalicza każdą metodę uczenia maszynowego do jednej z trzech: nadzorowanego, nienadzorowanego albo ze wzmocnieniem. Różnica sprowadza się do tego, co model dostaje na wejściu.
| Typ uczenia | Co dostaje model | Przykład z życia |
|---|---|---|
| Nadzorowane | przykłady razem z poprawnymi odpowiedziami, czyli etykietami | maile oznaczone jako „spam” i „nie spam” |
| Nienadzorowane | dane bez etykiet, model sam szuka grup i wzorców | sklep dzielący klientów na segmenty o podobnych nawykach |
| Ze wzmocnieniem | nagrody za dobre ruchy w środowisku | program uczący się wygrywać w gry planszowe |
Słownik Google dodaje obraz, który łatwo wynieść z tego rozdziału: uczenie nadzorowane jest jak nauka przedmiotu przez rozwiązywanie zestawu pytań z odpowiedziami, bo po opanowaniu mapowania uczeń radzi sobie już z nowymi pytaniami z tego samego tematu. Uczenie ze wzmocnieniem to w tym samym słowniku rodzina algorytmów uczących się optymalnej strategii przez maksymalizację nagrody, a przy grach ostateczną nagrodą jest zwycięstwo. Programy uczące się gier, od warcabów Samuela poczynając, wracają więc w tej dziedzinie regularnie.
Głębokie uczenie maszynowe co to jest i gdzie w tym siedzą LLM-y?
Deep learning to część uczenia maszynowego oparta na sztucznych sieciach neuronowych. AWS nazywa ją „wyspecjalizowaną formą uczenia maszynowego, która używa sztucznych sieci neuronowych, by naśladować ludzki mózg” i wskazuje, że to ona położyła fundament pod rozwój generatywnej AI. Wikipedia dopowiada mechanikę: w deep learningu sieć ma wiele ukrytych warstw, a sieci neuronowe stosowano już przy zadaniach od widzenia komputerowego i rozpoznawania mowy, przez tłumaczenie maszynowe, po gry i diagnozę medyczną. IBM odnotowuje, że przez ostatnie dekady ta architektura została standardem w niemal każdej dziedzinie, w której w ogóle używa się AI.
I właśnie tutaj, w najgłębszym kręgu, siedzą LLM-y. Dokumentacja IBM definiuje je bez owijania: dużym modelem językowym jest kategoria modeli deep learningu trenowanych na ogromnych ilościach danych, zdolnych rozumieć i generować język naturalny oraz inne treści. Są zbudowane na architekturze sieci neuronowej zwanej transformerem, a IBM opisuje ich pracę obrazowo: to „gigantyczne maszyny statystycznych przewidywań, które w kółko przewidują następne słowo w sekwencji”. Trening zaczyna się od masowej ilości tekstu: miliardów albo bilionów słów z książek, artykułów, stron i kodu, rozbitych na jednostki zwane tokenami. Jeśli chcesz zejść poziom niżej, napisałem osobno o tym, co to jest LLM, co to jest token AI i jak AI się uczy.
Moduł o dużych modelach językowych z kursu Machine Learning Crash Course od Google tłumaczy to najkrócej: model językowy estymuje prawdopodobieństwo tokenu albo sekwencji tokenów w dłuższej sekwencji, co umożliwia generowanie tekstu, tłumaczenie i streszczanie. Brzmi to daleko od „inteligencji” z plakatów. Na marginesie: przewidywanie kolejnego słowa to dla części badaczy za mało na pełny obraz maszyny myślącej, Yann LeCun ma na ten temat własny program badawczy skupiony wokół modeli świata i pisałem o nim osobno. A jeśli w medialnych rozmowach „AI” znaczy „coś jak człowiek we wszystkim”, to mowa o AGI, czyli ogólnej sztucznej inteligencji, rozbieram to pojęcie w wpisie o AGI.
Gdzie codziennie dotykasz uczenia maszynowego?
Skrzynka odbiorcza to klasyk: opisany wyżej filtr spamu, w którym model klasyfikuje wiadomości na podstawie przykładów, a nie sztywnych reguł. Rekomendacje to druga codzienność: AWS opisuje, że sklepy polecają produkty na podstawie wcześniejszych zakupów, historii przeglądania i wyszukiwania, a serwisy streamingowe dobierają rekomendacje pod konkretnego widza. Trzecia rzecz dzieje się przy płaceniu: według AWS organizacja finansowa może wytrenować system do klasyfikowania transakcji na prawdziwe i oszukańcze, a system, po znalezieniu wzorców w znanych danych, ocenia, czy nowa transakcja jest legalna.
Model pracuje też na danych bez etykiet: IBM wymienia klastrowanie, czyli grupowanie według podobieństwa, używane między innymi przy segmentacji rynku i wykrywaniu oszustw. A jeśli korzystasz z automatycznego tłumacza albo dyktujesz wiadomości głosem, dotykasz głębokiego uczenia: Wikipedia wymienia tłumaczenie maszynowe i rozpoznawanie mowy wśród zadań sieci neuronowych. Szerzej rozumiane AI sięga według AWS jeszcze dalej, od asystentów głosowych jak Alexa, przez chatboty i generatory obrazów, po roboty odkurzające i auta jeżdżące samodzielnie. Tyle że nie wszystko z tej listy jest uczeniem maszynowym i właśnie dlatego poprzedni rozdział ma sens.
Kiedy „AI” w opisie produktu to tylko marketing?
Terminy są mieszane od dawna i Wikipedia odnotowuje to bez owijania: od początku lat 2010 „machine learning” i „artificial intelligence” bywają używane zamiennie, choć nie są synonimami. IBM dopowiada powód kulturowy: w wyobraźni publicznej „AI” kojarzy się z science fiction, czyli z tym, co poprawniej nazywa się AGI, na przykład HAL 9000 z „Odysei kosmicznej 2001” i Ava z „Ex Machiny”, a ostatnio z AI generatywną. Skoro tak, etykieta „AI” jest tania i skuteczna: obejmuje wszystko, od sieci neuronowej po trzy warunki w termostacie, a brzmi sprzedażowo lepiej niż „regresja logistyczna”. Nikt nie musi nawet kłamać, wystarczy wybrać najszersze słowo z parasola.
Możliwe, że pytasz, po co ci to rozróżnienie, skoro cały świat pisze „AI”. Po pierwsze newsy: gdy wiadomość mówi „AI wykryło X”, rozróżnienie podpowiada, czy autorzy opisują model językowy, klasyfikator trenowany na przykładach, czy zwykłą automatyzację z warunkami. Po drugie oferty pracy: wymagania w projekcie, który skleja LLM-y z istniejącym oprogramowaniem, i w projekcie nad danymi tabelowymi i klasycznymi modelami różnią się mocno. Po trzecie wybór narzędzia: produkt reklamowany „z AI” może mieć w środku zwykłą automatyzację, która wobec nowych sytuacji nie pomoże, i widać to dopiero po ustaleniu, o który poziom zagnieżdżenia chodzi. To moja rada praktyczna, nie cytat z dokumentacji.
Najważniejsze informacje
| Pojęcie | W jednym zdaniu | Źródło z datą |
|---|---|---|
| Uczenie maszynowe | dziedzina AI: algorytmy statystyczne uczą się z danych i uogólniają na nowe dane, bez jawnego programowania | Wikipedia EN, odczyt 15.10.2026 |
| Nazwa | termin „machine learning” ukuł Arthur Samuel w 1959, przy programie do warcabów w IBM | Wikipedia EN, odczyt 15.10.2026 |
| Relacja AI i ML | całe ML jest AI, ale nie całe AI jest ML | IBM, aktualizacja 02.10.2026 |
| Trzy typy uczenia | nadzorowane, nienadzorowane i ze wzmocnieniem, każda metoda ML wpada do jednej z tych trzech szuflad | IBM, aktualizacja 02.10.2026 |
| Deep learning | część ML oparta na sieciach neuronowych o wielu warstwach, fundament AI generatywnej | Wikipedia EN i AWS, odczyt 15.10.2026 |
| LLM | kategoria modeli deep learningu trenowanych na ogromnych zbiorach tekstu, architektura transformer | IBM, odczyt 15.10.2026 |
| Trening LLM | start od miliardów albo bilionów słów z książek, stron i kodu, rozbitych na tokeny | IBM, odczyt 15.10.2026 |
| Filtr spamu | ML wystarczy zbiór przykładowych maili zamiast ręcznych reguł pisanych przez analityka | IBM, aktualizacja 02.10.2026 |
Najczęstsze pytania
Uczenie maszynowe co to?
To metoda budowania programów, w których reguły nie są pisane przez człowieka, tylko wyciągane z danych: model dostaje przykłady, przewiduje, mierzy błąd i się poprawia. Wikipedia zalicza uczenie maszynowe do sztucznej inteligencji. W praktyce: filtr spamu w twojej skrzynce jest wytrenowany na mailach, nie zaprogramowany regułkami.
Uczenie maszynowe ai co to?
Ta fraza miesza dwa pojęcia, więc najprościej je rozdzielić. Sztuczna inteligencja to parasol obejmujący także systemy regułkowe, jak termostat z dokumentacji IBM, a uczenie maszynowe jest jej częścią, tą, która uczy się z danych. IBM skraca to do zdania: całe uczenie maszynowe jest AI, ale nie całe AI jest uczeniem maszynowym.
Głębokie uczenie maszynowe co to jest?
Głębokie uczenie, czyli deep learning, to część uczenia maszynowego oparta na sieciach neuronowych o wielu ukrytych warstwach. AWS opisuje je jako wyspecjalizowaną formę ML, która położyła fundament pod AI generatywną, a Wikipedia wymienia jako jego zadania między innymi rozpoznawanie mowy i tłumaczenie maszynowe. Jeszcze głębiej siedzą LLM-y, kategoria modeli deep learningu trenowanych na ogromnych zbiorach tekstu.
Uczenie maszynowe a sztuczna inteligencja?
Sztuczna inteligencja to szersze pojęcie: obejmuje każdy system wykonujący zadania kojarzone z inteligencją, łącznie z regułkami wpisanymi przez człowieka. Uczenie maszynowe to ta część AI, w której model wyciąga reguły z danych. Kiedy w opisie produktu pada samo „AI”, nie dowiesz się z niego, o którą warstwę chodzi, bo słowo pasuje do obu.
Uczenie maszynowe a deep learning?
Deep learning to podzbiór uczenia maszynowego: jeśli coś jest deep learningiem, jest automatycznie też ML i AI. Odwrotnie niekoniecznie, bo klasyczne metody ML, na przykład modele działające na tabelach, bywają bez sieci neuronowych. W praktyce deep learning pojawia się tam, gdzie dane są nieuporządkowane, jak obraz, dźwięk i tekst.
Co odróżnia uczenie maszynowe od klasycznego programowania?
W klasycznym programowaniu człowiek pisze reguły, a komputer je wykonuje. W uczeniu maszynowym podaje się przykłady i oczekiwane wyniki, a model sam dopasowuje parametry, aż błąd spadnie, jak w filtrze spamu z dokumentacji IBM. Efekt: model radzi sobie też z przypadkami, których nikt mu nie opisywał.
Źródła
- Wikipedia EN, „Machine learning”, odczyt 15.10.2026: https://en.wikipedia.org/wiki/Machine_learning
- Wikipedia EN, „Arthur Samuel (computer scientist)”, odczyt 15.10.2026: https://en.wikipedia.org/wiki/Arthur_Samuel_(computer_scientist)
- IBM, „What is machine learning?”, publikacja 18.08.2025, aktualizacja 02.10.2026, odczyt 15.10.2026: https://www.ibm.com/think/topics/machine-learning
- IBM, „What are large language models (LLMs)?”, publikacja 06.10.2021, odczyt 15.10.2026: https://www.ibm.com/think/topics/large-language-models
- AWS, „What is Machine Learning?”, odczyt 15.10.2026: https://aws.amazon.com/what-is/machine-learning/
- Google, „Machine Learning Crash Course”, kurs od 2018, odczyt 15.10.2026: https://developers.google.com/machine-learning/crash-course
- Google, „Introduction to Large Language Models” (moduł MLCC), odczyt 15.10.2026: https://developers.google.com/machine-learning/crash-course/llm
- Google, „Machine Learning Glossary”, odczyt 15.10.2026: https://developers.google.com/machine-learning/glossary
- Link wewnętrzny, Podstawy AI (hub), odczyt 15.10.2026: https://technetblog.pl/podstawy-ai/
- Link wewnętrzny, Co to jest LLM, odczyt 15.10.2026: https://technetblog.pl/2026/10/co-to-jest-llm/
- Link wewnętrzny, Jak AI się uczy, odczyt 15.10.2026: https://technetblog.pl/2026/10/jak-ai-sie-uczy/
- Link wewnętrzny, Co to jest token AI, odczyt 15.10.2026: https://technetblog.pl/2026/10/co-to-jest-token-ai/
- Link wewnętrzny, Yann LeCun i modele świata, odczyt 15.10.2026: https://technetblog.pl/2026/10/yann-lecun-modele-swiata/
- Link wewnętrzny, Co to jest AGI, odczyt 15.10.2026: https://technetblog.pl/2026/10/co-to-jest-agi/