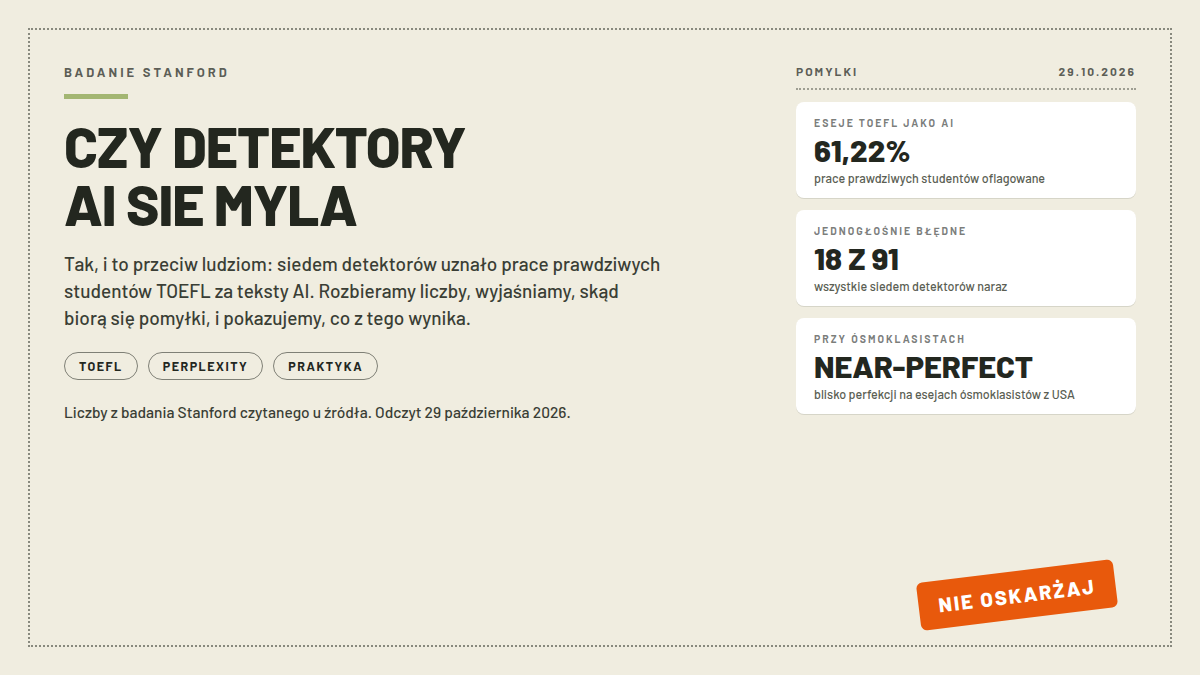
„Czy detektory AI się mylą” to pytanie, na które odpowiedź jest krótsza niż zwykle: tak, mylą się, i to w najbardziej niebezpieczną stronę, oskarżając ludzi o teksty, których nie napisali. Pytanie „czy tekst napisał chatgpt” i wariant „czy mozna sprawdzic czy tekst napisał chatgpt” z polskiego autocompletu zakładają, że istnieje narzędzie dające pewność. Nie istnieje, a najlepszym dowodem jest badanie naukowców ze Stanford, które czytaliśmy bezpośrednio u źródła i którego liczby cytujemy poniżej z datą odczytu. To jest także teza całego klastra detektor AI: traktuj wyniki procentowe jak podejrzenia, nie wyroki.
- Najważniejsze informacje
- Co dokładnie pokazało badanie Stanford
- Dlaczego detektory nie potrafią zrobić tego, co obiecuje marketing
- Teksty po polsku: mniejsza pewność, nie większa
- Co z tego wynika dla praktyki
- FAQ
Najważniejsze informacje
| Liczba z badania | Co znaczy |
|---|---|
| 61,22% | tyle esejów TOEFL prawdziwych, nieanglojęzycznych studentów zostało uznanych za napisane przez AI |
| 19% | tyle prac (18 z 91) wszystkie siedem detektorów błędnie uznało za AI jednogłośnie |
| 97% | tyle prac (89 z 91) oflagował przynajmniej jeden detektor |
| „near-perfect” | ten sam zestaw detektorów radził sobie wzorowo na esejach ósmoklasistów urodzonych w USA |
| „unreliable” | tak wprost naukowcy opisują rzetelność detektorów po przeliczeniu wyników |
Co dokładnie pokazało badanie Stanford
Naukowcy ze Stanford wzięli 91 prac TOEFL, czyli testu językowego pisanych przez prawdziwych, nieanglojęzycznych studentów, oraz zestaw esejów ósmoklasistów urodzonych w USA, i przepuścili wszystko przez siedem publicznie dostępnych detektorów AI. Na esejach amerykańskich ósmoklasistów detektory wypadły, cytując stronę Stanford, „near-perfect”, blisko perfekcyjnie. Te same narzędzia na esejach TOEFL uznały za wygenerowane przez AI ponad połowę prac, dokładnie 61,22 procent. Siedem detektorów jednogłośnie i błędnie wskazało 18 z 91 prac jako AI, a przynajmniej jeden detektor oflagował 89 z 91.
Badacze podkreślają, że problem nie polega na jednej wadliwej aplikacji, tylko na samej metodzie. W cytowanym przez Stanford wyjaśnieniu James Zou, profesor nauk o danych biomedycznych i starszy autor badania, mówi, że detektory oceniają tekst według miary nazywanej perplexity, która koreluje z wyrafinowaniem języka, a w wyrafinowaniu osoby piszące w obcym języku naturalnie ustępują rodowitym Amerykanom. Werdykt badania brzmi wprost, że detektory nie są szczególnie rzetelne, a liczby stawiają poważne pytania o obiektywność i o to, że obcokrajowcy mogą być niesłusznie oskarżani o ściąganie albo karani.
Dlaczego detektory nie potrafią zrobić tego, co obiecuje marketing
Detektor nie czyta umysłu autora. Ocenia, jak bardzo tekst przypomina statystyczny ślad produkcji modelu językowego: gładkie, prawdopodobne następy słów, równy rytm, brak zgrzytów. Z tej konstrukcji pomyłki wchodzą z dwóch stron. Człowiek piszący starannie, według wzorców albo w obcym języku, produkuje tekst „zbyt gładki” jak na człowieka i zostaje oflagowany. Z kolei tekst AI po przepisaniu przez człowieka albo po poleceniu „napisz to bardziej literacko” zsuwa się w stronę wyniku ludzkiego. Zou opisuje wprost, że detektory daje się łatwo obejść inżynierią promptu i podaje przykład polecenia o podniesieniu literackiego poziomu tekstu.
Do tego dochodzi brak jakiegokolwiek dowodu odwrotnego. Kiedy detektor mówi „97% AI”, osoba oskarżona nie ma sposobu, by udowodnić, że pisała sama, bo nie istnieje test dający wynik „na pewno człowiek”. W systemie, w którym decyzje podejmuje się na podstawie procentu, to jest właśnie najgroźniejsza pomyłka: asymetria dowodu zawsze działa przeciwko człowiekowi.
Teksty po polsku: mniejsza pewność, nie większa
Polski kontekst jest tu istotny, więc mówimy wprost, co wynika ze źródeł, a co z naszego rozumowania. Badanie Stanford robiono na tekstach angielskich i to zastrzeżenie powtarzamy za źródłem. Z kolei same detektory przyznają, że angielski to ich najsilniejsza strona: GPTZero pisze wprost „detection is strongest in English” z rozszerzaniem się na kolejne języki, Scribbr wymienia w przykładach niemiecki, francuski i hiszpański, a Copyleaks deklaruje ponad 30 języków bez listy. Z tych dwóch faktów wynika rozsądny wniosek: jeśli detektory mylą się na angielskich tekstach realnych studentów, to na polskich tekstach margines błędu jest co najmniej nie mniejszy, choć nikt go nie policzył. Twierdzimy to jako wniosek z cytowanych źródeł, nie jako wynik pomiaru.
W Polsce jest jeszcze jeden gracz, o którym trzeba wiedzieć, żeby nie dublować narzędzi. Politechnika Warszawska sprawdzi każdą pracę dyplomową własnym systemem JSA zintegrowanym z USOS i APD, metodą prawdopodobieństwa fraz, co opisaliśmy z odczytem i cytatem w tekście o AI w pracy dyplomowej. System ocenia, a decyzję podejmuje człowiek. To ważna różnica wobec detektorów online: w uczelnianym obiegu wynik nie pada na głowę studenta jako wyrok procentowy.
Co z tego wynika dla praktyki
Jeśli oceniasz cudze teksty, zamień procent na pytanie. Detektor daje podstawę do rozmowy o tym, jak tekst powstał, i do sprawdzenia rzeczy weryfikowalnych: czy źródła z bibliografii istnieją, czy cytaty padły naprawdę, czy konkretne daty i miejsca się zgadzają. Halucynacje wychwytuje zwykłe czytanie, o czym piszemy w tekście o halucynacjach AI, i to one zdradzają więcej niż styl.
Jeśli broniisz własnego tekstu przed niesłusznym oflagowaniem, masz słabszą pozycję, niż powinieneś mieć, i trzeba to nazwać. Pomaga historia wersji dokumentu, szkice i notatki, czyli ślad procesu pisania, którego generator nie zostawia. Rozstrzygający znak wodny w treści tekstów na dziś nie istnieje; co wiadomo o znakowaniu generacji ChatGPT opisujemy w tekście o znaku wodnym ChatGPT. Nie ma sensu „humanizować” własnych tekstów, żeby oszukać detektor, bo wtedy faktycznie zaczynasz wyglądać jak ktoś, kto ma co ukrywać. A jeśli chcesz wiedzieć, skąd w detektorach w ogóle bierze się przekonanie o stylu AI, zacznij od tekstu o sprawdzaniu, czy tekst jest napisany przez AI, gdzie tłumaczymy mechanizm krok po kroku.
FAQ
Czy detektory AI się mylą?
Tak. W badaniu Stanford siedem detektorów uznało 61,22% esejów prawdziwych studentów TOEFL za teksty AI, a 18 z 91 prac oflagowały jednogłośnie wszystkie narzędzia. Ta sama seria detektorów radziła sobie blisko perfekcyjnie na esejach amerykańskich ósmoklasistów, więc problem siedzi w metodzie oceny, nie w jednej aplikacji.
Czy można sprawdzić, czy tekst napisał ChatGPT?
Na sto procent nie ma takiej możliwości. Detektor ocenia podobieństwo stylu do produkcji modeli, a nie pochodzenie tekstu, więc zarówno człowiek piszący gładko, jak i AI po przepisaniu tekstu zaburzają wynik. Najbliższe prawdy to rzeczy weryfikowalne: istnienie źródeł, historia pisania w dokumencie i rozmowa z autorem.
Czy tekst napisał chatgpt, jeśli detektor pokazuje 90%?
Nie musi, bo procent opisuje pewność narzędzia, nie udział AI w tekście. Badanie Stanford pokazało, że ta pewność bywa błędna wobec prawdziwych autorów, więc przy wysokiej stawce (praca dyplomowa, praca zawodowa) wynik traktuj jako impuls do rozmowy, nigdy jako rozstrzygnięcie.
Źródła
- Stanford HAI, badanie detektorów na esejach TOEFL i wyniki procentowe, https://hai.stanford.edu/news/ai-detectors-biased-against-non-native-english-writers (odczyt 29.10.2026)
- Politechnika Warszawska o JSA i metodzie prawdopodobieństwa fraz, z odczytem cytowana w naszym tekście, https://technetblog.pl/2026/10/ai-w-pracy-dyplomowej/ (nasz tekst, odczyt 27.10.2026)
- GPTZero, zastrzeżenie o najmocniejszej detekcji w angielskim, https://www.gptzero.me/pricing (odczyt 29.10.2026)
- Scribbr, lista języków w przykładach, https://www.scribbr.com/ai-detector/ (migawka 23.10.2026)
- Copyleaks, deklaracja detekcji w ponad 30 językach, https://copyleaks.com/pricing (migawka 05.10.2026)