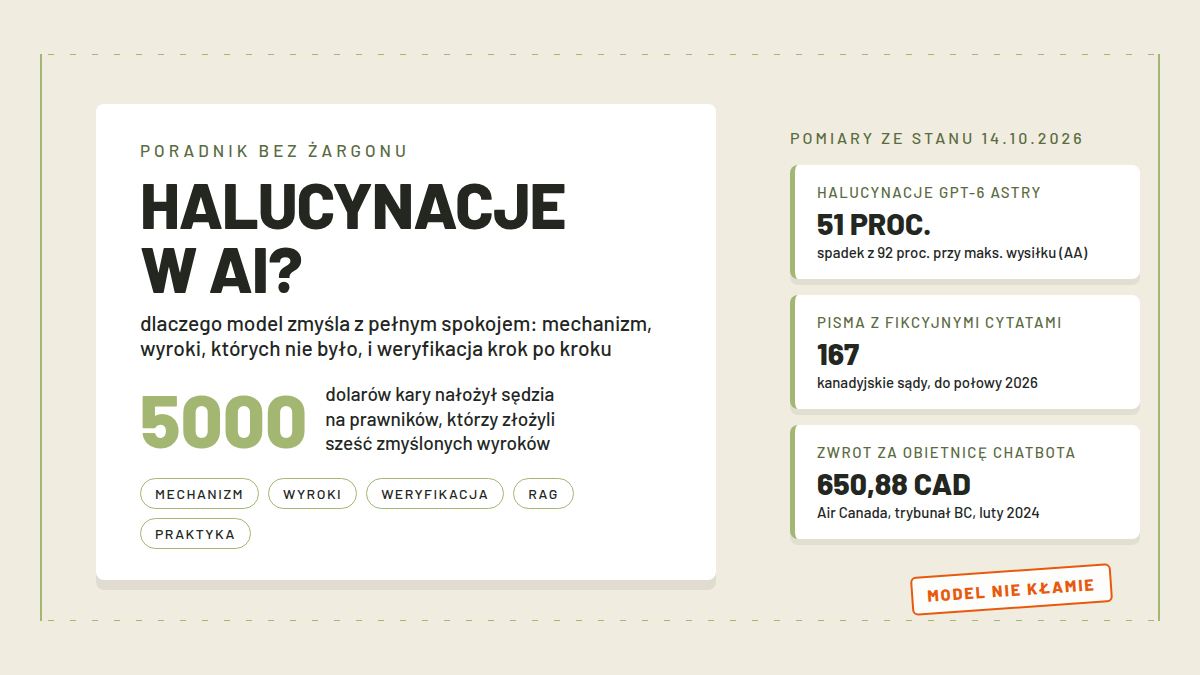
Halucynacje AI to odpowiedź zmyślona i podana z pełnym spokojem: wyrok sądowy, którego nigdy nie było, badanie, którego nikt nie przeprowadził, cena, która nigdy nie obowiązywała. Model nie sygnalizuje, że właśnie zgaduje, i właśnie dlatego sprawa jest poważna, a fraza „halucynacje ai co to” regularnie pojawia się w podpowiedziach Google. Wyjaśniamy tu mechanizm bez matematyki, pokazujemy, ile kosztowali prawnicy, którzy ufili czatowi z podejrzanymi precedensami, piszemy, jak sprawdzamy odpowiedzi u nas w redakcji i co realnie ogranicza te wpadki. To tekst z serii „AI bez żargonu”, całość zbiera strona Podstawy AI: 30 pytań i odpowiedzi.
- Najważniejsze informacje
- Model przewiduje słowa, a nie fakty
- Dlaczego halucynacja nie jest kłamstwem
- Sześć zmyślonych wyroków i obietnica chatbota
- Jak my sprawdzamy odpowiedzi modeli
- Co realnie ogranicza halucynacje
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Definicja | Fałszywa lub myląca informacja podana jak fakt; model nie sygnalizuje, że zgaduje |
| Mechanizm | Model przewiduje kolejny fragment tekstu; płynna nieprawda bywa bardziej prawdopodobna niż „nie wiem” |
| Klasyczny przypadek | Mata v. Avianca, Nowy Jork: 6 zmyślonych precedensów od ChatGPT, kara 5000 dolarów (czerwiec 2023) |
| Kolejny przypadek | Air Canada: trybunał kazał dotrzymać obietnicy chatbota, zwrot 650,88 CAD (luty 2024) |
| Co pomaga | Zgoda na „nie wiem”, odpowiedzi budowane z cytatów, podpięte źródła (RAG), wyższy wysiłek rozumowania |
| Czego nie ma | Wyłącznika halucynacji; dokładność modelu nigdy nie sięgnie 100 procent |
| Nasza praktyka | Liczby sprawdzane u źródła, drugie źródło na fakty prasowe, kontrola linków z odpowiedzi |
Model przewiduje słowa, a nie fakty
Duży model językowy, ten sam, który pracuje pod ChatGPT, Claude i Gemini, w każdej chwili swojej pracy robi jedno: liczy, jaki fragment tekstu najpewniej pojawi się następny. Nie zagląda do bazy wyroków ani do encyklopedii, dopóki producent nie podpiął mu wyszukiwania odgórnymi mechanizmami; kontynuuje ciąg znaków na podstawie wzorców wchłoniętych w treningu. Jak działa ta maszyna zgadywania, opisaliśmy w pierwszym tekście serii, podstawach LLM, tu wystarczy konsekwencja: skoro zadaniem modelu jest dokończyć zdanie najlepszym kandydatem, to przy braku wiedzy wygrywa kandydat najbardziej prawdopodobny językowo, a nie najbardziej prawdziwy. Tytuł wyroku sądowego z datą, sygnaturą i cytatami wygląda po prostu dobrze, niezależnie od tego, czy istnieje.
Badacze OpenAI opublikowali w 2025 roku rozbiór tego zjawiska i wskazali dwa źródła problemu. Pierwsze siedzi w pretrainingu: model ogląda wyłącznie płynny tekst i dostaje nagrodę za trafne zgadywanie następnego fragmentu, więc wzorce języka, od ortografii po styl uzasadnień prawnych, łapie znakomicie, ale jednostkowy fakt, na przykład datę urodzin konkretnego sędziego, da się zgadywać z szansą jeden do trzystu sześćdziesięciu pięciu i żaden wzorzec tego nie naprawi. Drugie źródło to sposób mierzenia: tabele wyników liczą zwykle samą trafność odpowiedzi, więc zawsze opłaca się strzelać, bo wstrzymanie się daje zero punktów. Efekt się sumuje: model uczy się, że pewna odpowiedź zawsze bije przyznanie się do niewiedzy.
Sama nazwa bywa myląca, bo sugeruje, że model coś widzi albo czuje, a badacze kłócą się o nią od lat; w hasełach encyklopedycznych obok halucynacji pojawia się konfabulacja i fabrykacja, wszystkie opisują to samo: fałszywą lub mylącą informację przedstawioną jako fakt. Zespół interpretowalności Anthropic doszedł w 2025 roku do mechanizmu na poziomie obwodów: w modelu istnieją struktury, które zwykle tłumią odpowiedź na pytanie spoza wyuczonej wiedzy, a przy niektórych bodźcach, na przykład rozpoznanym nazwisku bez tła faktograficznego, to tłumienie zawodzi. To dobrze opisuje codzienne doświadczenie: model myli się najczęściej tam, gdzie temat wygląda znajomo, a danych brakuje, czyli przy rzadkich szczegółach znanych postaci, lokalnych instytucjach i wąskich dziedzinach.
Dlaczego halucynacja nie jest kłamstwem
Kłamstwo wymaga dwóch rzeczy naraz: wiedzy, jak wygląda prawda, oraz zamiaru jej zatajenia. Model nie ma ani jednej, ani drugiej, bo w trakcie generowania odpowiedzi nie trzyma w sobie modelu świata do porównania z tym, co właśnie pisze; pisze dalej. Pewny ton to wyuczony styl, po prostu treningowe teksty rzadko męczą się w połowie zdania, więc kontynuacja brzmi zawsze równie stanowczo, czy mówi o stolicy Polski, czy o urojonym precedensie. Badacze OpenAI definiują halucynację wprost jako sytuację, w której model pewnie generuje odpowiedź, która nie jest prawdziwa, i to „pewnie” jest słowem kluczem: pewność jest z zewnątrz nieodróżnialna od wiedzy.
Rozróżnienie nie jest akademickie, bo określa, co można z tym zrobić. Kłamcy można zarzucić złe intencje i stracić do niego zaufanie raz na zawsze; maszynie zgadywania można zarzucić co najwyżej konstrukcję i pracować nad tym, by zgadywała rzadziej oraz by miała wyjście awaryjne w postaci „nie wiem”. Nie znaczy to niewinności skutków: zmyślony wyrok złożony do sądu kogoś realnie kosztuje, o czym za chwilę. Znaczy tylko tyle, że przestroga „przestań kłamać” w prompcie nic nie naprawi, bo nie ma czego przestać.
Sześć zmyślonych wyroków i obietnica chatbota
Najsłynniejsza historia zaczyna się banalnie: w 2022 roku mężczyzna pozwał linię lotniczą Avianca o obrażenia, a sprawą zajęła się nowojorska kancelaria Levidow, Levidow & Oberman. Prawnik Steven Schwartz, szukając precedensów do pisma, zapytał ChatGPT i dostał listę orzeczeń, w tym sprawę Varghese v. China Southern Airlines, kompletną z datą i cytatami. Wiosną 2023 roku prawnicy strony przeciwnej zgłosili, że nie mogą znaleźć tych wyroków w żadnej bazie, a sędzia Kevin Castel z sądu federalnego na Manhattanie ustalił, że sześć z przytoczonych spraw to nieistniejące orzeczenia. Schwartz złożył wtedy oświadczenie, w którym przyznał, że zapytał czat, czy te sprawy są prawdziwe, a ten zapewnił, że tak, i że znajdą je w serwisach Westlaw i LexisNexis; dodał, że nie był świadomy możliwości, że treść z narzędzia może być fałszywa. Sam zmyślony Varghese okazał się zniekształconą wersją realnego wyroku Zicherman v. Korean Air Lines z 1996 roku, z datą przesuniętą o dwanaście lat.
Finał nastąpił 23 czerwca 2023 roku. Sędzia Castel nałożył na Schwartza i Petera LoDucę, który figurował jako pełnomocnik w sprawie, karę 5000 dolarów, pisząc, że prawnicy porzucili swoje obowiązki, składając nieistniejące orzeczenia z fałszywymi cytatami, a jedno z pism zawierało fragmenty wręcz bezsensowne. W tej samej opinii zaznaczył, że nie ma nic niewłaściwego w korzystaniu z niezawodnego narzędzia AI, więc problemem nie było narzędzie, lecz brak weryfikacji. Kancelaria odpowiedziała, że to pomyłka w dobrej wierze, bo nikt w niej nie wierzył, że technologia potrafi wymyślać sprawy z niczego; sam pozew przepadł i tak z powodu przedawnienia. Od tamtej pory sprawa Mata v. Avianca funkcjonuje w podręcznikach jako przykład, i wcale nie odosobniony: encyklopedia odnotowuje, że do połowy 2026 roku kanadyjskie sądy zarejestrowały już 167 pism z fikcyjnymi cytatami, a zbierana publicznie baza takich wpadek przekroczyła 1300 incydentów.
Druga głośna sprawa pokazuje, że halucynacje wypalają się także znakom firmowych, nie tylko rozmówcom w czacie. Pod koniec 2022 roku Jake Moffatt pytał chatbota Air Canada o taryfę żałobną, a ten obiecał zwrot różnicy ceny w ciągu 90 dni od wystawienia biletu, czego na stronie linii nie było. Po podróży na pogrzeb w rodzinie linia odmówiła zwrotu, więc Moffatt poszedł do cywilnego trybunału rozstrzygającego spory konsumenckie w Kolumbii Brytyjskiej, a ten w lutym 2024 roku nakazał linii zapłacić 650,88 dolara kanadyjskiego z odsetkami i kosztami. Air Canada broniła się przed trybunałem twierdzeniem, że chatbot to odrębna osoba prawna odpowiedzialna za własne słowa; członek trybunału Christopher Rivers nazwał ten argument osobliwym i wyjaśnił, że nie ma znaczenia, czy informacja pochodzi ze statycznej strony, czy z chatbota.
Jak my sprawdzamy odpowiedzi modeli
U nas w redakcji odpowiedź modelu to początek drogi, nigdy koniec. Każdą liczbę wracamy do źródła: cenę do cennika producenta, limit do centrum pomocy, datę do komunikatu prasowego, a nie do czatu, który tę datę kiedyś wchłonął albo właśnie wymyślił. Fakty prasowe, zwłaszcza te z kategorii „podobno ktoś powiedział”, dopuszczamy dopiero przy drugim niezależnym źródle, bo jedna publikacja potrafi powielić cudzą pomyłkę. Linki z odpowiedzi otwieramy i sprawdzamy, czy istnieją i czy prowadzą tam, gdzie obiecywały, bo zmyślone źródło to zmyślony fakt w przebraniu bibliografii.
Jednego zaś nie robimy w ogóle: nie pytamy tego samego modelu, czy mówi prawdę. Sprawa Avianki pokazała to dosłownie, bo czat pod przysięgą potwierdzał własne zmyślenia w rozmowie z prawnikiem, który szczerze chciał się upewnić. Ryzyko różnicuje też stawka: przy burzy mózgów, stylizacji tekstu czy szkicu kodu tolerujemy znacznie więcej niż przy pieniądzach, zdrowiu i prawie, gdzie weryfikacja jest bezwzględna. Kwestia zaufania ma zresztą dwie strony, bo skoro czat potrafi zmyślać w odpowiedziach, to potrafi też gromadzić to, co o tobie wie, o czym piszemy osobno w rozbiórce śledzenia w ChatGPT.
Co realnie ogranicza halucynacje
Producenci wiedzą, gdzie siedzi problem, i dokumentują sprawdzone sposoby. Dokumentacja Anthropic zaleca najpierw proste rzeczy: pozwolić modelowi powiedzieć „nie wiem”, co według autorów radykalnie zmniejsza ilość fałszywych informacji; przy dłuższych dokumentach kazać mu najpierw wyciągnąć cytaty słowo w słowo, a dopiero potem odpowiadać; przy każdej tezie wymagać podparcia cytatem i kazać ją wycofać, gdy podparcia brakuje; wreszcie ograniczyć odpowiedzi wyłącznie do podanych materiałów, zamiast pozwalać sięgać do wyuczonej wiedzy ogólnej. W produktach konsumenckich ten sam kierunek widać jako podpinanie wyszukiwarki i źródeł pod odpowiedź, czyli technika zwana RAG: model zanim odpowie, dostaje fragmenty zewnętrznych tekstów i buduje wypowiedź na nich, a czytelnik dostaje linki do sprawdzenia. U nas w redakcji działa to samo: teksty piszemy z dokumentów otwartych w drugim oknie, nie z pamięci modelu.
Drugi kierunek to trening i ustawienia. Badacze OpenAI pokazali na przykładzie pytań o fakty, że model wytrenowany do wstrzymywania się odpowiedział „nie wiem” przy 52 procentach pytań, a błędy popełnił w 26 procentach, podczas gdy porównywany model starszej generacji wstrzymał się ledwie przy 1 procencie i błędów zrobił 75 procent; wniosek autorów brzmi, że kalibracja, czyli świadomość własnej niepewności, jest tańsza niż poprawianie samej dokładności. Potwierdzają to niezależne pomiary: w pomiarach Artificial Analysis, które cytujemy w analizie GPT-6 Astry, odsetek halucynacji spadł z 92 do 51 procent po przełączeniu modelu na maksymalny wysiłek rozumowania. To dużo, ale wciąż nie zero, i zero nie będzie: według tych samych badaczy dokładność nigdy nie sięgnie 100 procent, bo część pytań jest z natury bez odpowiedzi. Wyłącznika halucynacji nie ma, jest tylko lista sposobów na trzymanie ich w ryzach, a po stronie użytkownika najprostszy z nich brzmi: wybieraj czat, który pokazuje źródła, i traktuj każdy konkret bez źródła jak hipotezę.
Najczęstsze pytania
Co to są halucynacje AI?
To odpowiedź modelu zawierająca zmyśloną informację podaną jak fakt: nieistniejący wyrok, badanie, link czy cena. Model nie wie, że zmyśla, bo pewny ton to wyuczony styl, a nie sygnał wiedzy.
Dlaczego AI zmyśla odpowiedzi?
Bo jego zadaniem jest przewidzenie najbardziej prawdopodobnego następnego fragmentu tekstu, a nie sprawdzenie faktu w bazie. Gdy danych brakuje, wygrywa płynna kontynuacja, a trening i rankingi wyników nagradzają zgadywanie zamiast przyznawania się do niepewności.
Jak sprawdzić, czy odpowiedź AI to halucynacja?
Każdą liczbę i nazwę sprawdź u pierwotnego źródła, otwórz linki z odpowiedzi i zobacz, czy istnieją i prowadzą tam, gdzie obiecywały. Przy faktach z prasy poszukaj drugiego niezależnego źródła; pytanie „czy to prawda?” zadane temu samemu modelowi nic nie daje.
Czy da się wyłączyć halucynacje w ChatGPT?
Nie ma takiego przełącznika ani w aplikacji, ani w API. Ryzyko realnie zmniejszają czaty z podpiętym wyszukiwaniem i cytowaniami, zgoda modelu na odpowiedź „nie wiem” oraz tryby głębszego rozumowania, ale żaden nie zeruje zjawiska.
Czy każdy model AI halucynuje?
Tak, każdy, bo mechanizm przewidywania tekstu jest wspólny całej rodzinie. Różni się częstość: w pomiarach Artificial Analysis GPT-6 Astra obniżył halucynacje z 92 do 51 procent po włączeniu maksymalnego wysiłku rozumowania, a według badaczy OpenAI dokładność 100 procent pozostaje nieosiągalna.
Źródła
- Hallucination (artificial intelligence), Wikipedia (EN), definicja, mechanizmy, zestawienie incydentów: https://en.wikipedia.org/wiki/Hallucination_(artificial_intelligence)
- A lawyer used ChatGPT and now has to answer for its „bogus” citations, The Verge, 27 maja 2023: https://www.theverge.com/2023/5/27/23739913/chatgpt-ai-lawsuit-avianca-airlines-chatbot-research
- Two US lawyers fined for submitting fake court citations from ChatGPT, The Guardian, 23 czerwca 2023: https://www.theguardian.com/technology/2023/jun/23/two-us-lawyers-fined-submitting-fake-court-citations-chatgpt
- Air Canada ordered to pay customer who was misled by airline’s chatbot, The Guardian, 16 lutego 2024: https://www.theguardian.com/world/2024/feb/16/air-canada-chatbot-lawsuit
- Why language models hallucinate, OpenAI, 2025: https://openai.com/index/why-language-models-hallucinate/
- Reduce hallucinations, dokumentacja Anthropic (platform.claude.com), odczyt 14 października 2026: https://platform.claude.com/docs/en/test-and-evaluate/strengthen-guardrails/reduce-hallucinations