Ściągasz model z Hugging Face albo z biblioteki Ollamy, wpisujesz pytanie po polsku, a w odpowiedzi dostajesz dokończenie własnego zdania, listę przypadkowych akapitów albo anglojęzyczny blok tekstu o czymś innym. Pierwsza reakcja bywa dwójaka: albo „model jest zepsuty”, albo „polski nie działa”. Nic z tych dwóch. Pobrałeś model bazowy (base), a tam, gdzie chodzi o rozmowę, potrzebny jest wariant instruct. Rozróżnienie jest zresztą mylące samo w sobie, bo producenci oznaczają je różnie: raz dopiskiem Base, raz -Instruct, raz -it, a raz wcale.
Ten tekst porządkuje temat na materiałach, które czytałem 25 października 2026: kartach Qwena, Mistrala, Bielika i Gemmy, dokumentacji Hugging Face i pracy naukowej, od której cała nazwa się wzięła. Nie testowałem modeli pod tym wpisem, więc nie znajdziesz tu własnych pomiarów, za to znajdziesz dokładne wskazówki, jak czytać nazwy i karty, żeby nie pobrać drugi raz tego samego w złym wariancie. Najbardziej przyda się osobom, które zaczynają z modelami lokalnymi i chcą wiedzieć, co dokładnie oznaczają te dopiski w nazwach, zanim zapełnią dysk drugą kopią tego samego.
- Najważniejsze informacje
- Dwa etapy treningu, nie dwa modele
- Czemu baza nie odpowiada na pytania
- Jak rozpoznać wariant po nazwie
- Kiedy baza ma sens
- Najczęstsze pytania
Najważniejsze informacje
| Co | Baza (base) | Instruct |
|---|---|---|
| Etap treningu | tylko pretraining | pretraining + post-training |
| Zachowanie po pytaniu | kontynuuje i dokańcza tekst | odpowiada na polecenie |
| Qwen | dopisek Base, np. Qwen3-8B-Base | zwykle bez dopisku, np. Qwen3-8B |
| Mistral | Mistral-7B-v0.3 | dopisek -Instruct, np. Mistral-7B-Instruct-v0.3 |
| wariant pre-trained | dopisek -it (instruction tuned), np. Gemma3-4B-IT | |
| Typowa rola | dalsze dostrajanie własnymi danymi | czat, pomoc w pracy, agenci |
Dwa etapy treningu, nie dwa modele
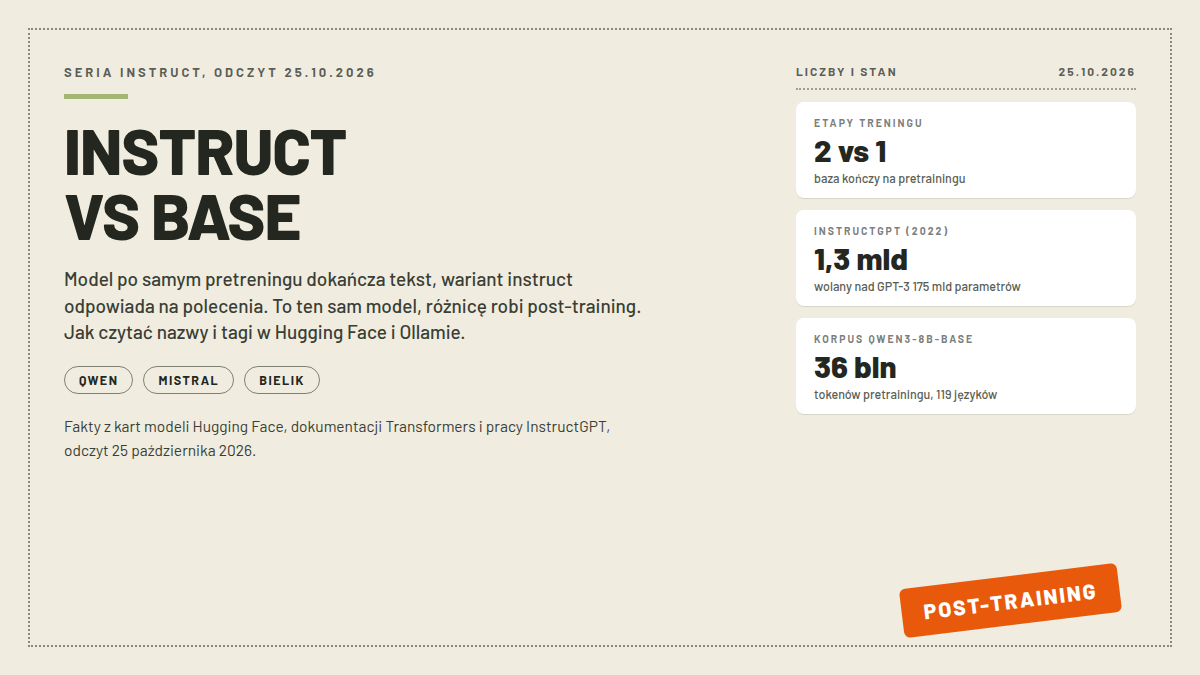
Model bazowy to model po pierwszym etapie treningu, zwanym pretreningiem. Skala tego etapu robi wrażenie: karta Qwen3-8B-Base podaje 36 bilionów tokenów na 119 językach. Baza przez cały ten czas robi jedną rzecz, uczy się zgadywać, jaki fragment tekstu pojawi się po danym miejscu. Po pretreningu model zna język i sporo świata, nie zna za to rozmowy jako takiej. Karta mówi to formalnie, jednym wpisem: Training Stage: Pretraining.
Wariant instruct to dokładnie ten sam model po drugim etapie, zwanym post-trainingiem. Nie ma tu osobnej architektury ani osobnego zbioru wiedzy, jest genealogia i producenci zapisują ją wprost. Karta Qwen3-8B, czyli wariantu bez żadnego dopisku, prowadzi w metadanych pole base_model: Qwen/Qwen3-8B-Base, a etap treningu opisuje jako Pretraining & Post-training. Mistral idzie o krok dalej i pisze to pierwszym zdaniem karty: „The Mistral-7B-Instruct-v0.3 Large Language Model (LLM) is an instruct fine-tuned version of the Mistral-7B-v0.3”. Instruct to dostrajona wersja bazy, nic więcej.
Na czym polega ten drugi etap. Zespół przygotowuje zbiór przykładów dialogów, model dopasowuje się do nich w zwykłym dostrajaniu, a potem następuje część z ocenami ludzi: model generuje odpowiedzi, ludzie je rangują, a model uczy się od rankingów. Całość opisano w pracy z 2022 roku, która dała temu rozróżnieniu nazwę, Ouyang i in., „Training language models to follow instructions with human feedback”. Wychodzą z niej modele InstructGPT i pada tam liczba, która najlepiej pokazuje, ile post-training zmienia: w ocenach ludzi odpowiedzi InstructGPT o 1,3 mld parametrów wygrywały z odpowiedziami GPT-3 o 175 mld parametrów, choć mniejszy model był sto razy lżejszy. Dostrajanie nie dokłada wiedzy, dokłada zachowanie, i to zachowanie robi całą różnicę między „model rozumie polecenie” a „model dokańcza tekst”. Autorzy definiują problem jasno: duże modele nie są z natury dopasowane do intencji użytkownika, potrafią generować odpowiedzi nieprawdziwe, toksyczne albo po prostu nienaprawdę pomocne, a samo powiększanie modelu tego nie naprawia. Dostrajanie z ludzkim feedbackiem poprawiło w ich pomiarach prawdomówność i zmniejszyło toksyczność wyjścia przy „minimal performance regressions on public NLP datasets”, czyli przy znikomych stratach na klasycznych benchmarkach. Wariant czatowy nie jest więc gorszym modelem, który zapłacił uprzejmością za wyniki.
Jeśli chcesz zejść głębiej w samą mechanikę dostrajania, mamy o tym osobny tekst.
Zanim zejdziemy z tematu terminologii: w materiałach różnych wydawców spotkasz te same pojęcia pod różnymi postaciami. „Instruct fine-tuned” z karty Mistrala, „instruction finetuned” z raportu Gemmy, dopisek IT przy nazwach modeli i napis „post-training” u Qwena opisują ten sam drugi etap. Nie ma tu podziału na lepsze i gorsze określenia, to wyłącznie zwyczaje nazewnicze, które warto czytać jako jedno pojęcie.
Czemu baza nie odpowiada na pytania
Baza robi w odpowiedzi na twoje pytanie dokładnie to, do czego została wytrenowana: przewiduje kontynuację. Pytanie wpisywane w okno to dla niej fragment dokumentu, więc model dokańcza ten dokument. Jak pytanie brzmi jak początek wypracowania, dostaniesz wypracowanie. Jak brzmi jak nagłówek listy, możesz dostać całą listę. Żadnej złośliwości w tym nie ma, to po prostu jedyna umiejętność, jaką baza wyniosła z pretreningu.
Skąd ta pomyłka bierze się w praktyce. Biblioteka Ollamy praktycznie nie serwuje baz, więc użytkownik tego narzędzia spotka je rzadko. Na Hugging Face jest odwrotnie: wyszukiwarka pokazuje oba warianty obok siebie, a linki z tutoriali i filmów prowadzą nieraz prosto do repozytorium bazowego, bo autor poradnika skopiował adres z notki o pretreningu. Konsternacja przychodzi, gdy ktoś ściąga wagi na dysk, ładuje je do LM Studio albo innego silnika i zadaje pierwsze pytanie. Wyjście wygląda jak poprawny tekst, czasem nawet nawiązuje do tematu, tylko nigdy nie jest odpowiedzią na zadane pytanie.
Wariant instruct był dostrajany na dialogach zapisanych w konkretnym formacie, z tokenami kontrolnymi oddzielającymi role. Dokumentacja Hugging Face pokazuje to na dwójce modeli dostrajonych z tej samej bazy Mistral-7B: Mistral-7B-Instruct używa tokenów [INST] i [/INST] do zaznaczenia początku i końca wiadomości użytkownika, a Zephyr-7B tokenów <|user|> i <|assistant|> do zaznaczenia ról. Dokumentacja dodaje zdanie, które dobrze podsumowuje, czemu to nie jest detal: przy złych tokenach kontrolnych „these models would have drastically worse performance”.
Ten format nazywa się szablonem rozmowy i w praktyce nie musisz go znać, dopóki korzystasz z gotowych narzędzi. Ollama, LM Studio i podobne dobierają szablon za ciebie na podstawie karty modelu. Różnica ujawnia się, gdy ręcznie sklejasz wagi z silnikiem albo piszesz własny skrypt: wtedy szablon trzeba dobrać świadomie, bo ten sam model z niewłaściwym szablonem odpowiada wyraźnie gorzej.
Jak rozpoznać wariant po nazwie
Zwyczaje nazewnicze są różne u różnych wydawców, ale dają się spisać na jednej liście:
- Qwen: wariant czatowy zwykle bez dopisku (Qwen3-8B), baza z dopiskiem Base (Qwen3-8B-Base).
- Mistral: baza bez dopisku (Mistral-7B-v0.3), czatowy z dopiskiem -Instruct (Mistral-7B-Instruct-v0.3).
- Google: czatowy z dopiskiem -it, czyli instruction tuned; raport Gemma 3 mówi wprost o wersjach „pre-trained” i „instruction finetuned”, a modele noszą nazwy typu Gemma3-4B-IT.
- Bielik: Bielik-11B-v2.3-Instruct, a karta w metadanych pokazuje całą genealogię, bazę speakleash/Bielik-11B-v2 i poprzednie warianty Instruct 2.0 do 2.2.
- Biblioteka Ollamy: tagi mówią wprost, na przykład
gemma3:12b-it-q4alboqwen3:235b-a3b-instruct-2507-q8.
O polskim Bieliku pisaliśmy osobno, ale linia nazw dobrze pokazuje, jak to wygląda w praktyce jednego zespołu: najpierw baza, potem kolejne warianty czatowe dopieszczane na jej podkładzie.
Ten sam model potrafi mieć kilka wariantów czatowych naraz, i to też widać w nazwach. Biblioteka Ollamy dla dużego Qwena serwuje obok siebie qwen3:235b-instruct i qwen3:235b-thinking, a seria oznaczona 2507 idzie o krok dalej, z osobnymi tagami instruct-2507 i thinking-2507 dla tego samego rozmiaru. Dopisek mówi wtedy nie tylko „to jest model do rozmowy”, ale i „w tym kierunku był dostrajany”. Różnicę między tymi dwoma kierunkami rozkładamy w osobnym pojeździe z tej serii, bo zasługuje na własny tekst.
Uwaga na jedną pułapkę: brak dopisku nie zawsze znaczy bazę. U Qwena to odwrotnie, czatowy wariant nie nosi żadnego dopisku, a bazowy dostaje Base. Dlatego przy ręcznym ściąganiu wag z Hugging Face czytaj kartę, nie nazwę katalogu: wpis Training Stage i pole base_model rozstrzygają w kilka sekund. Biblioteka Ollamy jest tu łatwiejsza, bo serwuje warianty czatowe jako domyślne, a osobne warianty oznacza w tagach, jak widać na przykładzie Qwena z serii 2507 czy Gemmy z dopiskiem -it.
Jeśli budujesz własny warsztat na otwartych wagach, uporządkowany przegląd tego, co dostępne, znajdziesz w tekście o otwartych modelach AI, a pełny spis naszych materiałów o lokalnej pracy jest na hubie lokalne AI.
Kiedy baza ma sens
Pierwszy przypadek to dalsze dostrajanie własnymi danymi. Kto buduje własny wariant czatowy na własnym korpusie, zwykle zaczyna od bazy, a nie od cudzego wariantu czatowego, bo post-training zostawia w modelu wzorce odpowiedzi, które własny trening musiałby dopiero wypierać. Mistral opisuje tę relację zaskakująco szczerze w sekcji ograniczeń karty: „The Mistral 7B Instruct model is a quick demonstration that the base model can be easily fine-tuned to achieve compelling performance”. Ich czatowy wariant jest demonstracją, że z bazy da się wyciągnąć dobry model dostrajaniem, więc baza pozostaje surowcem. Polska praktyka wygląda podobnie, skoro Bielik buduje kolejne warianty Instruct jeden po drugim na tej samej bazie. Co ciekawe, metadane karty v2.3 noszą tagi merge i mergekit, czyli najnowszy wariant powstał też z połączenia modeli z linii, nie wyłącznie z jednego treningu. To pokazuje, że baza i wcześniejsze warianty żyją własnym życiem jako materiał, z którego składa się następne kroki zespołu.
Drugi przypadek to zadania, w których oczekujesz kontynuacji, nie odpowiedzi: dopisywanie tekstu w utrwalonym stylu, uzupełnianie dokumentu o kolejny akapit, dokańczanie listy. Tam mechanizm bazy jest cechą, nie wadą, bo właśnie tego chcesz od modelu.
Dla reszty zastosowań reguła jest prosta. Rozmowa, pomoc w pracy, agenty, cokolwiek co ma na ciebie odpowiadać: instruct. Wątpliwość, po którą stronę padnie twoje użycie: instruct, bo wariant czatowy nigdy nie zaszkodzi tam, gdzie wystarczyłaby baza, a odwrotnie bywa bolesne. W Ollamie trafisz na wariant czatowy automatycznie, więc w praktyce decyzja zapada dopiero przy własnym dostrajaniu albo ręcznym sklejaniu wag.
Na koniec sposób na weryfikację po fakcie, gdy już coś ściągnąłeś i nie jesteś pewien, co to jest. Zadaj pytanie wymagające odpowiedzi, na przykład „który port nasłuchuje serwer SSH”. Model czatowy odpowie wprost albo przyzna, że nie wie. Baza zbuduje wokół twojego pytania dalszy tekst, bo tak ją wytrenowano. Ten pojedynczy test rozstrzyga szybciej niż dowolne czytanie nazw.
Najczęstsze pytania
Instruct vs base model: czym się różnią?
Wariant instruct to model bazowy po dodatkowym etapie treningu, post-trainingu, w którym uczy się prowadzić dialog i wykonywać polecenia. Baza kończy na pretreningu i umie tylko przewidywać kontynuację tekstu, więc na pytanie odpowiada dokańczaniem. To dokładnie ta sama architektura i te same wagi wyjściowe, różnica jest w tym, co stało się z nimi później.
Qwen instruct vs base: który wariant wybrać?
Do rozmowy i pracy w narzędziach typu Ollama wybierasz wariant bez dopisku, na przykład Qwen3-8B, bo to czatowy model z post-trainingiem. Do własnego dostrajania na własnych danych sięgasz po Qwen3-8B-Base. O pochodzeniu przekonasz się w metadanych karty, gdzie czatowy wariant prowadzi pole base_model wskazujące na bazę.
Ollama jaki model: instruct czy bazowy?
W bibliotece Ollamy domyślne tagi odpowiadają wariantom czatowym, więc przy zwykłym pobieraniu dostaniesz instruct bez podejmowania decyzji. Osobne tagi pojawiają się przy dodatkowych wariantach, jak seria instruct-2507 albo thinking-2507 u Qwena czy dopisek -it u Gemmy. Warianty bazowe w bibliotece praktycznie nie występują, bo służą treningowi, nie czatowi.
Instruct vs base llm: czy to to samo rozróżnienie?
Tak, to dokładnie ta sama para wariantów, tylko opisana inaczej. LLM to ogólne określenie dużego modelu językowego, więc fraza „instruct vs base llm” pyta o różnicę między wariantem dostrajanym do dialogu a modelem po samym pretreningu. Wszystko, co piszemy wyżej o nazwach i kartach, dotyczy jej w tym samym stopniu.
Źródła
- Karta Qwen3-8B-Base, Hugging Face (odczyt 25.10.2026): https://huggingface.co/Qwen/Qwen3-8B-Base
- Karta Qwen3-8B, Hugging Face (odczyt 25.10.2026): https://huggingface.co/Qwen/Qwen3-8B
- Karta Mistral-7B-Instruct-v0.3, Hugging Face (odczyt 25.10.2026): https://huggingface.co/mistralai/Mistral-7B-Instruct-v0.3
- Karta Bielik-11B-v2.3-Instruct, Hugging Face (odczyt 25.10.2026): https://huggingface.co/SpeakLeash/Bielik-11B-v2.3-Instruct
- Ouyang i in., Training language models to follow instructions with human feedback (arXiv, 2022): https://arxiv.org/abs/2203.02155
- Gemma 3 Technical Report (arXiv, 2025): https://arxiv.org/abs/2503.19786
- Tagi wariantów w bibliotece Ollamy: qwen3 (odczyt 25.10.2026): https://ollama.com/library/qwen3/tags
- Dokumentacja Transformers: chat templates, Hugging Face (odczyt 25.10.2026): https://huggingface.co/docs/transformers/chat_templating