Kiedy model AI odpowiada nie tak, jak byś chciał, najczęściej winne jest polecenie. Czasem jednak poprawianie promptu przestaje wystarczać i na stole pojawia się fine-tuning, czyli dostrajanie: douczenie gotowego modelu na własnych przykładach tak, żeby zmienił zachowanie na stałe, a nie tylko w obrębie jednej rozmowy. To trzeci i najdroższy poziom dostosowania modelu do swoich potrzeb, obok promptu i RAG-a, i poziom, wokół którego narosło najwięcej mitów. W tym tekście z serii Podstawy AI rozkładam go na części: od definicji, przez przebieg według dokumentacji i realne ceny, po ryzyka, o których poradniki mówią zbyt mało. Jedno zastrzeżenie na start: nie dostrajałem sam żadnego modelu, więc każdy opis praktyki opieram na dokumentacji producentów, z odnośnikami do źródeł na końcu.
- Co to jest fine tuning i czemu nie jest treningiem od zera
- Czym różni się fine-tuning od promptu i od RAG-a
- Jak wygląda dostrajanie według dokumentacji OpenAI
- Ile kosztuje fine-tuning i kto go w ogóle jeszcze oferuje
- LoRA: dostrajanie, które nie rusza całego modelu
- Czego dostrajanie nie naprawi: zapominanie, przetrenowanie i własne błędy
- Najważniejsze informacje
- Najczęstsze pytania
Co to jest fine tuning i czemu nie jest treningiem od zera
Fine-tuning w uczeniu maszynowym to, zgodnie z definicją IBM, proces adaptacji modelu już wytrenowanego do konkretnych zadań albo zastosowań. Po polsku funkcjonuje też nazwa dostrajanie, czasem strojenie, i dalej używam tych słów zamiennie, bo tak ta fraza żyje w polskich wyszukiwarkach. Istota jest prosta: zamiast budować model od zera bierzesz model, który umie już bardzo dużo, i doszkolasz go na niewielkim zbiorze przykładów pokazujących, jak ma reagować w twoim konkretnym przypadku.
W literaturze to podejście nazywa się transfer learning, wykorzystaniem wiedzy zdobytej wcześniej przez inny trening. Hugging Face, którego biblioteki służą między innymi do treningu otwartych modeli, formułuje to jeszcze ostrzej: dostrajanie to kontynuacja treningu dużego wytrenowanego modelu na mniejszym zbiorze danych, różniąca się od pretreningu tylko tym, że nie zaczynasz od losowych wag, a wymaga dużo mniej mocy obliczeniowej, danych i czasu. Wagi to najprościej mówiąc parametry modelu, miliony albo miliardy liczb dopasowywanych podczas nauki. Jeśli chcesz zobaczyć pełny obraz, od pretreningu po dostrajanie, opisałem go osobno w tekście jak AI się uczy.
Skala oszczędności robi wrażenie. Trening dużego modelu językowego od zera oznacza klastry liczone w tysiącach kart graficznych, tygodnie obliczeń i zbiory treningowe rzędu bilionów słów. IBM przypomina przy okazji o pułapce: trening od zera na małym zbiorze grozi przetrenowaniem, czyli sytuacją, w której model świetnie radzi sobie z przykładami treningowymi, ale słabo uogólnia na nowe dane. Dostrajanie odwraca proporcje, bo szeroka wiedza jest już wbudowana w model, a ty dokładasz tylko wąski, konkretny zestaw przykładów. Dlatego tak powstają asystenci do obsługi zgłoszeń, klasyfikatory wiadomości albo modele mówiące żargonem jednej branży.
Czym różni się fine-tuning od promptu i od RAG-a
Najprościej myśleć o trzech poziomach ingerencji. Pierwszy to prompt, czyli polecenie: zmieniasz tekst, dokładasz kontekst i przykłady w rozmowie, a model pozostaje nietknięty. Drugi to RAG, od retrieval augmented generation: podpinasz pod model wyszukiwanie po własnych dokumentach i model z nich cytuje, choć sam wciąż jest ten sam. IBM definiuje RAG jako architekturę łączącą model z zewnętrznymi bazami wiedzy i podkreśla, że dzięki temu narzędzia tworzą trafniejsze treści domenowe bez dalszego treningu, co pozwala uniknąć kosztów ponownego szkolenia. Trzeci poziom to właśnie fine-tuning: zmieniasz same wagi modelu i ta zmiana zostaje.
Różnica sprowadza się do pytania, czy twój problem dotyczy wiedzy, czy zachowania. RAG podsuwa modelowi fakty, ale nie zmienia sposobu, w jaki mówi. Dostrajanie wyćwicza formę, format, ton albo klasyfikację, ale nie nauczy modelu wydarzeń z wczoraj, bo wiedza ogólna zostaje zamrożona w chwili treningu. OpenAI w przewodniku wymienia zalety dostrajania wprost: krótsze prompty bez stosu przykładów, oszczędność tokenów przy dużej skali i niższe opóźnienia, trening na danych zastrzeżonych bez wysyłania ich w każdym zapytaniu, a także możliwość wyszkolenia mniejszego, tańszego i szybszego modelu, który jedno zadanie robi tak dobrze jak duży.
Z tej kolejności wynika praktyczna reguła, którą sam stosuję przy ocenie pomysłów na dostrajanie: najpierw popraw prompt, potem podpinaj RAG-a, a model doszkalaj dopiero wtedy, gdy oba zawiodły, bo jest to najdroższa i najtrudniejsza do cofnięcia opcja.
Jak wygląda dostrajanie według dokumentacji OpenAI
Najpełniejszy opis praktyczny pozostaje w dokumentacji OpenAI, choć z ważną gwiazdką, do której wrócę przy kosztach. Proces ma tam pięć kroków: zbierasz zbiór przykładów, wgrywasz go w formacie JSONL, tworzysz zadanie dostrajania, przy jednej z metod definiujesz jeszcze oceniającego, na końcu oceniasz wynik.
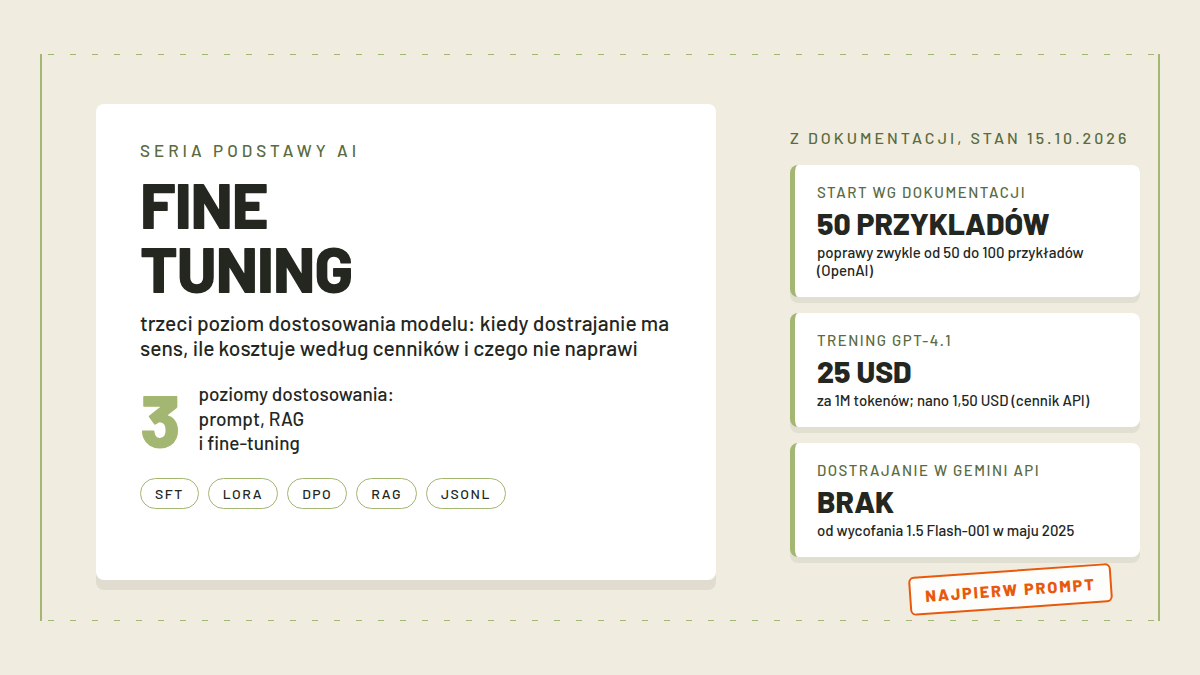
JSONL to plik tekstowy, w którym każda linia to kompletny obiekt JSON. W praktyce każda linia to jedna wymiana z modelu: polecenie użytkownika i wzorcowa odpowiedź asystenta, w formacie znanym z czatu. Dokumentacja wymaga, żeby plik miał co najmniej 10 takich linii. Samą liczbę przykładów OpenAI też opisuje liczbowo: absolutne minimum to 10, poprawy jakości widać zwykle od 50 do 100 przykładów, a zalecanym startem jest 50 dobrze przygotowanych demonstracji i ocena wyników przed dokładaniem kolejnych. Dobre przykłady mają być realistyczne, dokładnie takie jak zapytania i odpowiedzi, których oczekujesz w swojej aplikacji, a dokumentacja sugeruje sięganie po dane historyczne, eksperckie albo logi z działającego systemu, czyli materiał, który i tak już masz, zamiast wymyślać przykłady z głowy.
Zadanie treningowe tworzy się po wskazaniu trzech rzeczy: modelu bazowego, wgranego pliku treningowego i metody. Domyślna metoda to SFT, dostrajanie nadzorowane na parach pytanie i poprawna odpowiedź. Obok niej dokumentacja opisuje DPO, gdzie podajesz odpowiedź dobrą i złą, żeby model wyczuł preferencję, oraz RFT dla modeli rozumujących, z ocenianiem wyników przez eksperta albo automatyczny grader. Lista modeli, których to dotyczy, jest przy tym daleka od najnowszych premier: dla dostrajania nadzorowanego i DPO dokumentacja wskazuje rodzinę gpt-4.1 w wariantach z 14.04.2025, dla dostrajania z obrazami gpt-4o z 06.08.2024, a dla RFT model o4-mini.
Przed wszystkim tym dokumentacja stawia ostrzeżenie, które brzmi banalnie, a decyduje o powodzeniu całości: najpierw ewaluacje. Bez niezawodnego sposobu zmierzenia, czy model dostrojony jest lepszy od bazowego, wydajesz pieniądze w ciemno. I dla jasności: nie mam własnego przebiegu tego procesu, żadnych ekranów z panelu ani moich zmierzonych liczb, więc powyższe to wierne streszczenie dokumentacji, nie relacja z praktyki.
Ile kosztuje fine-tuning i kto go w ogóle jeszcze oferuje
Tu w 2026 roku robi się najbardziej zaskakująco, bo droga dostrajania przez duże komercyjne API kurczy się na oczach. OpenAI na stronie przewodnika i na karcie cennika informuje, że wygasza platformę fine-tuningu: nowi użytkownicy nie mają już do niej dostępu, istniejący mogą tworzyć zadania treningowe przez najbliższe miesiące, a dostrojone modele zostaną dostępne do inferencji do wygaśnięcia swoich modeli bazowych. Google na oficjalnej stronie Fine-tuning with the Gemini API oświadcza, że po wycofaniu Gemini 1.5 Flash-001 w maju 2025 nie ma już modelu wspierającego dostrajanie w Gemini API ani w AI Studio, że pozostaje ono w Gemini Enterprise Agent Platform i że bezpośrednich planów powrotu nie ma. U Anthropic sprawdziłem pełny indeks dokumentacji i strony o fine-tuningu w nim nie znalazłem, więc ceny dostrajania u tego producenta: nie podano.
Ile to kosztuje tam, gdzie usługa jeszcze działa? Karta cennika OpenAI (stan 15.10.2026) liczy trening w dolarach za 1M tokenów, czyli za milion fragmentów tekstu, na jakie model dzieli dane; tokeny opisuję dokładnie w tekście co to jest token AI. Stawki treningu wynoszą 1,50 USD dla gpt-4.1-nano, 5,00 USD dla gpt-4.1-mini i 25,00 USD dla gpt-4.1 oraz gpt-4o, przy czym gpt-4o-mini ma trening za 3,00 USD. Reinforcement fine-tuning rozlicza się inaczej, po 100 USD za godzinę treningu. Koszt całego zadania zależy więc od objętości twoich przykładów i zależy tak bardzo od przypadku, że dokumentacja nie podaje żadnej typowej kwoty za jedno dostrajanie. Rachunek jest za to przewidywalny: dłuższe i liczniejsze przykłady oznaczają większy koszt, a skala tego rachunku nie ma nic wspólnego z ceną treningu modelu od zera.
Konsekwencja praktyczna jest jedna: jeśli chcesz dostrajać, najpewniej będzie to robić na otwartych wagach u dostawcy GPU albo na własnym sprzęcie, a nie u producenta dużego modelu.
LoRA: dostrajanie, które nie rusza całego modelu
Pełne dostrajanie, z aktualizacją wszystkich parametrów, dla modeli z setkami milionów albo miliardami wag jest, jak pisze IBM, często kosztowne ponad miarę. Stąd rodzi się rodzina metod pod wspólną nazwą PEFT, parametrowo efektywnego dostrajania, które aktualizują tylko wybraną część parametrów. IBM dodaje, że te metody bywają stabilniejsze od pełnego dostrajania i ograniczają zapominanie, o którym będzie niżej.
Najpopularniejszą z nich jest LoRA, low-rank adaptation, opisana w artykule Edwarda Hu i współpracowników. Mechanika, bez wzorów: oryginalne wagi modelu zostają zamrożone, a do niego dokleja się małe, dodatkowe macierze liczb, które trenujesz na swoich przykładach; ich wpływ składa się z wagami bazowymi przy generowaniu odpowiedzi. Skalę oszczędności pokazuje przykład GPT-3 z materiału IBM: pełne dostrajanie tego modelu to 175 mld trenowanych parametrów, a po zastosowaniu LoRA około 18 mln, czyli ułamek wielkości bazowego modelu, przy zapotrzebowaniu na pamięć kart graficznych niższym o mniej więcej dwie trzecie. To przykład jednego modelu, nie uniwersalna reguła, ale dobrze pokazuje proporcje. Istnieje też wariant QLoRA, który łączy obliczenia o wyższej precyzji z oszczędnym zapisem wag i dodatkowo ściska wymagania sprzętowe. Głównym pokrętłem konfiguracji jest tzw. ranga, w dokumentacji i bibliotekach oznaczana jako r: im niższa, tym mniejszy zestaw doklejanych wag i tym mniejsze wymagania treningu.
To się domyka z otwartymi modelami AI: dostrajanie otwartych wag na wynajętej karcie graficznej albo własnym komputerze jest dziś realną ścieżką, a dokumentacja Transformers od Hugging Face prowadzi od wczytania modelu, przez przygotowanie danych, po wywołanie trenera krok po kroku. Przy małych modelach to zadanie dla sprzętu klasy komputera domowego, choć im większy model, tym więcej pamięci będzie potrzebne, a przy wygaszaniu usług w dużych API ta droga staje się domyślną.
Czego dostrajanie nie naprawi: zapominanie, przetrenowanie i własne błędy
Pierwsze ryzyko ma nazwę własną: katastrofalne zapominanie, catastrophic forgetting. Według Wikipedii to skłonność sieci neuronowej do nagłego i drastycznego zapominania wcześniej nauczonych informacji w trakcie nauki nowych. W kontekście dostrajania IBM opisuje to jako utratę albo destabilizację podstawowej wiedzy modelu i zauważa, że metody PEFT ograniczają to zjawisko, podobnie jak mniejszy współczynnik uczenia. Z praktycznego punktu widzenia: model po doszkalaniu może błyszczeć w twojej domenie i jednocześnie być gorszy we wszystkim pozostałym, więc zanim zdecydujesz, sprawdź, czy nie psuje tego, co działało.
Drugie ryzyko to przetrenowanie na wąskim zbiorze. Jeśli twoje przykłady są zbyt jednorodne, model nauczy się ich niemal na pamięć i będzie słabo reagował na wszystko, co odbiega od wzorca; to ta sama mechanika, o której IBM pisze przy treningu od zera na małym zbiorze danych. Trzecie ryzyko najmniej lubię, bo nie ma technicznej łaty: dostrajanie nie weryfikuje jakości twoich przykładów. Jeżeli wzorcowe odpowiedzi zawierają błędy, uproszczenia albo niejawne uprzedzenia, model nauczy się ich jako cechy dobrze wykonanej roboty, i to będzie powtarzał z pełnym przekonaniem.
Wreszcie granica merytoryczna, o której piszę wszędzie powyżej: dostrajanie służy zachowaniu, nie aktualnej wiedzy. Jeśli problemem są fakty, które się zmieniają, dokumenty firmowe, cenniki, przepisy, właściwym narzędziem pozostaje RAG, a nie kolejna sesja treningowa. Dostrajanie traktuj jak inwestycję w stałe cechy modelu, nie jak sposób dokładania wiedzy na bieżąco.
Najważniejsze informacje
| Poziom dostosowania | Co zmieniasz | Kiedy ma sens |
|---|---|---|
| Prompt | Tylko polecenie i kontekst w rozmowie, model bez zmian | Szybkie poprawki, brak własnych danych, wymagania wciąż płynne |
| RAG | Podpinasz wyszukiwanie po własnych dokumentach | Odpowiedzi na danych, które się zmieniają i muszą być aktualne |
| Fine-tuning pełny (SFT) | Wszystkie wagi modelu na własnych przykładach | Sztywny format, styl albo klasyfikacja przy stabilnym strumieniu zadań |
| LoRA / PEFT | Mały zestaw doklejonych wag, baza zamrożona | Ten sam cel co pełne dostrajanie, przy ułamku kosztu, głównie otwarte modele |
| DPO | Podajesz odpowiedź dobrą i złą | Dopracowanie tonu i preferencji, gdy umiesz wskazać lepszą odpowiedź |
| Trening od zera | Architektura, dane i wszystkie wagi | Poza zasięgiem pojedynczego zespołu, rzadko kiedy uzasadniony |
Najczęstsze pytania
Fine tuning AI co to jest?
To doszkalanie już wytrenowanego modelu na własnych przykładach, po którym model zmienia się na stałe, bo aktualizacji ulegają jego parametry. Od promptu różni się tym, że nie działa tylko w jednej rozmowie, a od RAG-a tym, że nie podpina zewnętrznych dokumentów, tylko przebudowuje zachowanie samego modelu.
Do czego służy fine tuning modelu AI?
Dokumentacja OpenAI wymienia dla dostrajania nadzorowanego klasyfikację, wymagające tłumaczenia, generowanie treści w sztywnym formacie i korygowanie sytuacji, w których model lekceważy polecenia. To narzędzie na problemy formy i powtarzalności, nie na brak aktualnych faktów, bo do tego lepiej sprawdza się RAG.
Fine tuning vs RAG: co wybrać, gdy model odpowiada źle?
Najpierw zdiagnozuj, czego konkretnie brakuje. Jeżeli wiedzy o twoich danych, które zmieniają się w czasie, podpinaj RAG, bo pozwala aktualizować odpowiedzi bez dotykania modelu i bez kosztów ponownego treningu. Jeżeli wiedza jest w porządku, a zawodzi format, ton albo klasyfikacja, wtedy wchodzi dostrajanie.
Fine tuning vs RAG vs prompt engineering: czym się różnią?
To trzy poziomy ingerencji, od najtańszego do najdroższego. Prompt engineering zmienia tylko polecenie. RAG dołącza zewnętrzną wiedzę przez wyszukiwanie po dokumentach. Fine-tuning zmienia wagi modelu i zostaje na stałe. W praktyce zaczyna się od promptu, potem dochodzi RAG, a dostrajanie zostawia się na koniec.
Czym jest strojenie lub fine tuning modelu sztucznej inteligencji?
To dwa określenia tego samego procesu: doszkalanie gotowego, wytrenowanego modelu na mniejszym, specjalistycznym zbiorze przykładów zamiast trenowania od zera. Mechanizm opiera się na transferze wiedzy, szerokie umiejętności z pretreningu zostają, a dostrajanie dokłada tylko specjalizację.
Źródła
- OpenAI, Model optimization (przewodnik po fine-tuningu), odczyt 15.10.2026: https://platform.openai.com/docs/guides/fine-tuning
- OpenAI, Supervised fine-tuning, odczyt 15.10.2026: https://platform.openai.com/api/docs/guides/supervised-fine-tuning
- OpenAI, cennik API, zakładka Finetuning, odczyt 15.10.2026: https://platform.openai.com/docs/pricing
- Google AI for Developers, Fine-tuning with the Gemini API, odczyt 15.10.2026: https://ai.google.dev/gemini-api/docs/model-tuning
- IBM, What is Fine-Tuning?, odczyt 15.10.2026: https://www.ibm.com/think/topics/fine-tuning
- IBM, What is LoRA (Low-Rank Adaption)?, odczyt 15.10.2026: https://www.ibm.com/think/topics/lora
- IBM, What is RAG (Retrieval Augmented Generation)?, odczyt 15.10.2026: https://www.ibm.com/think/topics/retrieval-augmented-generation
- Anthropic, indeks dokumentacji Claude (llms.txt, brak sekcji o fine-tuningu), odczyt 15.10.2026: https://docs.claude.com/llms.txt
- Hugging Face, dokumentacja Transformers: Fine-tuning, odczyt 15.10.2026: https://huggingface.co/docs/transformers/main/en/training
- Wikipedia, Catastrophic interference, odczyt 15.10.2026: https://en.wikipedia.org/wiki/Catastrophic_interference