Fraza „otwarte modele AI” spływa na nas z nagłówków od dawna, ale rzadko ktoś pyta, co konkretnie jest otwarte. W praktyce chodzi najczęściej o wagi: pliki z wytrenowaną siecią neuronową, które pobierasz i uruchamiasz na własnym sprzęcie. Dane treningowe i kod, którym model uczono, zostają u producenta, a licencja bywa pisana pod konkretny biznes, nie pod ideę wolnego oprogramowania. Ten tekst rozplata te trzy wątki: co siedzi w pobranych plikach, na co pozwalają licencje i ile naprawdę kosztuje wejście, czyli sprzęt, prąd i czas. Jeśli dopiero zaczynasz i pojęcia takie jak token czy kontekst nie są ci jeszcze bliskie, najpierw zajrzyj do podstaw AI, a potem wróć tutaj.
- Otwarte modele AI to najczęściej wagi otwarte
- Czego w pobranych plikach nie ma
- Licencje w praktyce: od Apache 2.0 do Llamy
- Gdzie pobrać otwarte modele AI
- Ile sprzętu potrzeba i co robi kwantyzacja
- Bielik, czyli polski ślad
- Co się dzieje jesienią 2026
- Kiedy lokalnie ma sens, a kiedy API
- Pytania o otwarte modele
Otwarte modele AI to najczęściej wagi otwarte
Duży model językowy, o którym szerzej piszemy w tekście czym jest LLM, to w istocie wielka tablica liczb. Te liczby, nazywane wagami albo parametrami, powstają podczas treningu na ogromnych zbiorach tekstu i decydują o tym, co model odpowie na twoje pytanie. Wagi otwarte (po angielsku open weights) oznaczają, że producent wystawia te pliki do pobrania: bierzesz od kilku do kilkuset gigabajtów, ładujesz je do programu typu Ollama albo LM Studio i model odpowiada bez żadnego serwera producenta. Sieć działa cały czas u ciebie, a pytania nie opuszczają twojego dysku.
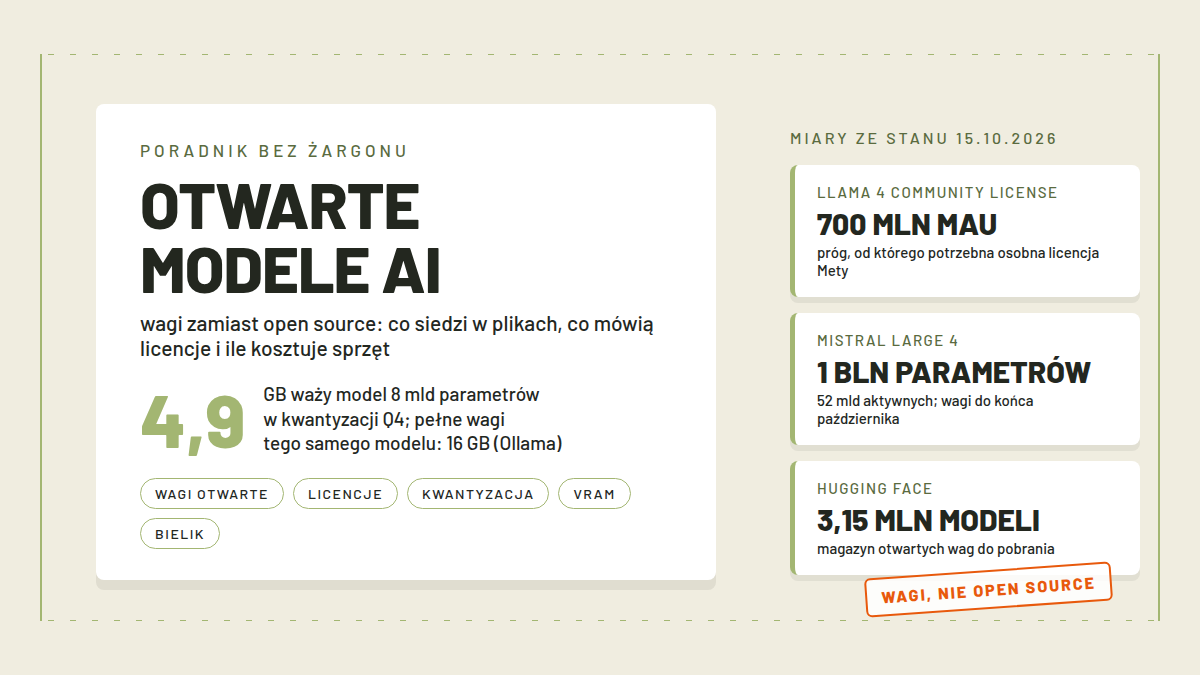
Pojęcie jest celowo nieostre i szersze niż klasyczne open source. Firma może otworzyć wagi flagowego modelu i jednocześnie zatrzymać zbiory uczące, skrypty treningowe oraz narzędzia do oceny jakości. Robi się tak z kilku powodów, ale najczęstsza jest biznesowa: skoro dostęp przez API jest płatny, darmowe wagi przyciągają deweloperów i badaczy, nie odbierając przychodów od klientów korporacyjnych. Sam magazyn takich plików, Hugging Face, widnieje dziś z licznikiem ponad 3,15 mln modeli, więc wybór jest większy, niż ktokolwiek jest w stanie przetestować.
Czego w pobranych plikach nie ma
W wagach nie znajdziesz danych treningowych. To miliony dokumentów, o których producent zwykle mówi tyle, ile musiał ujawnić w pracy naukowej: rodzina zbiorów, języki, proporcje danych syntetycznych. Nie znajdziesz też kodu treningu ani pełnej receptury, czyli wszystkiego, czego potrzeba, żeby zbudować identyczny model od zera. Replikacja pozostaje więc teoretyczna, a kontrola nad tym, co model przeczytał w trakcie nauki, w praktyce niemożliwa. Audytujesz zachowanie, nie proces.
Ciekawy wyjątek dotyczy pochodnych. Licencja Gemmy wprost zalicza do pochodnych także modele wytrenowane na danych wygenerowanych przez Gemmę, czyli destylację, więc część „DNA” modelu jest objęta warunkami licencyjnymi nawet wtedy, gdy zbudujesz własną sieć na jej odpowiedziach. Za to to, co model wypisze na ekranie, pozostaje twoje: Google deklaruje w warunkach, że nie rości praw do wyników. Rozróżnienie między wagami a wyjściem rozstrzyga większość pytań o to, czy otwarty model da się zaprząc do własnego produktu, i dlatego zwrot „outputs are not deemed model derivatives” bywa ważniejszy niż cała reszta dokumentu.
Licencje w praktyce: od Apache 2.0 do Llamy
Najczystsza sytuacja jest tam, gdzie obowiązuje Apache 2.0 albo MIT. Robisz, co chcesz, łącznie z używkiem komercyjnym i dostrajaniem, pod warunkiem zachowania informacji o licencji i autorach. Qwen3 w wariancie 32B ma Apache 2.0, DeepSeek-R1 ma MIT, Bielik ma Apache 2.0, a do tego grona dołączyły Gemma 4 oraz Mistral Large 3, co jeszcze dwa lata temu byłoby zaskoczeniem. W tych rodzinach ryzyko prawne dla małego twórcy jest w praktyce zerowe.
Llama 4 Community License brzmi przyjaźnie, ale ma trzy haczyki. Po przekroczeniu 700 mln miesięcznie aktywnych użytkowników potrzebujesz osobnej licencji od Mety, która może jej udzielić według własnego uznania. Rozprowadzając model albo produkt na nim oparty, masz obowiązek wyeksponować napis „Built with Llama” na stronie, w interfejsie czy dokumentacji. A jeśli na materiałach lub odpowiedziach Llamy wytrenujesz własny model, jego nazwa musi się zaczynać od słowa „Llama”. Do tego licencja wciela politykę akceptowalnego użycia i podlega prawu Kalifornii.
Starsze Gemmy, na przykład Gemma 3, obowiązują odrębnymi Gemma Terms of Use. Komercja formalnie niezakazana, limitów użytkowników brak, ale musisz przepasać restrykcje z polityki zakazanych zastosowań na swoich odbiorców i dołączyć odpowiednią notę. Google zastrzega też prawo zdalnego ograniczenia użycia, które uzna za naruszające warunki, co brzmi łagodnie, dopóki nie pomyślisz o produkcie zależnym od jednego dostawcy. Tabela zbiera stan na 15 października 2026.
| Rodzina i producent | Licencja | Gdzie uruchomić |
|---|---|---|
| Llama 4 (Meta) | Llama 4 Community License: próg 700 mln MAU, wymóg brandingu | Ollama, LM Studio |
| Qwen3 (Alibaba) | Apache 2.0 (sprawdzaj kartę wariantu) | Ollama, LM Studio, Hugging Face |
| Gemma 3 i 4 (Google) | Gemma Terms (3), Apache 2.0 (4) | Ollama, LM Studio, Hugging Face |
| DeepSeek-R1 (DeepSeek) | MIT | Ollama, LM Studio, Hugging Face |
| Mistral Large 3 (Mistral AI) | Apache 2.0 | Hugging Face |
| Bielik 11B (SpeakLeash, Cyfronet AGH) | Apache 2.0 | Ollama, LM Studio |
Gdzie pobrać otwarte modele AI
Trzy adresy załatwiają sprawę w zdecydowanej większości przypadków. Hugging Face pełni rolę magazynu z kartami modeli: na karcie jest licencja, rozmiary plików, warianty kwantyzacji i komentarze społeczności, a część modeli jest gated, czyli wymaga kliknięcia zgody na warunki zanim pojawi się link. To też główne miejsce publikacji dużych rodzin, od DeepSeek-R1 po wagi Mistrala, i pierwsza stacja, gdy chcesz sprawdzić, czy dana rodzina w ogóle ma otwarte pliki.
Ollama prowadzi własną, kuratorowaną bibliotekę, w której każda pozycja ma warianty i rozmiary podane od razu, a cała instalacja sprowadza się do jednej komendy w terminalu. Dla kogoś, kto chce model odpalony w pięć minut, to najkrótsza droga, szczególnie że liczniki pobrań podpowiadają, co ludzie faktycznie używają: llama3.1 ma ponad 120 mln pobrań, deepseek-r1 blisko 94 mln. Pisaliśmy o tym narzędziu osobno w tekście Ollama po polsku. Jeśli wolisz klikanie po terminalu, LM Studio daje graficzny interfejs, pobieranie modeli w oknie programu i pod spodem te same silniki uruchomieniowe, MLX oraz llama.cpp.
Ile sprzętu potrzeba i co robi kwantyzacja
Rozmiar modelu w nazwie, na przykład 8B czyli 8 mld parametrów, przekłada się na wielkość pliku, ale nie wprost. Pełne wagi zapisane w 16 bitach to około dwa bajty na parametr, więc model 8B zajmuje jakieś 16 GB. Kwantyzacja kompresuje te liczby do czterech bitów kosztem niewielkiej utraty jakości: wariant 8B w kwantyzacji Q4_K_M waży 4,9 GB, wariant 70B tego samego modelu 43 GB wobec 141 GB pełnych wag. Plik ładuje się do pamięci operacyjnej albo, najlepiej, do pamięci karty graficznej, bo od tego zależy tempo odpowiedzi.
Praktyczna drabina z biblioteki Ollamy wygląda tak: mały model 0,6B to plik 523 MB i rusza na niemal każdym laptopie, 8B w Q4 to 4,9 GB i realne minimum wygody to karta z 8 GB VRAM, rozmiary 30B do 32B (19 do 20 GB) chcą 24 GB VRAM albo Maca z 32 GB pamięci, 70B to 43 GB, czyli dwie mocne karty lub topowe konfiguracje, a 235B w Q4 to już 142 GB, sprawa serwerowa. Agresywniejsza kompresja schodzi niżej, bo wariant Q2 w rozmiarze 8B zajmuje 3,2 GB. Za takim ściskaniem jednak utrata jakości przestaje być pomijalna, więc do codziennej pracy zostaje się przy Q4 albo Q8.
Uczciwie: do tego tekstu nie uruchamialiśmy modeli na własnym sprzęcie, więc liczby pochodzą z dokumentacji i z list pobrań Ollamy oraz LM Studio, a nie z naszych pomiarów. Jeśli chcesz pójść za przykładem, w poradniku o uruchamianiu lokalnych modeli opisujemy pierwszą instalację krok po kroku, w tekście o doborze modelu do słabego komputera są progi sprzętowe rozpisane na konkretne konfiguracje, a szersze tło segmentu zbiera hub o lokalnym AI. Mała ciekawostka na marginesie: specjalne architektury schodzą tak daleko, że model da się upchnąć na mikrokontrolerze za kilkadziesiąt złotych, o czym pisaliśmy przy eksperymencie BitNet na ESP32.
| Rozmiar modelu | Plik w Q4 | Przykład z Ollamy |
|---|---|---|
| 0,6B | 523 MB | qwen3:0.6b |
| 8B | 4,9 GB | llama3.1:8b (Q4_K_M) |
| 14B | 9,3 GB | qwen3:14b |
| 32B | 20 GB | qwen3:32b |
| 70B | 43 GB | llama3.1:70b (Q4_K_M) |
| 235B | 142 GB | qwen3:235b |
Bielik, czyli polski ślad
Bielik to otwarty model trenowany na polskich korpusach przez projekt SpeakLeash razem z centrum obliczeniowym ACK Cyfronet AGH. Wersja 11B v2.3 Instruct ma 11 mld parametrów, licencję Apache 2.0 i rozmiar, który obsłuży średnia karta graficzna, więc jest realną odpowiedzią na pytanie o model do polszczyzny bez API. Rodzima odmiana, ogonki i idiomatyka to dla modeli uczonych głównie na angielskim poważna przeszkoda, a Bielik przeszedł przez te dane od podstaw. O jego wersjach, limitach i praktycznym użyciu piszemy w osobnym tekście o Bieliku.
Co się dzieje jesienią 2026
Sześć października Mistral zapowiedział Large 4: mieszaninę ekspertów o bilionie parametrów, z czego 52 mld aktywnych w danym kroku, opisaną jako hybrydowy model instrukcyjno-rozumujący z otwartymi wagami. Wagi mają wypaść do końca października, ale licencja nie została w zapowiedzi nazwana, więc dopóki karta nie będzie widoczna na Hugging Face, wnioski o pełnej otwartości są przedwczesne. Przez API model już działa w cenie 1,36 USD za milion tokenów wejścia i 4,18 USD za wyjście. Poprzednik, Large 3 o 675 mld parametrów, leży na Hugging Face na Apache 2.0 od grudnia, więc rodzina ma na koncie już jedną w pełni otwartą generację. Zapowiedź opisujemy szeroko w tekście o Mistral Large 4.
Nie on jeden rusza ten segment. Gemma 4 przeszła na Apache 2.0, a wariant 31B jest multimodalny, ma kontekst 256 tys. tokenów i deklaratywne wsparcie ponad 140 języków. Latem wagi wydali Moonshot z modelem Kimi K3 oraz DeepSeek, który po V4 z kwietnia dopuścił w sierpniu wariant Pro. Na stronie LM Studio te trzy nazwy podano jako przykłady modeli na czele otwartej fali, co dobrze oddaje moment: najlepsze wyniki nie są już wyłączną własnością zamkniętych laboratoriów.
Nie każda rodzina idzie jednak w stronę otwartych wag. Tego samego dnia Mistral wydał nową generację swoich modeli mowy: transkrypcja i syntezator w API od 0,0035 USD za minutę, z polskim na liście języków, ale po raz pierwszy bez wag do pobrania. Starsze generacje Voxtrala (Mini 3B, Small 24B, Mini 4B Realtime) zostają na Apache 2.0, a szczegóły premiery opisujemy w tekście o Voxtral 3.
Kiedy lokalnie ma sens, a kiedy API
Lokalny model wygrywa przy danych, których nie chcesz wysyłać nikomu: notatki, dokumenty firmowe, korespondencja, materiały z pracy, o której wolno myśleć w kategorii „zostaje na dysku”. Działa bez internetu, nie ma limitów zapytań, nie dołoży opłat za tokeny i nie zmieni się pod tobą z dnia na dzień, bo plik leży na twoim dysku. API wygrywa wszędzie tam, gdzie liczy się jakość na granicy możliwości, sprzęt jest słaby albo zadanie jest epizodyczne i szkoda na nie setupu. Do tego dochodzą koszty ukryte: mocna karta pod obciążeniem przez cały wieczór coś dołoży do rachunku za prąd, pierwsza konfiguracja i dobór kwantyzacji kosztują wieczór, nowa wersja modelu to kolejne kilkadziesiąt gigabajtów do pobrania, a przy produkcie komercyjnym pilnowanie licencji jest twoim problemem, nie dostawcy.
| Sytuacja | Lokalny model | API |
|---|---|---|
| Dokumenty firmowe, dane osobiste | Tak, nic nie opuszcza dysku | Tylko z gwarancjami przetwarzania |
| Praca bez internetu | Tak | Nie działa |
| Stałe, proste zadania na wolumenie | Tak, zero kosztu za token | Rachunek rośnie z wolumenem |
| Najtrudniejsze zadania, top jakość | Raczej nie | Tak |
| Słaby laptop, stary komputer | Mały model, kompromisy | Tak |
| Szybki test pomysłu | Może być, jeśli setup już masz | Wygodniej |
Pytania o otwarte modele
Czy otwarte modele AI są za darmo?
Same wagi są zwykle darmowe do pobrania, ale „darmowe” dotyczy plików, nie całego przedsięwzięcia. Płacisz sprzętem, prądem i czasem na konfigurację, a przy modelach gated także zgodą na warunki producenta. Ktoś z ponad 700 mln aktywnych użytkowników miesięcznie w przypadku Llamy musiałby dodatkowo kupić licencję, więc cena bywa symboliczna tylko do pewnego progu.
Czym różnią się wagi otwarte od open source?
Open source w klasycznym sensie daje pełny kod, historię zmian i możliwość przebudowy projektu od podstaw. Wagi otwarte to gotowy produkt treningu bez danych uczących i bez kodu treningu, więc modelu nie odtworzysz i w pełni nie poddasz audytowi. Część środowiska z tego powodu odmawia tym modelom etykiety open source i mówi wprost o open weights, czyli właśnie o otwartych wagach.
Czy mogę użyć otwartego modelu komercyjnie?
Apache 2.0 i MIT pozwalają na pełną komercję, łącznie z dostrajaniem i sprzedażą usług. Llama 4 też, ale do progu 700 mln aktywnych użytkowników i z wymogami brandingowymi, a Gemma wymaga przekazania restrykcji każdemu odbiorcy twojej dystrybucji. Przed wdrożeniem produkcyjnym przeczytaj tekst licencji na karcie modelu, bo producenci zmieniają warunki między generacjami; przejście Gemmy 4 na Apache 2.0 pokazuje, że potrafią też zmieniać je na korzyść użytkownika.
Ile VRAM potrzebuje model 8 mld parametrów?
Plik w kwantyzacji czterobitowej waży około 4,9 GB, ale do pamięci musisz jeszcze zmieścić kontekst rozmowy, więc realne minimum komfortu to karta z 8 GB VRAM. Bez karty graficznej model zadziała w RAM, tylko wyraźnie wolniej. Wyżej skalowanie jest mniej więcej liniowe: 32B to około 20 GB, a 70B to 43 GB samego pliku.
Czy lokalny model jest lepszy od ChatGPT?
W surowej mocy zwykle nie: czołowe modele z API wygrywają w testach zdolności i na moment pisania tak to wygląda dalej. Lokalny wygrywa tam, gdzie liczą się prywatność, praca offline, brak opłat za tokeny i pełna kontrola nad wersją. Rozsądny układ na start to mały lub średni otwarty model do zadań prostych i powtarzalnych oraz API do tych, które wymagają najwyższej jakości.
Źródła
- Llama 4 Community License, pełny tekst licencji Meta na Hugging Face, odczyt 15.10.2026: https://huggingface.co/meta-llama/Llama-4-Maverick-17B-128E-Instruct/blob/main/LICENSE
- Karta Qwen3-32B (Apache 2.0, 32,8 mld parametrów, kontekst 32 tys. do 131 tys.), odczyt 15.10.2026: https://huggingface.co/Qwen/Qwen3-32B
- Gemma Terms of Use (warunki Gemmy, przenoszenie restrykcji, zdalne ograniczenia, wzmianka o Apache 2.0 dla Gemmy 4), odczyt 15.10.2026: https://ai.google.dev/gemma/terms
- Karta google/gemma-4-31B-it (Apache 2.0, multimodalność, kontekst 256 tys., ponad 140 języków), odczyt 15.10.2026: https://huggingface.co/google/gemma-4-31B-it
- Karta DeepSeek-R1 (MIT, 684 mld parametrów, 37 mld aktywnych), odczyt 15.10.2026: https://huggingface.co/deepseek-ai/DeepSeek-R1
- Karta Bielik-11B-v2.3-Instruct (Apache 2.0, SpeakLeash i ACK Cyfronet AGH, polskie korpusy), odczyt 15.10.2026: https://huggingface.co/speakleash/Bielik-11B-v2.3-Instruct
- Zapowiedź Introducing Mistral Large 4 (6.10.2026: bilion parametrów, 52 mld aktywnych, wagi do końca miesiąca; ceny API 1,36 i 4,18 USD potwierdzone drugim odczytem w Artificial Analysis), odczyt 15.10.2026: https://mistral.ai/news/mistral-large-4
- Karta Mistral-Large-3-675B-Instruct-2512 na Hugging Face (Apache 2.0, 675 mld parametrów), odczyt 15.10.2026: https://huggingface.co/mistralai/Mistral-Large-3-675B-Instruct-2512
- Biblioteka Ollamy, strony llama3.1 (rozmiary plików i drabina kwantyzacji z 2 odczytami) i qwen3 (rozmiary wariantów, liczniki pobrań); licznik modeli Hugging Face oraz strona lmstudio.ai (silniki MLX i llama.cpp), odczyt 15.10.2026: https://ollama.com/library/llama3.1