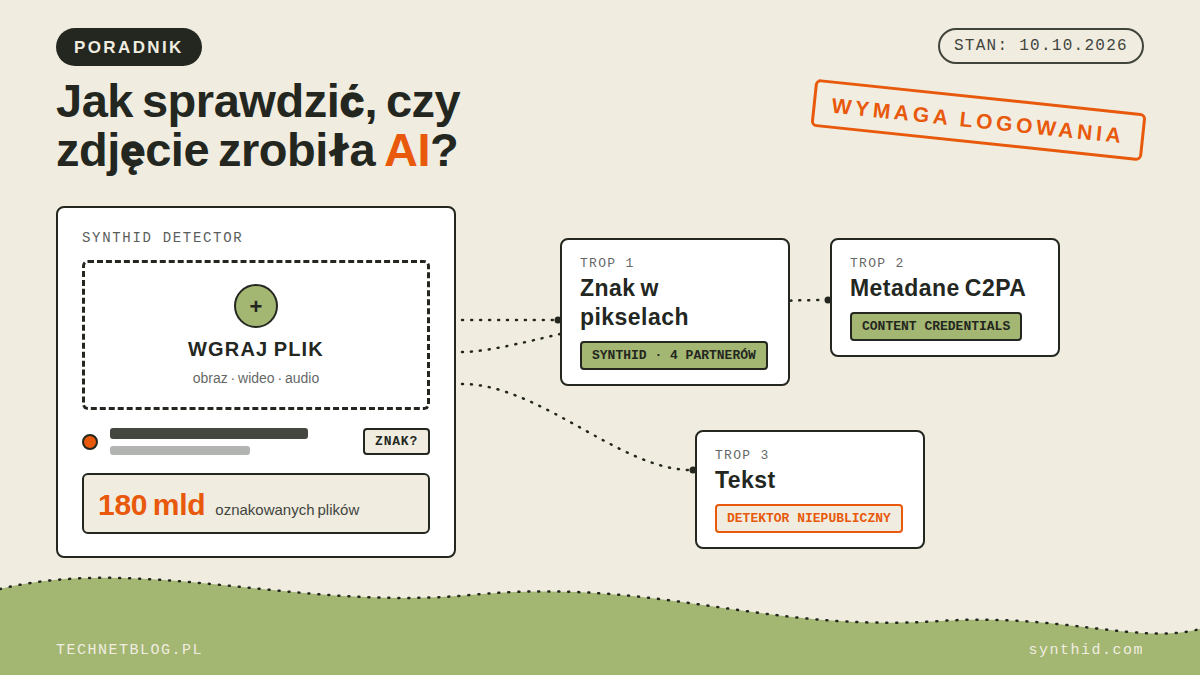
Siódmego października Google otworzył dla wszystkich SynthID Detector, stronę, na której wgrywasz zdjęcie, wideo albo plik audio i dowiadujesz się, czy nosi niewidzialny znak wodny jego firmy i partnerów. Do tej pory narzędzie miała w rękach tylko branża mediów, która dostła wersję testową rok temu. Teraz każdy, po angielsku i bez opłat, choć nie do końca bez warunków: portal każe się zalogować kontem Google, Apple albo ChatGPT, zanim cokolwiek sprawdzisz.
To praktyczna zmiana, bo pytanie „czy to zdjęcie zrobiła AI” od dawna nie jest abstrakcją. Fałszywe zdjęcia produktów na marketplace’ach, wygenerowane okładki, teksty wyręczające wypracowania, obrazki z fałszywymi wydarzeniami. W tym tekście przechodzimy przez wszystkie trzy tropy, jakie dziś ma zwykły człowiek: znak wodny SynthID w pikselach, metadane C2PA w pliku i osobno tekst, który sprawdza się najgorzej. Pokazujemy, co dokładnie robić krok po kroku, i gdzie cała ta technologia zawodzi, bo zawodzi często.
Spis treści
- Co Google i OpenAI wkładają w pliki AI
- SynthID Detector krok po kroku
- Sprawdzenie bez logowania: narzędzie OpenAI
- Metadane C2PA, czyli ukryta metka pliku
- A tekst? Tu jest trudniej
- Gdzie wykrywanie zawodzi
- Praktyczny porządek sprawdzania
- Źródła
Co Google i OpenAI wkładają w pliki AI
SynthID to niewidzialny znak wodny, który Google DeepMind wbudowuje w treści generowane przez swoje modele od 2023 roku. Dla obrazów działa tak, że jedna sieć neuronowa rozprowadza po pikselach sygnał niewidoczny dla oka, a druga potrafi go potem odczytać i zwrócić werdykt. W technicznym opisie SynthID-Image autorzy z DeepMind wyjaśniają, że sygnał jest rozprowadzony po całym obrazie, dlatego samo przycięcie kadru nie niszczy go od razu. Według danych z ogłoszenia z 7 października tak oznakowano do tej pory ponad 180 miliardów obrazów i filmów oraz 240 tysięcy lat dźwięku.
Samych znaków byłoby mało, gdyby nikt ich nie umiał czytać. Dlatego Google od wersji testowej buduje wokół SynthID ekosystem: sprawdzanie jest wbudowane w wyszukiwarkę, aplikację Gemini i Chrome, a te serwują razem ponad milion takich zapytań dziennie. Nowy portal SynthID Detector to najszersze okno: przyjmuje pliki nie tylko z Google, ale od wszystkich partnerów, czyli NVIDII, OpenAI i Kakao. W ogłoszeniu jest też zapowiedź, że dołączy Apple.
OpenAI z resztą nie jest tu gościem, tylko współautorem systemu. W maju 2026 roku dołączyła do C2PA i oznakowała obrazy z ChatGPT znakiem SynthID w ramach partnerstwa z Google, końcem lipca doszedł dźwięk, a piątego października ogłosiła textGrain, niewidzialny znak w tekście dla Unii Europejskiej. Jej oficjalna tabela sygnałów jest dziś taka: obrazy z ChatGPT, Codexa i API niosą metadane Content Credentials plus SynthID, audio samo SynthID, wideo same metadane, a tekst textGrain, ale tylko w UE. Po stronie Google znak dostaje z kolei wszystko, co wygenerujesz w aplikacji Gemini, także darmowe obrazki Nano Banana, o których pisaliśmy osobno. Skoro jeden znak żyje w plikach kilku gigantów, jeden portal do sprawdzania ma sens.
SynthID Detector krok po kroku
Adres jest prosty: synthid.com. Wgrywasz plik przeciągnięciem albo przyciskiem „Select file”, portal przyjmuje obrazy w formatach od JPG i PNG przez WEBP, AVIF, HEIC po TIFF i GIF, wideo w MP4, MOV i WEBM, audio w WAV, MP3, OGG, FLAC, AAC i M4A. Przy większych plikach wideo i audio detektor szuka znakowanych fragmentów, nie tylko sprawdza całość. Wskazówka od Google jest jedna, ale ważna: wgrywaj najlepszego jak masz plik, bo mocna kompresja i przeróbki osłabiają sygnał i spadają szanse na trafienie.
Przed pierwszym sprawdzeniem czeka seria ekranów: zgoda na pliki cookies, warunki korzystania, a na końcu logowanie. Właśnie na tym etapie wielu czytelników się zatrzyma, więc pokazujemy ten ekran w całości. Portal wymaga konta Google, Apple albo ChatGPT, komunikat nosi tytuł „Please sign in before detection”. Nie jest to przesada biurokracji: w prywatności portalu zapisano, że wgrane pliki są kasowane od razu po zwróceniu wyniku, ale cyfrowy odcisk każdego wgranego pliku trafia do bazy anty-abuse’owej na 24 godziny, bo dzienny limit sprawdzeń trzeba jakoś egzekwować. Warunki zakazają Ci przy okazji automatyzacji portalu i ataków na sam znak.
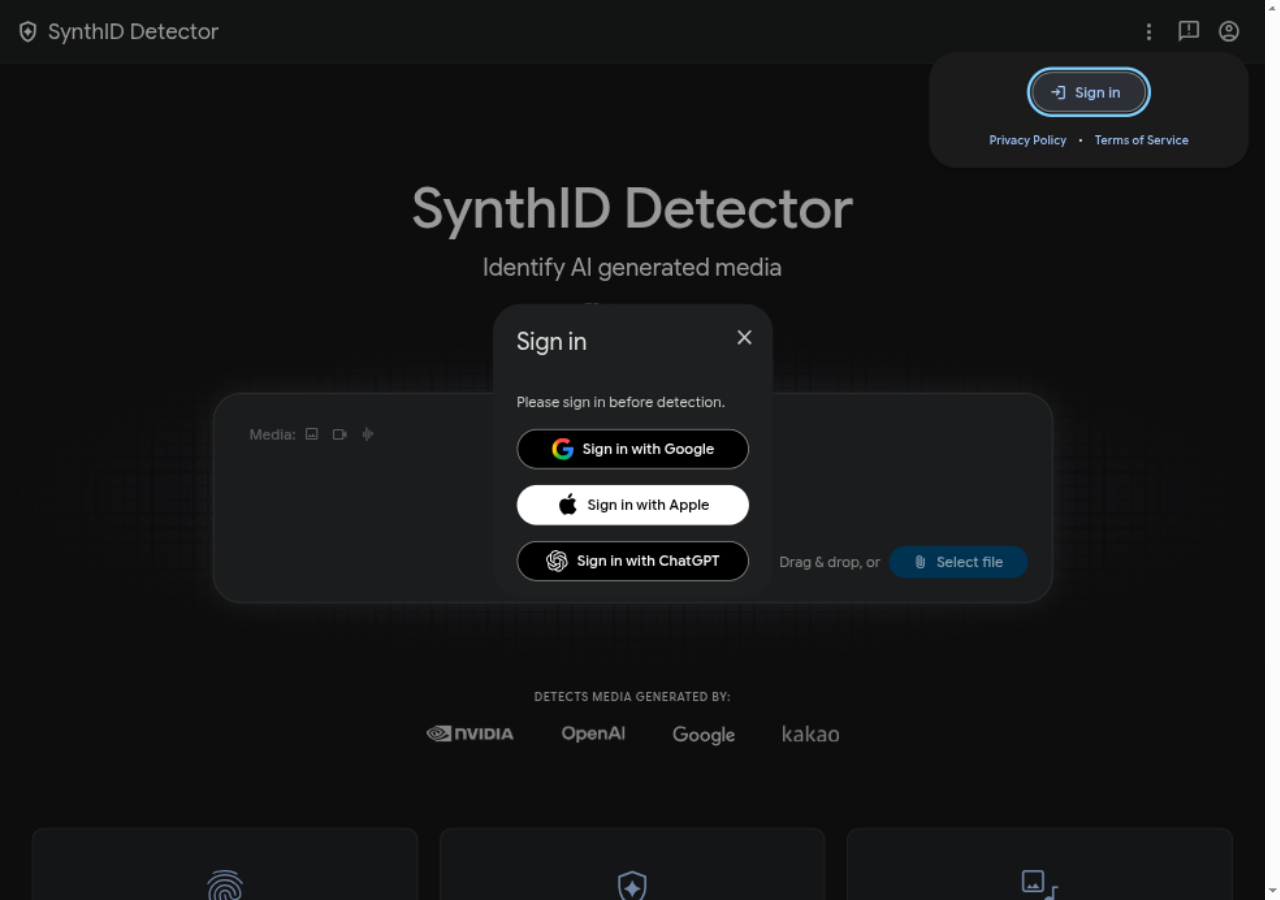
Samych skanów nie wykonaliśmy, bo nie prowadzimy testów na cudzych kontach, i to jest nasza jedna duża luka w tym poradniku. Ścieżkę i ekrany potwierdziliśmy na żywo 10 października. Wynik, który dostaniesz, ma dwie wartości: „Watermark detected” albo „Watermark not detected”. Pierwsza znaczy, że plik prawie na pewno przeszedł przez model z SynthID albo był nim redagowany. Druga nie znaczy, że obraz jest ludzki: mogła go stworzyć firma poza partnerstwem, mogła go przerobić tak mocno, że znak zamilkł, a FAQ portalu przyznaje wprost, że w rzadkich przypadkach detektor może też fałszywie wskazać znak na czystym pliku. To narzędzie do zbierania dowodów, nie wyrocznia, i sam Google każe zbierać więcej niż jeden trop przed decyzją.
Sprawdzenie bez logowania: narzędzie OpenAI
Jeśli podejrzewasz, że obraz albo nagranie wyszło spod ręki ChatGPT, jest droga wygodniejsza: openai.com/research/verify. To odpowiednik portalu Google, tylko bez wymogu konta. Wgrywasz pojedynczy plik, obraz w PNG, JPG albo WEBP lub audio w MP3, WAV, AAC, FLAC, OGG, OPUS i PCM, a narzędzie odpowiada, czy znalazło metadane C2PA, znak SynthID, czy nic z tego. Narzędzie jest ostrożne z zakresem: sygnały wykrywa dla treści stworzonych w ChatGPT, przez API albo Codexa, inne pliki mogą wejść, ale nic z nich nie wynika.
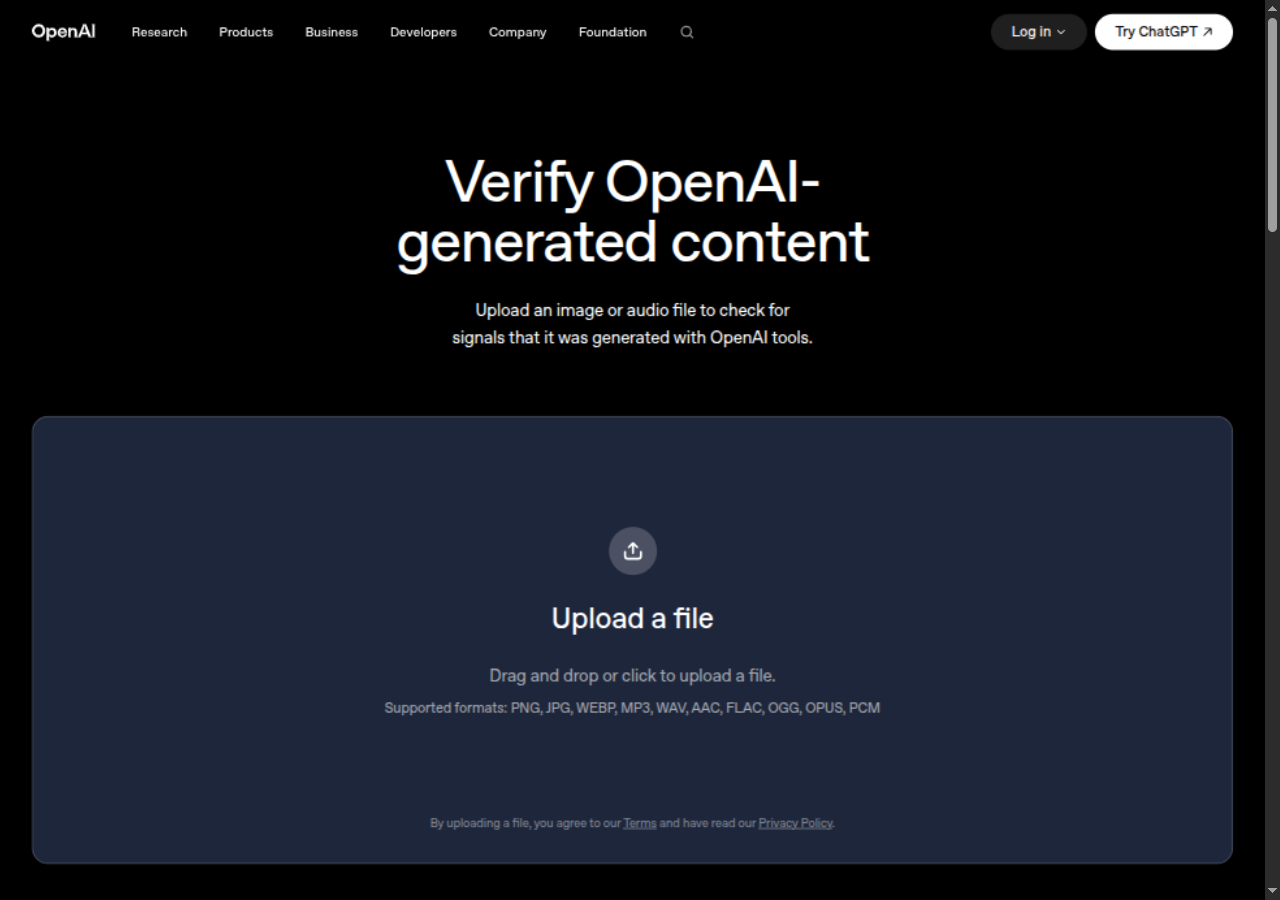
Dla deweloperów OpenAI wystawiła też weryfikację jako API, więc firmy mogą wbudować takie sprawdzanie we własne procedury, na przykład do moderacji ogłoszeń. Koniec lipca 2026 przyniósł przy okazji porządek w zakresach: audio z ChatGPT i API nosi SynthID od 31 lipca, a odstające modele tuż przed wycofaniem bywają bez sygnałów. To ciekawy kontrast z portalem Google: tam masz szerszy zakres firm, tu masz mniej formalności. Szkoda tylko, że audio w SynthID Detector i Verify to wciąż słabo opisane terytorium i trudno o niezależne testy jego skuteczności.
Metadane C2PA, czyli ukryta metka pliku
Content Credentials to metadane zapisane w pliku: kto wygenerował obraz, kiedy i czym, czasem z pełną historią edycji. Sprawdza się je stroną verify.contentauthenticity.org albo lokalnie, bo format jest otwarty. Przygotowaliśmy mały pokaz na własnym pliku: wzięliśmy okładkę z naszego poprzedniego artykułu, plik wyrenderowany z kodu, bez AI, i przepuściliśmy przez bibliotekę c2pa-python, tę samą silnikową warstwę, na której stoją poważne narzędzia. Wynik: „no JUMBF data found”, czyli zero poświadczeń w pliku. Tak wygląda odpowiedź dla zwykłego zdjęcia z aparatu i tak wygląda uczciwa negatywna kontrola.
Z metadanymi jest jeden zasadniczy problem, który OpenAI opisuje wprost: platformy, edytory i konwersje formatów potrafią je wyciąć. Wrzuć zdjęcie na popularny serwis społecznościowy, a po ściśnięciu i przepakowaniu metadane często znikają, zostaje sam znak w pikselach, jeśli w ogóle był. Dlatego oba systemy działają parami: metadane niosą dużo informacji, ale są kruche, znak niesie jedną bitę informacji, ale jest trwały. Ten trop sprawdzaj jako pierwszy, bo jest najszybszy, ale nigdy nie kończ na nim, gdy plik podróżował przez internet.
A tekst? Tu jest trudniej
Tekstu SynthID Detector nie sprawdza w ogóle, FAQ portalu wymienia tylko obrazy, wideo i audio. Znakowany tekst istnieje: OpenAI włącza textGrain w ChatGPT w Unii, a Claude znakuje globalnie od dwunastego sierpnia. Problem w tym, że detektory do tych znaków nie są publiczne: OpenAI przyznaje dostęp indywidualnie badaczom, więc nauczyciel czy rekruter oficjalnie nie mają jak sprawdzić tekstu.
Zostają detektory ogólne, te „AI czy nie AI”, i tu liczby są bezlitosne. Benchmark vals.ai z trzydziestego września porównał wyspecjalizowane detektory z dużymi modelami na prywatnych próbkach pisanych przed 2022 rokiem. Najlepszy detektor komercyjny łapał od 56 do 73 procent przeróbek AI, a model GPTZero poprawnie klasyfikował wszystkie ludzkie teksty, ale wyłapywał tylko 56,3 procent tekstów przerobionych przez model. Ciekawiej wypada Anthropic: Claude Opus 5.5 osiągnął w tym benchmarku 98,4 procent trafień, tylko że to model dla firm płacących za API, nie darmowa strona dla nauczyciela. Badanie ze Stanforda dodało drugi kłos: detektory GPT częściej wietrzyły AI w tekstach ludzi piszących po angielsku jako obcym języku. Na dziś uczciwa odpowiedź brzmi: wiarygodnego domowego testu tekstu nie ma, a wynik z detektora znalezionego w internecie nie dowodzi niczego.
Gdzie wykrywanie zawodzi
Obrazowe znaki wodne są twarde, ale nie niezniszczalne. Zespół DeepWalker pokazał pod koniec zeszłego roku, że rekonstrukcja obrazu modelem odszumiającym potrafi zmyć sygnał SynthID tak, że oko nie widzi różnicy, a detektor tak. Przez to publicznie dostępny detektor staje się sam narzędziem ataku: można iteracyjnie poprawiać obraz, aż werdykt spadnie poniżej progu. Naukowcy z zewnątrz odwracali też inżynierię samego detektora, od projektu reverse-SynthID po opis prób jego naśladowania na fyx.me, więc założenie, że mechanizm pozostanie sekretem, jest słabe.
Przy tekście liczby podaje sama OpenAI i napisaliśmy o nich szerzej w osobnym tekście o textGrain: zamiana dziesięciu procent słów na synonimy zbijała skuteczność detekcji z 92 do 66 procent, zamiana jednej czwartej zostawiała 17. Do tego dochodzi sprzężenie, które zna każdy, kto śledził unijne regulacje: parafraza jednego zdania bywa tańsza niż spór o to, czy tekst wolno było sprawdzić. Znaki łapią głównie tych, którzy nawet nie wiedzą, że istnieją.
Praktyczny porządek sprawdzania
Zbierz to wszystko w jedną procedurę, którą realnie da się przejść w kilka minut:
- Zacznij od źródła i kontekstu: kto publikuje, czy istnieje oryginał w wyższej jakości, co mówią inne ślady.
- Wgraj plik do SynthID Detector, jeśli podejrzewasz treść z Google, ChatGPT, NVIDIA albo Kakao, i pamiętaj o logowaniu plus najlepszej dostępnej jakości pliku.
- Dla treści z ekosystemu OpenAI sprawdź dodatkowo openai.com/research/verify, bez konta, zwłaszcza gdy SynthID Detector nic nie wykrył po przeróbkach.
- Zerknij na metadane C2PA przez verify.contentauthenticity.org, ale nie oczekuj, że przetrwały platformy społecznościowe.
Gdy trafisz na „detektor AI”, który każe zainstalować program albo wgrać dokument z danymi, zamykaj kartę: klasyczny schemat, w którym ofiarą padniesz ty, a nie zdjęcie. I ostatnia rzecz, którą warto wyryć w pamięć: żaden z tych wyników nie rozstrzyga, kto jest autorem ani czy ktoś kłamał. Detektor mówi o sygnale w pliku, człowiek mówi o prawdzie, i tych dwóch rzeczy nie da się zastąpić nawzajem.
Źródła
- Google blog 7.10.2026: We’re making it easier to identify AI-generated content globally
- SynthID Detector, portal z FAQ i warunkami korzystania (stan 10.10.2026)
- OpenAI: Verify OpenAI-generated content (stan 10.10.2026)
- OpenAI Help: Provenance signals in OpenAI-generated content (aktualizacja 10.10.2026)
- OpenAI: Advancing content provenance (aktualizacje 31.07 i 5.10.2026)
- arXiv 10.10.2025: SynthID-Image, Image watermarking at internet scale
- vals.ai 30.09.2026: AI Detection Benchmark
- DeepWalker 27.12.2025: A Case Study in AI Watermark Robustness
- fyx.me: Attempting model extraction of Google DeepMind SynthID detector
- GitHub: reverse-SynthID, reverse engineering detektora Gemini
- arXiv 2023: GPT detectors are biased against non-native English writers