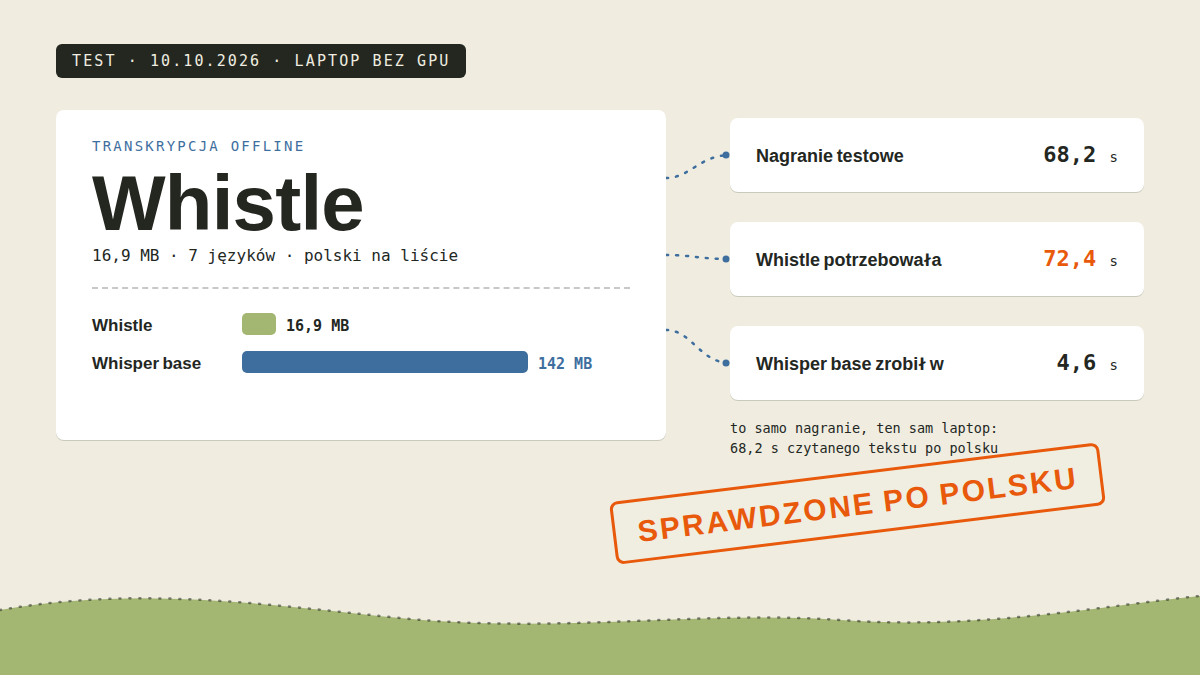
Transkrypcja na własnym komputerze zwykle oznacza wybór między rozmiarem a jakością: Whisper base od OpenAI zajmuje 142 MB, small 464 MB, a większe modele robią się ciężkie i powolne. Drugiego października 2026 firma Cactus Compute pokazała Whistle, model do zamiany mowy na tekst, który mieści się w jednym pliku 16,9 MB, pracuje na samym procesorze, bez karty graficznej i bez internetu, a deklaruje siedem języków, w tym polski. Sześć dni później dyskusja o niej na Hacker News zebrała 939 punktów, więc obietnicę zobaczyło sporo osób. Sprawdziliśmy, ile z niej zostaje na polskim nagraniu i zwyczajnym laptopie.
Wynik uprzedzam w jednym zdaniu, bo z niego wynika cała reszta tekstu: pod względem rozmiaru i jakości angielskiego Whistle robi wrażenie, ale na polskim materiale i starszym procesorze x86 przegrywa z Whisperrm, i to zarówno szybkością, jak i dokładnością. Nie znaczy to, że model jest zły. Znaczy to, że jego naturalne środowisko leży gdzie indziej niż nasz testowy laptop.
- Czym jest Whistle
- Liczby producenta
- Test: to samo nagranie, ten sam laptop
- Wyniki: rozmiar zwycięża, polski przegrywa
- Długie nagranie: 16 minut i 53 sekundy
- Co z tego dla ciebie
- Nota uczciwości
- Źródła
Czym jest Whistle
Whistle powstała w Cactus Compute, małym zespole Jakuba Mroza i Henry’ego Ndubuaku, i jest częścią większego projektu o nazwie Needle: silnika, który na tych samych wagach potrafi transkrybować audio i wywoływać narzędzia jak agent. Kod siedzi na GitHubie na licencji Apache-2.0 i zebrał już 13,8 tysiąca gwiazdek, wagi modelu leżą na Hugging Face, gdzie Whistle policzyła do tej pory blisko 12,8 tysiąca pobrań. Instalacja to jedno polecenie: pip install cactus-needle, a pierwsze uruchomienie dociąga właściwe wagi, te wspomniane 16,9 MB.
Technicznie to model dwa razy osiem bloków, enkoder i dekoder, z wagami skwantyzowanymi do dwóch bitów, i to stąd bierze się rozmiar. Słownik ma 8192 kawałków tekstu i siedem tokenów językowych: angielski, niemiecki, francuski, hiszpański, włoski, niderlandzki i polski. Język wykrywa sama, da się go też wymusić parametrem. Jeden przebieg obsługuje do 30 sekund audio, dłuższe nagrania silnik kroi na okna sam. Jeśli w materiale jest cisza, model zwraca pusty transkrypt zamiast wymyślać zdania, co odróżnia go od starszych implementacji, które dopisywały frazy w pauzach. Whistle pracuje też w wąskim paśmie 250 do 3500 Hz, czyli w zakresie telefonicznym, bo taki sygnał dociera do mikrokontrolerów i tanich mikrofonów, dla których ten model powstał.
Liczby producenta
Na stronie projektu jest wykres dokładności, z którego wynika, że Whistle wygrywa z Whisper base na LibriSpeech, SPGISpeech, Earnings-22 i średniej wielojęzycznego FLEURS, a przegrywa na TED-LIUM, AMI i MLS. Dokładnych liczb nie podano, więc cytujemy układ zwycięstw, nie wartości. Ciekawsze są pomiary prędkości: na procesorze Apple M4 Pro dekoder Whistle robi 1319 tokenów na sekundę, wobec 266 u Whisperra, a pierwszy token pojawia się po 11 milisekundach. To świetne wyniki i jeśli ktoś ma M4 Pro, prawdopodobnie doświadczy ich na własnej maszynie. Nas interesowało, co dzieje się na sprzęcie zwyczajnym, bo takich komputerów jeździ po domach i biurach najwięcej.
Test: to samo nagranie, ten sam laptop
Materiał wziął się z naszego poradnika o darmowej transkrypcji, w którym porównywaliśmy warianty Whisperra: 68,2 sekundy nagrania ze Spoken Wikipedia, człowiek czyta artykuł o deflegmatorze, mono, bez pogłosu. Tym razem uruchomiliśmy oba narzędzia na tej samej maszynie, laptopie z procesorem Intel Core i7-10850H, dwunastoma wątkami i bez karty graficznej. Dla pewności najpierw powtórzyliśmy pomiary faster-whisper, reimplementation Whisperra, którą polecaliśmy w tamtym poradniku: base przepisał klip w 4,6 sekundy, small w 13,1 sekundy, przy październikowych liczbach 4,0 i 11,2. Rozstrzał niewielki, więc porównanie między modelami jest uczciwe.
Instalacja Whistle zajęła chwilę, plik z wagami pobrał się przy pierwszym wywołaniu. Polecenie wygląda tak:
pip install cactus-needleimport needle
result = needle.transcribe("deflegmator.wav")
print(result["text"])Wyniki: rozmiar zwycięża, polski przegrywa
| Model | Pobranie | 68,2 s audio w | Błędy na ok. 96 słów |
|---|---|---|---|
| Whistle 2.0 | 16,9 MB | 72,4 s | ok. 14 |
| faster-whisper base, int8 | 142 MB | 4,6 s | ok. 9 |
| faster-whisper small, int8 | 464 MB | 13,1 s | 4-5 |
Whistle potrzebowała 72,4 sekundy na 68,2 sekundy nagrania, czyli pracowała wolniej niż trwa samo audio. Podczas dekodowania silnik zajmował sześć z dwunastu wątków, więc problem nie leży w braku paralelizmu; x86-wyjście tego silnika jest po prostu znacznie wolniejsze niż ścieżka zoptymalizowana pod Apple Silicon. Dla porównania: faster-whisper base robi to samo piętnaście razy szybciej niż trwa nagranie.
Jakość wypadła poniżej nawet podstawowego Whisperra. Wzorzec z nagrania brzmi „z Wikipedii, wolnej encyklopedii”, Whistle usłyszała „z Wigi Pedii, wolnej Encyklopedii”. „Skraplacz” stał się „skraplatem”, „rektyfikacyjnej” zamieniła się w „rektywikacyjnej”, „flegma” we „flagmę”, a „Naczynie” w „na czynienie”. Zaimponowała za to „kolumnie elektryfikacyjnej”, której nikt w nagraniu nie wypowiadał. Polska diakrytyka ocalała niemal w całości, interpunkcja pojawiła się sama, a układ zdań był czytelny, więc transkrypt do poprawki, nie do kosza.
Kontrola w drugim języku wypadła znacznie lepiej. Dla słynnego zdania Kennedy’ego z testowego pliku jfk.flac, jedenastu sekund czystej mowy, Whistle nie popełniła żadnego błędu, choć potrzebowała na to 9,6 sekundy, czyli ledwo trzymała się tempa rzeczywistego. Model rozumie więc świetnie, dopóki mówi się po angielsku, a po polsku najwyraźniej kończy się masa danych treningowych. Zastanawiający jest też wąski zakres 250 do 3500 Hz, w którym Whistle pracuje: polskie fonemy różnią się głównie wysokimi częstotliwościami, więc może on być częścią powodu, dla którego polszczyzna wypada słabo, choć to nasza hipoteza, nie pomiar.
Długie nagranie: 16 minut i 53 sekundy
Drugą próbę zrobiliśmy na czytanym artykule o ustroju Australii, 1013 sekundach mowy, tym samym, który w poradniku o transkrypcji przepisywał Whisper small. Tu obietnica rozeszła się z wykonaniem najmocniej. README obiecuje „audio of any length” z automatycznym okienkowaniem powyżej 30 sekund; Whistle pracowała 39 minut i zwróciła 43 słowa, czyli sam nagłówek Spoken Wikipedia, pierwsze mniej więcej 40 sekund nagrania. Cała dalsza mowa przepadła. Kontrolny wycinek ze środka, 120 sekund, obsłużyła od początku do końca, ale efektem jest 55 mocno pogmatwanych słów tam, gdzie w materiale mówi się około 230; zdania zaczynają się w połowie, a konstrukcję parlamentarną z „Izbą Reprezentantów i Senatem” zapisala jako „istkulowej austerity”. Tymczasem faster-whisper small przepisał pełne nagranie w 224 sekundy: 1984 słowa, 322 segmenty ze znacznikami czasu, tekst nadający się do pracy po poprawieniu nazw własnych. Na długich nagraniach po polsku porównanie nie jest więc nawet bliskie.
Co z tego dla ciebie
Jeśli masz zwykłego laptopa z procesorem Intela albo AMD i chcesz przepisywać po polsku, zostań przy faster-whisper, instrukcja czeka w poradniku o darmowej transkrypcji audio na tekst. Whistle w tej konfiguracji daje gorszy tekst i pracuje wolniej niż trwa nagranie, więc nie ma o co kruszyć kopii.
Inaczej wygląda sytuacja, gdy sprzęt jest nowy albo nietypowy. Twórcy publikują gotowe binarki na siedemnaście platform, od macOS przez Androida i iOS po RISC-V i przeglądarkę, i to jest prawdziwy adres tego modelu: telefony, zegarki, roboty, urządzenia, gdzie każdy megabajt i każda milisekunda się liczą, a mowa jest angielska. Na sprzęcie Apple liczby producenta wskazują pracę w czasie rzeczywistym z zapasem. Komentarz użytkownika pzo z dyskusji na Hacker News opisuje polskie doświadczenie zgodnie z naszym: dopóki nie mówi się głośno, wyraźnie i powoli, jakość nie zachwyca, a Parakeet wypada lepiej.
Na marginesie: Whistle zbiera anonimowe liczniki użycia, wyłącza je zmienna NEEDLE_TELEMETRY=0. Skoro motywacją do lokalnej transkrypcji bywa prywatność, ustaw ją przed pierwszym uruchomieniem.
Gdyby ktoś chciał powtórzyć nasz test, całość mieści się w dwóch wklejkach powyżej i jednym pliku WAV w 16 kHz mono. Zbiór Whistle na Hugging Face jest otwarty na licencji Apache-2.0, więc niczego nie blokuje. A jeśli temat dźwięku i lokalnego AI cię wciąga, po drugiej stronie jest lustrzany problem, zamiana tekstu na mowę bez internetu, opisany w osobnym poradniku.
Nota uczciwości
Test zrobiliśmy sami na dwóch nagraniach czytanego tekstu, 68 sekund i 16 minut 53 sekundy, plus wycinku ze środka tego dłuższego, co jest materiałem łatwiejszym niż spontaniczna mowa, więc nasze liczby traktuj jako dolny próg trudności. Błędy liczyliśmy na oko, porównując transkrypt z tekstem artykułu, bez formalnej metryki WER; kontrola angielska objęła jedno zdanie. Urwania się transkrypcji na pełnym nagraniu nie diagnozowaliśmy głębiej: README obiecuje automatyczne okienkowanie, w naszej wersji nie zadziałało, przyczyny nie ustalaliśmy. Liczby producenta pochodzą z blogu Cactus Compute i nie mieliśmy jak powtórzyć ich na M4 Pro, podobnie jak wyników WER z wykresów, z których zrezygnowano bez podania wartości. Nie testowaliśmy Parakeeta, którego przywołuje komentarz z Hacker News. Środowisko: needle 3.2.0, wagi Whistle 2.0.0, faster-whisper 1.2.1, stan na 10 października 2026.
Źródła
- Cactus Compute: Whistle, Speech to Text in 16.9 MB, 2.10.2026, benchmarki i architektura
- GitHub: cactus-compute/needle, README, licencja Apache-2.0, lista platform
- Hugging Face: Cactus-Compute/whistle, wagi modelu
- Dyskusja na Hacker News, 8.10.2026, w tym relacje użytkowników o polskim i hiszpańskim
- SYSTRAN: faster-whisper, punkt odniesienia w teście
- OpenAI: Whisper, rozmiary modeli, plik testowy jfk.flac
- Wikimedia Commons: Pl-Deflegmator-article.ogg, materiał testowy