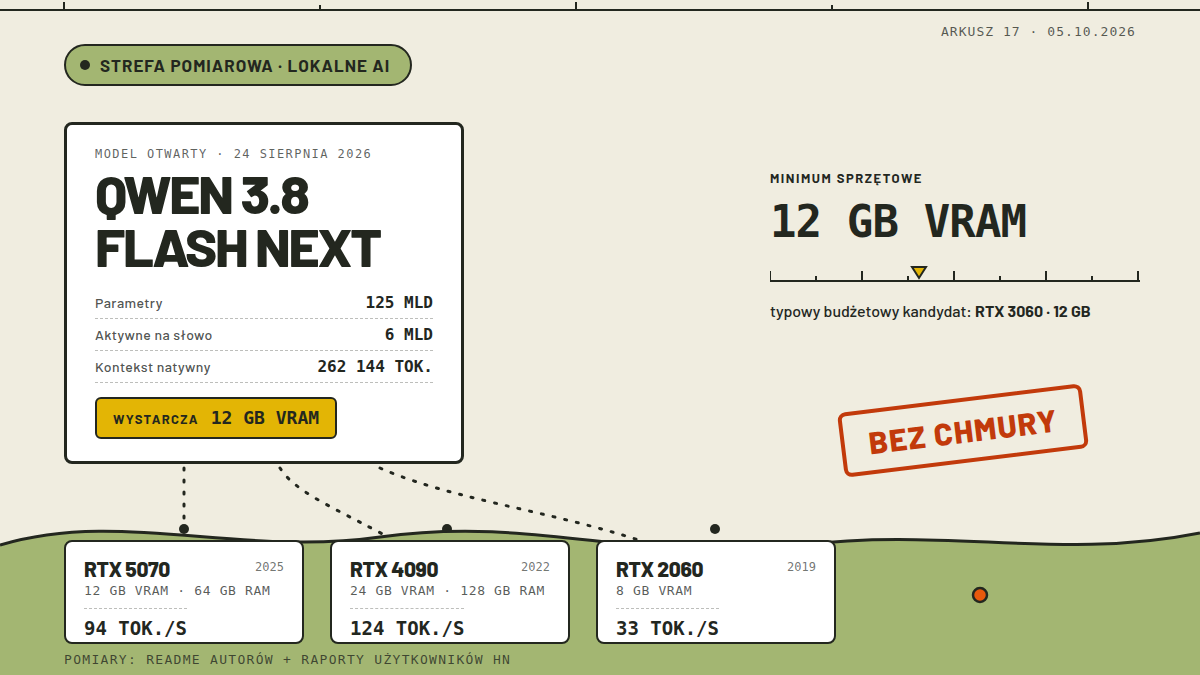
W niedzielę 4 października na stronę główną Hacker News wszedł Strata: darmowy silnik, który odpala na zwykłym komputerze model Qwen 3.8 Flash Next z 125 miliardami parametrów. Wystarczy karta graficzna z 12 GB VRAM i 32 GB RAM, a resztę model dociąga z pamięci operacyjnej i dysku. Wątek zebrał ponad 700 punktów i ponad 300 komentarzy, w większości raportów ludzi, którym instalacja faktycznie się udała. Na RTX 4090 model pisze 124 tokeny na sekundę, na RTX 2060 z 2019 roku 33. Dane nie opuszczają komputera, a abonamentu i limitów zapytań nie ma.
Spis treści:
- Co się właściwie stało
- Jak 125 mld parametrów mieści się w 12 GB VRAM
- Ile to daje w praktyce: liczby
- Czy twój komputer to uciągnie: wymagania
- Kiedy lokalnie, a kiedy chmura
- Polski ślad
- Jak zacząć krok po kroku
- Źródła
Co się właściwie stało
Strata to silnik do uruchamiania dużych modeli językowych, opublikowany na GitHubie na licencji MIT i zbudowany na podwalinach znanego llama.cpp. Model w tym zestawie, czyli Qwen 3.8 Flash Next, pochodzi od zespołu Qwen z Alibaby i trafił na Hugging Face 24 sierpnia. W oficjalnej karcie modelu czytamy, że to eksperymentalny podgląd architektury czwartej generacji Qwenów, a wersją produkcyjną pozostaje Qwen 3.8 Flash. Mówimy więc o modelu-testerze, tyle że testerze, który właśnie nauczył się działać na sprzęcie niekoniecznie nowym.
Sedno to architektura mieszaniny ekspertów. Model ma 125 mld parametrów, ale każde słowo aktywuje tylko 6 mld z nich. W każdej z 48 warstw czeka 512 ekspertów, a router budzi około dziesięciu z nich plus jednego współdzielonego; resztę czasu eksperci śpią w RAM-ie. Benchmarki producenta wyglądają solidnie: SWE-bench Pro 62,5 punktu, kiedy gęsty Qwen 3.8 27B ma 61,7, do tego LiveCodeBench 91,9 i GPQA Diamond 91,7. To nie jest model klasy najlepszych chmur, ale jak na coś, co działa na twoim biurku, stawia poprzeczkę wysoko.
Dla skali: lokalne AI w przeglądarce dawało 2 tok./s i halucynacje po polsku, BitNet na ESP32 to skrajnie ścięty model w mikrokontrolerze, a pełnowymiarowe modele chciały kart z 24 GB VRAM. Flash Next w wariancie Q2_0 przesuwa tę granicę na sprzęt, który ludzie trzymają w szufladach.
Jak 125 mld parametrów mieści się w 12 GB VRAM
Pierwszy trik to offload hybrydowy. Silnik trzyma na karcie graficznej tylko najczęściej używanych ekspertów, wszystkich mieści w RAM, a procesor liczy resztę równolegle; dysk SSD podaje dużą tablicę odwołań. Autorzy porównują to do kuchni: rzeczy wzięte są na blat, reszta czeka w spiżarni. Drugi trik to spekulatywna dekodacja: mały model-asystent zgaduje naraz paczkę kolejnych słów, duży model sprawdza całą paczkę jednym przebiegiem, co daje 1,6-1,8 razy szybsze pisanie. Trzeci: długie prompty czytane są porcjami po 8192 tokenów z prędkością ponad tysiąca tok./s, więc praca na dużym kontekście (natywnie 262 tys. tokenów, rozszerzalne do miliona) nie zamienia się w czekanie.
Jest też czwarty element, najmniej chwalebny: kwantyzacja. Warianty o nazwach Q2_0 i IQ2_XS zapisują wagi na 2 bitach, a praca naukowa z sierpnia (arXiv 2608.08188) pokazuje, że 4 bity zwykle zachowują jakość, 2 bity często ją szeroko degradują. Kwantyzacje IQ ważą każde wagi osobno, więc te najważniejsze dostają więcej bitów, ale problemu to nie zdejmuje. Użytkownik, który skleił własny wariant z okrojonymi ekspertami na Q2, raportował w wątku poważny spadek jakości mimo dobrej prędkości. Osobny wariant Coder, z połową ekspertów wyciętą, osiąga 91% wyniku SWE-bench pełnego modelu według pomiaru samych autorów i mieści się w 32 GB RAM.
Ile to daje w praktyce: liczby
| Sprzęt | Wariant | Zapis (tok./s) | Skąd pomiar |
|---|---|---|---|
| RTX 5070, 12 GB VRAM, 64 GB RAM | Q2_0 | 94 | README autorów |
| RTX 4090, 128 GB RAM | nie podany | 124 | użytkownik HN |
| RX 9070 XT, 16 GB VRAM | Q2_0 | 60 | README autorów |
| RTX 2060, 8 GB VRAM | Q2_0 | 33 | użytkownik HN |
| RTX 3080, 10 GB VRAM | Coder | ok. 30 | użytkownik HN |
Do tego odczyt promptów: 2650 tok./s na wspomnianej 5070, około 600 na RTX 2060 przy kontekście 128 tys. Wejście w temat kosztuje pobranie około 70 GB, a pierwsze uruchomienie potrafi zamrozić komputer na 1-3 minuty; autorzy uspokajają, że to normalne ładowanie 35-55 GB do RAM. Interfejs stoi pod adresem 127.0.0.1:8080 i wygląda jak zwykły czat. API jest zgodne ze schematem OpenAI i Anthropic, więc większość narzędzi podepniesz bez kombinowania, choć domyślnie serwer obsługuje jedno żądanie naraz.
Czy twój komputer to uciągnie: wymagania
Barierą wejścia jest pamięć operacyjna, nie karta graficzna.
| Ile masz RAM | Sensowny wariant | Komentarz |
|---|---|---|
| 32 GB | Coder | mieści się w 32 GB, do kodu; z kartą 24 GB też Q2_0 |
| 48 GB | IQ2_XS albo Q2_0 | większe warianty się nie mieszczą |
| 64 GB | IQ2_XS, opcjonalnie IQ3 | zalecana konfiguracja |
| 96 GB i więcej | IQ3_S lub UD-IQ4_XS | najbliższe pełnemu modelowi |
Poza RAM-em potrzebujesz karty z 12 GB VRAM (dowolna RTX z serii 20, 30, 40 albo 50, z nowszych Radeonów lista jest w README; typowy budżetowy kandydat to RTX 3060 z 12 GB), około 80 GB na dysku i Windows 10/11 albo Linuksa. Laptop z 16 GB RAM odpada. Odpalenie czysto na procesorze jest eksperymentalne i wolne, a obrazy na kartach AMD działają słabo, na Windowsie jeszcze wcale.
Kiedy lokalnie, a kiedy chmura
Za lokalnością mówi prywatność i koszt. Prompt zostaje w twoim mieszkaniu, licznik tokenów nie tyka, internet może paść, a model dalej odpowie. To dokładnie ta fraza, którą ludzie wpisują w Google: „ai bez internetu” ma dziesięć podpowiedzi autocomplete, a „lokalne ai na komputerze” jest pierwszą sugestią po wpisaniu „ai na komputerze”.
Za chmurą mówi jakość i wygoda. Na najniższych kwantyzacjach model traci, warianty z okrojonymi ekspertami tracą więcej, a najlepszy wariant UD-Q4_K_XL (94 GB wag) czyta głównie z dysku i spada do 7-8,5 tok./s. Jeśli liczysz się z każdą sekundą albo potrzebujesz szczytowej jakości, czołowe modele w chmurze wciąż wygrywają. Kompromisem bywają groszowe API, jak DeepSeek: tam nie płacisz za sprzęt, ale dane lecą na cudzy serwer.
Polski ślad
Popyt po polsku jest realny: „llm lokalnie” ma pięć podpowiedzi, w tym „bielik lokalnie” i „jak uruchomić llm lokalnie”; „sztuczna inteligencja na własnym komputerze” też żyje jako pełna fraza. Polskie media tematu jeszcze nie podjęły: w Google News dla nazwy Strata jest zero wyników (stan na 5 października). Sama nazwa modelu robi już swoje, bo „qwen 3.8 flash next” ma dziesięć podpowiedzi od benchmarków po rozmiary plików.
Dwie praktyczne uwagi. Strata jest zestrojona pod jeden konkretny model i to jego warianty podsuwa w instalatorze, więc polskiego Bielika (o który ludzie realnie pytają) odpalisz klasycznie, przez Ollamę albo llama.cpp. A jakości polszczyzny Qwena nie mierzyliśmy; instalator ostrzega tylko, że wariant Coder jest słaby poza kodem.
Instalator to skrypt pobrany z internetu, START-HERE.bat na Windows albo setup.sh na Linuksie. Część wątku na HN to spór o takie skrypty, i to ta sama mechanika, którą opisywaliśmy przy kampaniach ClickFix, tylko z odwrotnym znakiem: tu skrypt jest prawdziwy, ale nawyk wklejania komend bez czytania buduje się na obu końcach. Pobieraj z oficjalnego repozytorium i podejrzyj skrypt przed uruchomieniem.
Jak zacząć krok po kroku
- Wejdź na github.com/Niko1221/Strata i przeczytaj README, zwłaszcza sekcję o wyborze wariantu pod twój RAM.
- Pobierz repozytorium i uruchom START-HERE.bat (Windows) albo ./setup.sh (Linux).
- Instalator zapyta o wariant, rozmiar kontekstu i obsługę obrazów, potem dobierze konfigurację pod twój sprzęt.
- Poczekaj na pobranie około 70 GB, a przy pierwszym starcie na minutę albo trzy zamrożenia.
- Otwórz 127.0.0.1:8080 w przeglądarce i pisz.
Nota uczciwości: Straty nie odpalaliśmy, więc liczby wydajności bierzemy z README autorów i z raportów użytkowników w wątku HN, benchmarki modelu od zespołu Qwen, a jakości polszczyzny nie mierzyliśmy.
Najbardziej wymowny raport z wątku nie dotyczy RTX 4090, tylko RTX 2060 z 2019 roku: 33 tokeny na sekundę, stabilnie, zasilane z RAM-u i dysku. Bez karty klasy 4090, bez 24 GB VRAM, na sprzęcie, który w dniu premiery był budżetowy.