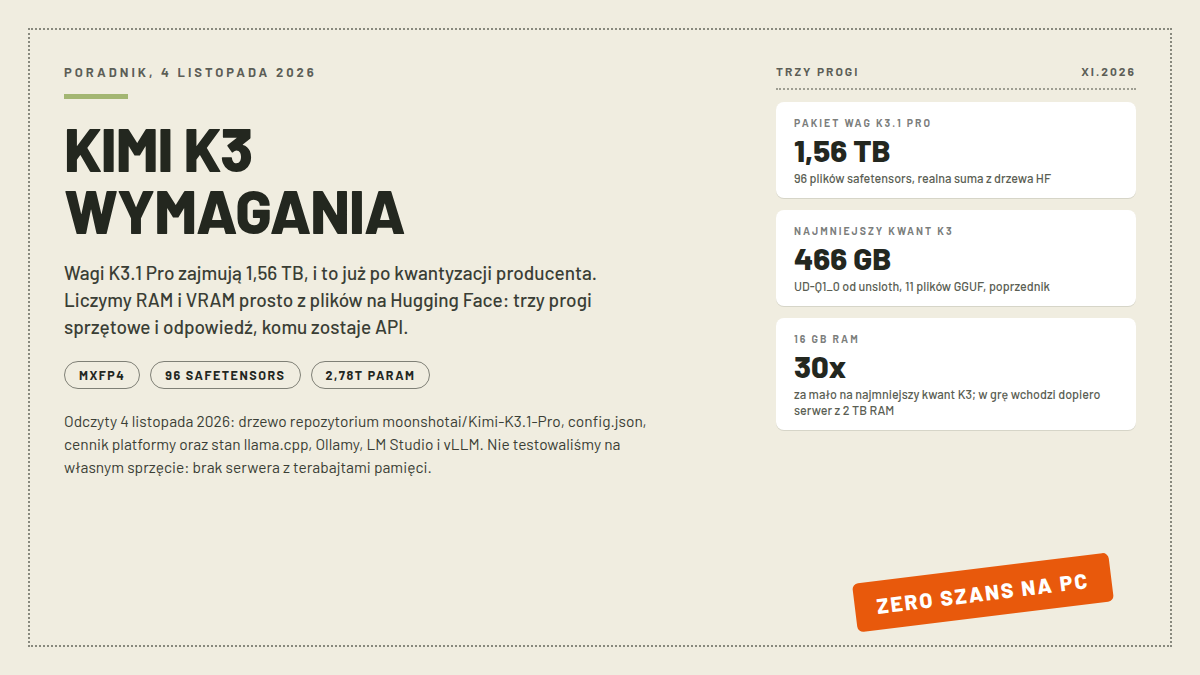
Repozytorium Kimi K3.1 Pro na Hugging Face powstało 2 listopada 2026 o 4:13 UTC, a w ciągu 4 listopada stało się w pełni publiczne: nasz poranny odczyt nie widział go jeszcze na liście organizacji moonshotai, wieczorny tak, już z 797 pobraniami i 385 polubieniami. Pakiet to 96 plików safetensors o łącznym rozmiarze 1,56 TB i to już po kwantyzacji: producent sam pakietuje wagi ekspertów po cztery bity, co README opisuje jako trening świadomy kwantyzacji. Mimo tej oszczędności model potrzebuje pamięci rzędu półtora terabajta, więc pytanie „czy uruchomisz go u siebie” ma krótką odpowiedź: na zwykłym komputerze, z 16 albo 64 GB RAM, nie ma fizycznie gdzie tego wczytać. W tym tekście liczymy wymagania bezpośrednio z plików, nie z plotek: rozkładamy 1,56 TB na składowe co do bajta, sprawdzamy stan llama.cpp, Ollamy, LM Studio i vLLM z 4 listopada i pokazujemy, kiedy zamiast lokalnie zostaje API za 2 i 10 dolarów za milion tokenów. Nie testowaliśmy modelu na własnym sprzęcie, bo nie mamy serwera z terabajtami pamięci; wszystkie liczby pochodzą z metadanych Hugging Face, pliku konfiguracyjnego, licencji i dokumentacji silników, z datami odczytów.
- Najważniejsze informacje
- Ile waży pakiet wag, liczba po liczbie
- Dlaczego 104B aktywne nie znaczy 104B w pamięci
- Trzy progi sprzętowe: 16 GB, 64 GB i serwer
- Stan silników na 4 listopada
- Kiedy zamiast lokalnie: API w liczbach
- Kiedy wyjdzie GGUF i czy to coś zmieni
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Rozmiar pakietu | 96 plików safetensors, suma 1,56 TB (drzewo repozytorium i indeks, odczyt 4.11.2026) |
| Parametry | 2 780 110 363 392, czyli 2,78 blna, z tego 104 mld aktywnych na token (README producenta, 4.11.2026) |
| Kwantyzacja | MXFP4 na wagach ekspertów, wrażliwe warstwy w BF16, trening świadomy kwantyzacji (config.json) |
| Kontekst i modalność | 1 048 576 tokenów, model natywnie multimodalny (image-text-to-text) |
| Licencja | „kimi-k3.1-pro”: przychód ponad 20 mln USD w 12 mies. wymaga umowy z Moonshot, przy 100 mln MAU trzeba pokazywać napis w UI |
| GGUF K3.1 | brak (odczyt 4.11.2026); repo unsloth/Kimi-K3.1-Pro to placeholder z 4.11, godz. 18:38 UTC |
| GGUF poprzednika K3 | kwanty społeczności od 466 GB (UD-Q1_0) do 1,56 TB (Q8), wg drzewa HF z 4.11.2026 |
| Ceny API | Pro 2/10 USD za 1M wejścia/wyjścia, Highspeed 4/20 USD (cennik platformy, odczyt 4.11.2026) |
Ile waży pakiet wag, liczba po liczbie
Drzewo repozytorium pokazuje 96 plików o nazwach model-00001-of-000096 do model-00096-of-000096, największe po około 17 GB. Suma z publicznego API wychodzi 1 561 293 160 568 bajtów, a metadane indeksu safetensors deklarują 1 561 217 377 280 bajtów, czyli 1,56 TB na dysku. To znacznie mniej, niż sugerowały przeliczenia sprzed premiery, i przyczyna siedzi w configu.
Liczba „2.8T” z tabeli producenta zamienia się na bajty tak: wagi ekspertów w formacie MXFP4 pakowane są po dwie wartości 4-bitowe na bajt, co daje 2 722 740 830 208 wag zapisanych w 1 361 370 415 104 bajtach. Do tego dochodzą skale, po jednej na każdą grupę 32 wag, razem 85 085 650 944 bajtów, potem warstwy wrażliwe na kwantyzację w BF16, 57 358 410 752 parametrów razy dwa bajty, i niewielki dodatek w F32, 11 122 432 parametrów razy cztery bajty. Cztery składniki sumują się dokładnie w 1 561 217 377 280 bajtów, czyli co do jednego bajta zgodnie z metadanymi indeksu, więc tę arytmetykę można trzymać za pewną. Dodane parametry: 2 722 740 830 208 plus 57 358 410 752 plus 11 122 432 równa się 2 780 110 363 392, prawie dokładnie tyle, ile producent zaokrąglił do 2,8T.
Na jeden parametr wypada tu 0,56 bajta zapisu. Gdyby te same wagi trzymać w pełnym BF16, pakiet urośłby do około 5,6 TB, więc kwantyzacja producenta oszczędza połowę miejsca jeszcze przed jakimkolwiek kwantem społecznościowym. Ta sama zasada prostuje stare szacunki: przed publikacją wag klasykiem było przeliczenie „2,8 blna razy 8 bitów, czyli ok. 2,8 TB na dysku” i nasz news o terminie wag tak właśnie liczył. Realny pakiet jest dwa razy mniejszy, bo Moonshot skleja po cztery bity od początku, w treningu, nie jako konwersję po fakcie.
Zresztą sformułowanie „konwersja” nie opisuje tego, co Moonshot zrobiło. Tabela w README mówi wprost o wagach MXFP4 i aktywacjach MXFP8 przy treningu świadomym kwantyzacji: model uczył się w warunkach, w których potem działa, zamiast zostać ściętym po opublikowaniu. Dlatego w repozytorium nie ma wersji w pełnej precyzji i nie ma co na nią czekać; gdyby kiedykolwiek się pojawiła, byłaby to osobna decyzja producenta, nie przełącznik w kodzie (odczyt 4 listopada). Dla kogoś liczącego dysk oznacza to jedno: 1,56 TB to wielkość, od której wszystko się liczy, nie wariant do przycięcia.
Poprzednik wygląda niemal identycznie: repozytorium moonshotai/Kimi-K3 z 2 września ma w configu ten sam format mxfp4-pack-quantized i indeks na 1,561 TB (odczyty 4 listopada; w ciągu 30 dni zebrał 768 725 pobrań). K3.1 zmienia coś innego niż rozmiar: część warstw pełnej uwagi dostaje Gated DeepSeek Sparse Attention, model jest natywnie multimodalny i kontekst rośnie do 1 048 576 tokenów. Dla sprzętu liczy się jednak to, co niezmienne: 104 mld aktywnych parametrów na token oraz 2,78 blna, które muszą stać w pamięci.
Dlaczego 104B aktywne nie znaczy 104B w pamięci
To najczęstsze nieporozumienie przy modelach typu Mixture of Experts i dlatego krążą pytania o 16 GB RAM. Model ma 896 ekspertów w 93 warstwach (config.json), router wybiera dla każdego tokenu kombinację wag o masie 104 mld parametrów, ale żeby mógł wybierać dowolnie, wszystkie 2,78 blna muszą być pod ręką w RAM albo VRAM. Doładowywanie ekspertów z dysku w trakcie generowania istnieje jako pomysł, ale w llama.cpp siedzi jeszcze tylko w otwartym pull requeście „stream MoE routed experts from disk” (odczyt 4 listopada, PR nadal niescalony), więc na dziś liczy się pełna pamięć naraz. Stąd też prosty wniosek dla każdego, kto szuka „kimi k3 na 16 gb”: brakuje nie skali, tylko dwóch rzędów wielkości.
Wagi to zresztą podłoga zapotrzebowania, nie sufit. Długie rozmowy dokładają pamięć na kontekst, a K3.1 ma okno miliona tokenów, więc serwowanie długich dokumentów dołoży swoje, zależnie od implementacji silnika. Na dobranie tych liczb do konkretnego serwera potrzebny byłby pomiar, którego nie robiliśmy, więc we wszystkich liczbach tego tekstu zostajemy przy samych wagach i piszemy to jawnie.
Trzy progi sprzętowe: 16 GB, 64 GB i serwer
Pierwszy próg to laptop albo komputer do gier, 16 GB RAM i karta z 8 GB VRAM. Frazy „kimi k3 16gb” i „kimi k3 8gb vram” siedzą w autocomplecie Google (odczyt 4 listopada), więc rozejrzałem się po najmniejszych dostępnych pakietach. Najmniejszy kwant poprzednika od unsloth, UD-Q1_0, zajmuje 466 GB w 11 plikach GGUF, trzydzieści razy za dużo na taką maszynę. I to jest kwant tak agresywny, że mówimy o ostatniej desce ratunku, nie o zalecanej konfiguracji; jakości w nim nie testowaliśmy. Dla porównania skali: po 4 bity na parametr szesnaście gigabajtów mieści w zaokrągleniu dwadzieścia kilka miliardów wag, licząc bez miejsca na system i kontekst, czyli dokładnie klasa modeli lokalnych, które opisujemy w przeglądzie otwartych modeli AI. Sama aktywna część K3.1, 104 mld, przekracza to czterokrotnie, zanim w ogóle doliczymy 896 ekspertów czekających na swoje tury.
Drugi próg to mocne stacje robocze, 64 GB pamięci albo karta 24 GB. Rachunek odpada ten sam: osiem razy za mało na najmniejszy kwant, trzydzieści razy na czterobitowy. Dopiero pamięć rzędu 512 GB, dostępna w stacjach najwyższej półki i w serwerach, dochodzi do rozmiaru UD-Q1_0, a to wciąż poprzednik K3, nie K3.1 i precyzja 1-bitowa. Warto przy tym pamiętać, że najmniejszy kwant nie znaczy najlepszy: przy tak agresywnym przycinaniu jakość odpowiedzi spada, ale o ile dokładnie, tego nie testowaliśmy.
Trzeci próg dopiero tu się zaczyna. Oficjalny pakiet K3.1 potrzebuje około 1,6 TB, więc w samym VRAM oznacza kilkanaście kart klasy H100: szesnaście sztuk po 80 GB daje 1,28 TB i wciąż jest za mało. Komentujący na HN w wątku o wagach szacują, że potrzeba węzła klasy 8× B300 („Too bad you probably need something like an 8x B300 node to run this”), czyli nowszej generacji kart od Nvidii; żeby rachunek zamknąć bez cytowania specyfikacji, policzmy od drugiej strony: osiem kart pomieści 1,56 TB dopiero przy blisko 200 GB pamięci każda, czyli o połowę więcej niż H100. Wątek uzbierał 222 punkty do odczytu 4 listopada. Druga droga to serwer z 2 TB RAM i jedną kartą graficzną do liczenia: pamięć się mieści, prędkość będzie rzędu pojedynczych tokenów na sekundę, ale to ocena z architektury silników, nie pomiar, bo takiej konfiguracji nie testowaliśmy. Do kompletu dochodzi jeszcze reszta wyposażenia: szybka macierz NVMe na 1,56 TB plików i porządne zasilanie, bo przy takim węźle chłodzenie przestaje być detalem.
Stan silników na 4 listopada
Zanim ktokolwiek zarezerwuje serwer, trzeba sprawdzić, czy silnik w ogóle umie wczytać ten format. Stan z naszych odczytów z 4 listopada wygląda tak:
- llama.cpp: architektura „kimi-k3″ siedzi w kodzie mastera (src/llama-arch.cpp), a GGUF-y K3 od unsloth zebrały 305 885 pobrań w 30 dni; dla K3.1 nie ma ani architektury „kimi_k31″, ani jednego zgłoszenia czy pull requesta w wyszukiwarce GitHub.
- Ollama: biblioteka zna tylko pozycję kimi-k3:cloud, czyli wersję odpalaną na serwerach Ollamy, wersji lokalnej brak; zapytanie o kimi-k3.1 zwraca 404. Gdy temat doboru lokalnego modelu powraca, wybór pod Ollamę i LM Studio opisujemy osobno.
- LM Studio: działa na GGUF, więc stan pokrywa się z llama.cpp, K3.1 na dziś nie; LM Studio jako silnik lokalny opisujemy w osobnym wpisie.
- vLLM: pull request „[Model] Kimi K3.1 Pro” został otwarty 4 listopada o 15:35 UTC i czeka na scalenie; serwowanie na TPU też jest na etapie PR.
- transformers: natywnego wsparcia „kimi_k31″ brak, repozytorium używa własnego kodu przez auto_map w config.json.
Różnica między „wagi są” a „silnik umie wczytać” robi się widoczna właśnie w takich tygodniach. Ponieważ transformers nie ma jeszcze natywnego wsparcia, uruchomienie na własnym sprzęcie sprowadza się dziś do wczytania modelu z własnym kodem Pythona dołączonym do repozytorium (pliki konfiguracji i procesora, tryb trust_remote_code). To standardowy mechanizm Hugging Face, ale skoro rozmawiamy o sprzęcie i danych, powiedzmy jasno: ta droga oznacza wykonywanie kodu dostarczonego przez producenta, więc przed pilnym użyciem warto przynajmniej przejrzeć, co te pliki robią. W przewidywalnej, serwerowej ścieżce vLLM scalenie PR zamknie ten temat w całości.
Siedem tygodni między premierą K3 a K3.1 wystarczyło społeczności na pełny zestaw kwantów poprzednika: od UD-Q1_0 (466 GB) przez UD-Q4_K_XL (1,509 TB) po Q8 (1,561 TB), a dynamiczne kwanty RadixArk/Kimi-K3-DSpark doliczyły się 324 910 pobrań w 30 dni. Repo unsloth/Kimi-K3.1-Pro powstało 4 listopada o 18:38 UTC, ale zawiera wyłącznie plik .gitattributes, czyli placeholder przed kwantami. Konwersja K3.1 może być trudniejsza niż zwykle, bo model wymienia część warstw uwagi na Gated DSA i ma hybrydową liniową uwagę, kiedy więc GGUF wyjdzie, nie wiadomo, piszę to wprost. Pewne jest tylko, że progi sprzętowe nie ruszą: nawet jeden bit na parametr przy 2,78 blna wag to około 348 GB pamięci, poza zasięgiem jakiegokolwiek komputera osobistego.
Kiedy zamiast lokalnie: API w liczbach
Cennik platformy Kimi z odczytu 4 listopada: kimi-k3.1-pro kosztuje 2 USD za milion tokenów wejścia i 10 USD za milion wyjścia, trafienia cache 0,20 USD; wariant highspeed 4 i 20 USD; poprzednik K3 wyceniony na 3 i 15 USD. Highspeed różni się od Pro serwisowo, nie architektonicznie: ogłoszenie z 23 października obiecywało szybszy strumień odpowiedzi przy tych samych możliwościach, więc wszystkie wymagania z tego tekstu dotyczą obu wariantów tak samo. Milion tokenów wyjścia to ogromna porcja tekstu jak na codzienne zapytania pojedynczej osoby, więc domowy serwer przegrywa rachunek podwójnie: sprzęt do 1,6 TB pamięci kosztuje więcej niż lata wywołań API, a działa wolniej niż tańsze karty po stronie dostawcy. Jest jeszcze jedna różnica, którą łatwo pominąć: przy API kontekst miliona tokenów nie zajmuje Ci ani bajta pamięci, bo po stronie serwera ktoś inny martwi się VRAM-em, a Ty płacisz za tokeny dopiero wtedy, gdy ich używasz.
Zostaje wybór dostawcy. OpenRouter hostuje kimi-k3.1-pro na dziesięciu endpointach (odczyt 4 listopada), najtańsze wejście 1,80 USD za milion tokenów u InferenceNet, obok Together, Nebius, Modal i samego Moonshot. Ollama i LM Studio dostają chmurowe warianty bez wysiłku konfiguracyjnego. Kontekst produktowy, czyli plany czatu, rejestracja i codzienna praca z Kimi, opisujemy w osobnym tekście o Kimi AI, a premierę K3.1 Pro z benchmarkami w wpisie z 23 października. Szerokie tło, dlaczego chińskie laboratorium w ogóle wystawia wagi takiego kalibru, rozkładamy w mapie chińskich modeli AI i przeglądzie otwartych modeli.
Jedna rzecz z repozytorium przydaje się niezależnie od drogi, którą wybierzesz: licencja „kimi-k3.1-pro” jest płatna dopiero na górze skali. Jeżeli przychód podmiotu przekroczy 20 mln USD w dowolnych 12 kolejnych miesiącach, komercyjne użycie wymaga osobnej umowy z Moonshot, a produkty z ponad 100 mln aktywnych użytkowników miesięcznie albo ponad 20 mln USD przychodu miesięcznie muszą pokazywać napis „Kimi K3.1-Pro” w interfejsie. Użycie wewnętrzne zostaje wolne (plik LICENSE, odczyt 4 listopada), więc lokalny serwer w firmie średniej wielkości nie rodzi zobowiązań.
Kiedy wyjdzie GGUF i czy to coś zmieni
Do domknięcia tematu brakuje jednej daty i nie da się jej uczciwie podać: kwanty K3.1 od unsloth pojawią się raczej w ciągu dni lub tygodni, jak po poprzedniku, ale żaden harmonogram nie istnieje. Jeśli chcesz złapać moment bez odświeżania, wyszukiwarka Hugging Face po frazie „kimi-k3.1 gguf”, lista tagów biblioteki Ollamy i strona pull requesta vLLM pokazują stan w jednej linii, bez logowania. Naszą aktualizację z realnymi progami dla konkretnych kwantów dopiszemy w tym tekście, gdy pliki zaczną żyć na HF. Z góry jednak: pierwszy próg, komputer osobisty, przegra niezależnie od precyzji kwantu, bo matematyka 2,78 blna parametrów nie zostawia 16 ani 64 GB żadnej szansy.
Najczęstsze pytania
Czy Kimi K3.1 da się uruchomić lokalnie?
Tak, ale tylko na sprzęcie klasy serwera. Oficjalny pakiet z 2 listopada zajmuje 1,56 TB pamięci, a GGUF dla społeczności jeszcze nie istnieje (odczyt 4 listopada). Na komputerze z 16 albo 64 GB RAM nie ma fizycznie miejsca, więc realna droga na dziś prowadzi przez API albo hosting dostawców.
Ile RAM potrzebuje Kimi K3?
Ponad 1,6 TB łącznie RAM i VRAM na oficjalnym pakiecie K3.1 Pro, bo router MoE musi mieć pod ręką wszystkie 2,78 blna parametrów, nie tylko 104 mld aktywnych. Najmniejszy kwant społecznościowy poprzednika K3 to 466 GB (odczyt 4 listopada), więc liczby mieszczą się wyłącznie w serwerach.
Ile VRAM potrzebuje Kimi K3?
W całości na kartach około 1,6 TB: szesnaście kart H100 po 80 GB daje 1,28 TB i wciąż za mało, a komentujący na HN szacują węzeł klasy 8× B300. Praktyczna kombinacja to serwer z 2 TB RAM i jedna karta graficzna do liczenia, kosztem prędkości rzędu pojedynczych tokenów na sekundę.
Czy odpalę Kimi K3 na 16 GB RAM?
Nie. Najmniejszy znany kwant K3, UD-Q1_0 od unsloth, zajmuje 466 GB, około trzydzieści razy więcej niż ma taka maszyna. Przy 2,78 blna parametrów nie istnieje precyzja kwantyzacji, która zmieściłaby ten model w pamięci komputera osobistego.
Czy Kimi K3.1 ma już GGUF?
Nie, wyszukiwarka Hugging Face nie zwraca żadnego GGUF dla K3.1 (odczyt 4 listopada). Repo unsloth/Kimi-K3.1-Pro powstało 4 listopada o 18:38 UTC z jednym plikiem .gitattributes, czyli jako przygotowanie przed kwantami. Kiedy pliki wyjdą, nie ogłoszono.
Czy Kimi K3 jest w Ollamie?
Tylko w wersji chmurowej: pozycja kimi-k3:cloud uruchamia model na serwerach Ollamy. Wersji lokalnej w bibliotece nie ma, a zapytanie o kimi-k3.1 zwraca 404 (odczyt 4 listopada).
Źródła
- Repozytorium moonshotai/Kimi-K3.1-Pro na Hugging Face (drzewo plików i API modelu, odczyt 4.11.2026: 96 plików safetensors, 1,56 TB, 797 pobrań, 385 polubień, utworzone 2.11.2026)
- README K3.1 Pro (odczyt 4.11.2026: tabela 2.8T total, 104B activated, kwantyzacja MXFP4 wag i MXFP8 aktywacji, kontekst 1 mln tokenów)
- Licencja Kimi K3.1-Pro (odczyt 4.11.2026: próg 20 mln USD w 12 mies., napis w UI od 100 mln MAU, wyłączenie dla użycia wewnętrznego)
- Repozytorium moonshotai/Kimi-K3 (odczyt 4.11.2026: 768 725 pobrań w 30 dni, indeks safetensors 1,561 TB, ten sam format mxfp4-pack-quantized w configu)
- Kwanty GGUF Kimi-K3 od unsloth (drzewo HF, odczyt 4.11.2026: UD-Q1_0 466 GB, UD-Q4_K_XL 1,509 TB, UD-Q8_K_XL 1,561 TB; 305 885 pobrań w 30 dni)
- Placeholder unsloth/Kimi-K3.1-Pro (utworzony 4.11.2026 o 18:38 UTC, zawiera wyłącznie .gitattributes)
- Biblioteka Ollama: kimi-k3 (odczyt 4.11.2026: tylko wariant cloud, brak wersji lokalnej; kimi-k3.1 zwraca 404)
- Kod źródłowy llama.cpp (src/llama-arch.cpp z mastera, odczyt 4.11.2026: architektura kimi-k3, bez kimi_k31; PR „stream MoE routed experts from disk” nadal otwarty)
- Pull request vLLM o modelu Kimi K3.1 Pro (tytuł „[Model] Kimi K3.1 Pro”, otwarty 4.11.2026 o 15:35 UTC, niescalony)
- Cennik platformy Kimi (odczyt 4.11.2026: kimi-k3.1-pro 2/10 USD za 1M, highspeed 4/20 USD, K3 3/15 USD, cache 0,20 USD)
- OpenRouter: moonshotai/kimi-k3.1-pro (API endpointów, odczyt 4.11.2026: 10 dostawców, wejście od 1,80 USD za 1M tokenów)
- Wątek Hacker News o wagach K3.1 (odczyt 4.11.2026: 222 punkty, komentarze o węźle 8× B300)