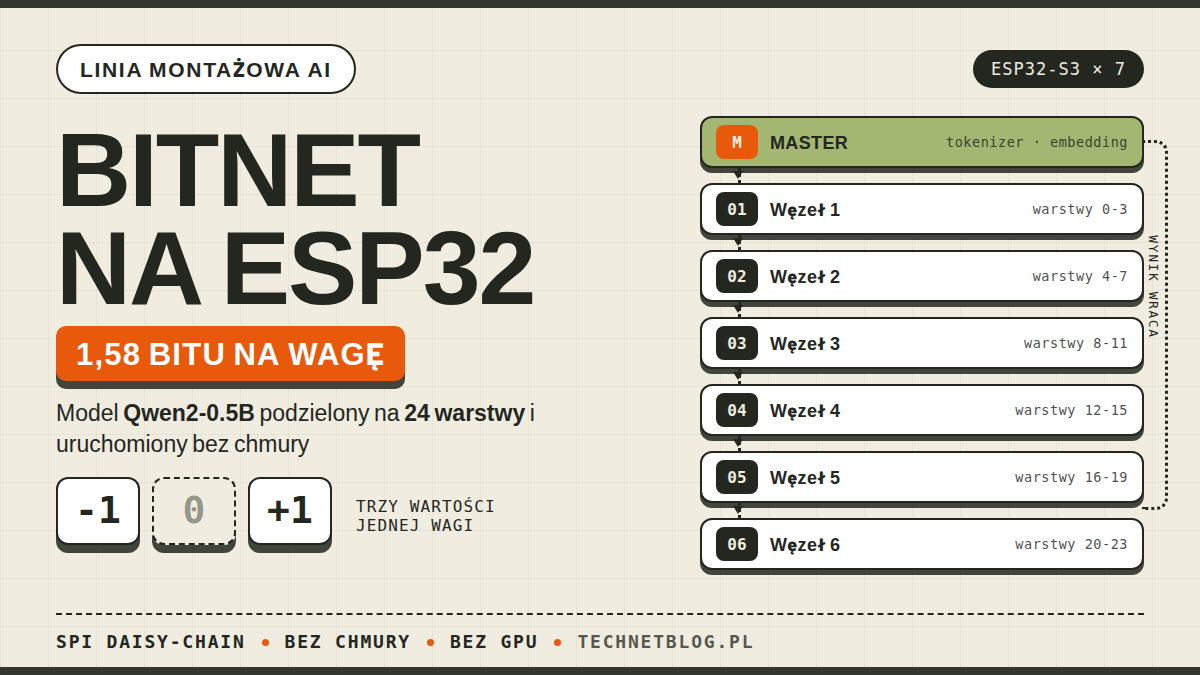
Koniec września przyniósł projekt, który wygląda jak żart z forum elektroników. Model językowy podzielony na siedem płytek ESP32-S3, połączonych kabelkami w łańcuch SPI, generuje tekst token po tokenie, przechodząc od płytki do płytki jak przez linię montażową. Kod wrzucił na GitHuba autor o nicku Low-Zi-Hong, licencja MIT, a dyskusja na Hacker News z 28 września zebrała w dwa dni 150 punktów i ponad 30 komentarzy. Model to Qwen2-0.5B od Alibaba, przycięty i przepalony na nowo w kwantyzacji ternarnej, czyli z wagami mającymi tylko trzy możliwe wartości.
Klastera nie składaliśmy. Ten tekst powstał z repozytorium, wątku na Hacker News i dokumentów Microsoftu, więc opisujemy cudze pomiary i cudze wrażenia, z linkiem do źródła przy każdym twierdzeniu. Piszemy o tym, bo projekt ładnie pokazuje trzy rzeczy naraz: jak daleko da się zepchnąć rozmiar modelu językowego, gdzie leżą twarde limity fizyki i ile realnie kosztuje wejście w lokalne AI na poziomie elektroniki, a nie aplikacji.
Spis treści:
- Czy AI może działać bez internetu?
- Skąd nazwa BitNet i po co te 1,58 bitu
- Siedem płytek jako jeden mózg
- Ile kosztują płytki i co musisz mieć
- Czy to coś więcej niż ciekawostka
- Co z tego dla Polski
- Źródła
Czy AI może działać bez internetu?
W Google to pytanie pada wprost, całym zdaniem: „czy sztuczna inteligencja może działać bez internetu”. Może, i nie od wczoraj. Pod koniec września opisywaliśmy model MicroLLM działający w całości w przeglądarce, z wagami pobieranymi raz i trzymanymi lokalnie w pamięci strony. Klaster ESP32 idzie o krok dalej. Tu nie ma przeglądarki, systemu operacyjnego ani dysku. Jest układ, 512 KB wewnętrznej pamięci SRAM i kilka megabajtów zewnętrznego PSRAM.
Warunek jest jeden i brutalny: model musi zmieścić się w pamięci. Standardowy Qwen2-0.5B, nawet w szczupłej postaci, liczy sobie setki megabajtów. Autor projektu wziął więc architekturę Qwen2, przyciął słownik z 151 tysięcy do 32 tysięcy tokenów, żeby embeddingi dały się spakować w około 14 MB flasha, i skwantyzował wagi do trzech wartości. Efekt to model, którego pojedyncze kawałki mieszczą się na tanich płytkach, a całość pracuje bez żadnej sieci. Wi-Fi jest w komplecie i tak, ale nieużywane.
Skąd nazwa BitNet i po co te 1,58 bitu
Zwykła waga w modelu językowym to liczba 16-bitowa, z tysiącami możliwych wartości. BitNet, technika opracowana przez Microsoft Research, zaczyna od innego końca: model trenuje się od zera z wagami ternarnymi, gdzie każda waga przyjmuje jedną z trzech wartości: -1, 0 albo +1. Trzy stany wymagają log2(3), czyli około 1,585 bitu, stąd nazwa „1.58-bit”. To nie jest kompresja gotowego, dużego modelu. Otwarty BitNet b1.58 2B4T z kwietnia 2025 roku trenował się na 4 bilionach tokenów już w tej postaci, a jego wagi mają łącznie 2 miliardy parametrów.
Raport techniczny Microsoftu pokazuje, co daje takie podejście. W pomiarach na CPU BitNet b1.58 zajmuje 0,4 GB pamięci (bez liczenia embeddingów), generuje token średnio w 29 ms i zużywa szacunkowo 0,028 J na token. Modele pełnoprecyzyjne podobnej wielkości potrzebują 1,4-4,8 GB, 41-124 ms i 0,186-0,649 J. Wyniki na benchmarkach ma przy tym porównywalne z Qwen2.5 1.5B, średnia 54,19 punktu wobec 55,23, przy pamięci mniejszej ponad sześciokrotnie.
| Model | Pamięć | Latencja na token | Energia na token |
|---|---|---|---|
| BitNet b1.58 2B4T | 0,4 GB | 29 ms | 0,028 J |
| LLaMA 3.2 1B | 2 GB | 48 ms | 0,258 J |
| Qwen2.5 1.5B | 2,6 GB | 65 ms | 0,347 J |
Pomiary pochodzą z raportu technicznego BitNet (i7-13800H, 128 wygenerowanych tokenów, bitnet.cpp dla BitNetu i llama.cpp dla konkurencji), więc dotyczą konkretnego sprzętu, ale rząd wielkości jest tu mniejszy niż w przypadku klasycznych modeli. Mała pamięć i mała energia to dokładnie ta cecha, dzięki której taki model da się w ogóle rozmieścić na mikrokontrolerach.
Siedem płytek jako jeden mózg
Układ podziału wygląda tak. Jedna płytka jest masterem i robi wszystko, co leży przed i po warstwach: tokenizuje prompt (tokenizer BPE spakowany do binarki), liczy embeddingi z flasha, na końcu liczy finalną normalizację i LM head współdzielony z embeddingami, po czym wybiera następny token. Sześć pozostałych płytek to czysta siła robocza. Dzieli się między nie 24 warstwy transformera, po cztery na płytkę, i każda przetwarza wektor stanu ukrytego przesłany od poprzedniej, po czym oddaje wynik następnej. Ostatnia odsyła dane do mastera.
Łączem jest SPI w układzie łańcucha (daisy-chain): master wysyła wektor 896 liczb na pierwszą płytkę, ta po przeliczeniu swoich czterech warstw przekazuje go dalej, i tak aż do szóstej. Wektor idzie w pełnej precyzji FP32, bo to już kilkanaście kilobajtów na skok i nie warto go ściskać. Ciężką pracę, czyli mnożenia macierzy wagami ternarnymi, węzły robią z optymalizacjami dopisanymi w asemblerze Xtensa (plik bitlinear_forward.S), a cache KV trzymają w PSRAM, bo do wewnętrznych 512 KB by się nie zmieścił.
Warto rozumieć, że to linia montażowa, nie rojność równoległa. Warstwa 7 potrzebuje wyniku warstwy 6, więc płytki pracują szeregowo, krok po kroku. Zysk jest taki, że żadna płytka nie musi trzymać całego modelu, a koszt to jeden master i tyle węzłów, ile warstw chcesz rozdzielić.
Jest też przestroga od samego autora. W workflow.md pisze wprost, że jego skrypt treningu QAT domyka stratę ledwie na poziomie 8,0, co w praktyce daje losowe tokeny, i że bez dotrenowania na mocniejszym komputerze z modelu nie wyrobie sensu. Kwantyzacja ternarna wymaga przepalenia wag podczas treningu, a rozjazd między kodem pakującym i rozpakowującym psuje model po cichu, bez żadnego komunikatu błędu.
Ile kosztują płytki i co musisz mieć
ESP32-S3 to dual-core Xtensa LX7 taktowany do 240 MHz, z 512 KB SRAM, Wi-Fi 2,4 GHz, Bluetooth 5 i instrukcjami wektorowymi dodanymi przez Espressif właśnie pod sieci neuronowe. Do tego projektu potrzebna jest wersja z zewnętrznym PSRAM, bo tam ląduje cache KV. Konkretnie chodzi o warianty oznaczone N16R8: 16 MB flasha i 8 MB PSRAM.
Ceny w Polsce (stan na 2 października): najtańsze klony płytek z tym modułem zaczynają się w okolicach 30 zł na porównywarkach, a oficjalna płytka Espressif ESP32-S3-DevKitC-1-N16R8 kosztuje 91,77 zł w sklepie Soyter. Siedem sztuk to odpowiednio od około 210 zł do 650 zł, plus kabelki. Do kompletu trzeba mieć jeszcze komputer do przygotowania modelu: skrypty kwantyzacji i treningu QAT są w Pythonie, a to one decydują, czy po wgraniu na płytki zobaczysz odpowiedzi, czy śmietnik tokenów.
Dla porównania, żeby nikt nie robił sobie złudzeń co do opłacalności: na Hacker News przypomniano, że mini PC z RK3588 (Orange Pi 5 Max) kosztuje 75-95 USD i odpala ten sam rozmiar modelu na CPU z prędkością około 12 tokenów na sekundę przez llama.cpp, do tego ma NPU z deklarowanymi 6 TOPS. W prędkości i wygodzie klaster ESP32 przegrywa z takim mini PC na każdej pozycji.
Czy to coś więcej niż ciekawostka
Najpierw to, co najważniejsze: prędkości autor nie podaje ani w README, ani w wątku, więc nie mamy jak porównać go z 2,0 tokenami na sekundę, które zmierzyliśmy w przeglądarkowym MicroLLM. O jakości świadczą za to komentujący. „It is a bit of a bummer to see that the degree of 'compression’ makes it a fancy llm noise-maker. It is still charming”, pisze jeden z nich, i to zdanie ujmuje rzecz dobrze: model po takiej operacji mówi coś, brzmi jak model, ale treścią sypie. Do tego dochodzi bazowy Qwen2-0.5B, który sam w sobie jest modelem minimalnym, oraz przycięty słownik.
Architekci komputerów w wątku zrobili sobie z projektu wykład o tym, czemu taki układ nie skaluje się w górę. Głównym wąskim gardłem LLM-ów jest przepustowość pamięci, nie liczba procesorów, więc jeden większy układ z szybką pamięcią zawsze wygra z wieloma małymi, między którymi dane podążają wolnym łączem. Łańcuch SPI z FP32 na wejściu każdej płytki jest wdzięcznym przykładem. Realny kompromis dla kogoś, kto chce lokalnie odpalać małe modele, wygląda inaczej: mini PC albo pojedyncza płytka z NPU.
Zostaje za to edukacja. Każda płytka trzyma cztery warstwy, więc można pokazać na żywym organizmie, jak prompt staje się wektorem, przepływa przez atencję i MLP, i wychodzi z LM headem jako następnym tokenem. Do nauki architektury transformera trudno o tańszy materiał. BitNet jako technika to z kolei deklaracja kierunku: mniejsza precyzja wag daje kilkunastokrotnie mniejsze zużycie energii, a to argument dla urządzeń, które mają liczyć lokalnie i oszczędnie.
Co z tego dla Polski
Płytki są dostępne od ręki: Botland i Kamami trzymają całe kategorie ESP32-S3, oficjalne DevKitC-1-N16R8 chodzi po około 90 zł, klony zaczynają się od mniej więcej 30 zł. Repozytorium jest po angielsku, z workflow.md prowadzącym przez flashowanie, kwantyzację i okablowanie, a licencja MIT pozwala bawić się i przerabiać bez pytań. Wymagana znajomość esptool albo Arduino IDE to u nas bariera niższa niż kupno drugiego GPU, choć to pewnie kwestia preferencji.
Przy okazji poradnika o DeepSeek pisaliśmy o fałszywych instalatorach AI łapanych pod hasłem „pobierz”. W projekcie ESP32 nie ma czego instalować z podejrzanych źródeł: kod jest na GitHubie, model budujesz ze skryptów samodzielnie, a flashowanie idzie przez oficjalne narzędzia. Gdyby ktoś sprzedawał „gotowy klocek AI za 99 zł z ChatGPT w środku”, to nie jest ten projekt i nie ma z nim nic wspólnego.
Jeśli szukasz lokalnego AI do realnej pracy, klaster ESP32 nie jest odpowiedzią. Do tego służy model w przeglądarce, gdy chcesz niczego nie instalować, albo mini PC z Linuxem, gdy chcesz mieć wygodę. Ten projekt jest odpowiedzią na inne pytanie: ile zostało do zrobienia, żeby sieć neuronowa zmieściła się w kieszeni. Wątek na Hacker News kończy się typowo dla elektroników, czyli wyliczaniem następnych układów, na których dałoby się to powtórzyć, a autor przyznaje, że czeka na nowsze chipy Espressif. Sprawdź za rok, ile płytek będzie potrzebnych.
Jeśli temat lokalnych modeli Cię wciągnął, w osobnym poradniku opisujemy DeepSeek po polsku, z cenami API i tym, na co uważać przy danych wysyłanych do chmury.
Źródła
- Repozytorium ESP32s3-LLM-Cluster (GitHub, licencja MIT)
- Dyskusja na Hacker News z 28.09.2026 (150 pkt)
- Raport techniczny BitNet b1.58 2B4T (arXiv, kwiecień 2025)
- Karta modelu microsoft/BitNet-b1.58-2B-4T (Hugging Face)
- bitnet.cpp, oficjalny kod inferencji CPU (GitHub Microsoft)
- Specyfikacja układu ESP32-S3 (Espressif)
- Cennik: Espressif ESP32-S3-DevKitC-1-N16R8, 91,77 zł (Soyter, stan 2.10.2026)
- Porównywarka Ceneo: płytki ESP32-S3 N16R8