Kiedy wysyłasz pytanie do czatbota, model nie wyszukuje odpowiedzi w żadnej bazie, o ile sam nie został wywołany do szukania w sieci. Wykonuje operację, którą branża nazywa inferencją. IBM definiuje ją jako użycie wytrenowanego modelu AI do robienia przewidywań na nowych danych, a Google w swoim słowniku uczenia maszynowego pisze wprost o dużych modelach językowych: inferencja to proces generowania odpowiedzi na prompt przez wytrenowany model. AWS w dokumentacji Bedrocka skraca tę myśl do jednego zdania: inferencja polega na wygenerowaniu wyjścia z wejścia podanego modelowi. Model dostaje coś na wejściu i zwraca coś na wyjściu, a wszystko, co „wie”, siedzi w wagach wytrenowanych wcześniej.
W tym tekście idę za tym śladem od początku do końca. Najpierw kontrast treningu i inferencji, bo to jeden cykl życia modelu, tylko podzielony na dwa zupełnie różne etapy. Potem mechanika odpowiedzi rozłożona na tokeny, koszt tej operacji z cenami za token z cennika producenta, inferencja na własnym komputerze, na telefonie i laptopie, wreszcie miejsca, w których spotykasz ją codziennie, czasem nawet o tym nie wiedząc. Zamyka pięć pytań, które padają przy tej frazie najczęściej.
- Najważniejsze informacje
- Trening uczy, inferencja odpowiada
- Co dzieje się w trakcie odpowiedzi, token po tokenie
- Dlaczego inferencja kosztuje
- Inferencja lokalna na własnym sprzęcie
- Inferencja na urządzeniu: telefon, laptop, NPU
- Gdzie spotkasz inferencję na co dzień
- FAQ
Najważniejsze informacje
| Co | Stan na odczyt 17.10 |
|---|---|
| Definicja | użycie wytrenowanego modelu do generowania odpowiedzi na nowe wejście, bez nauki w trakcie |
| Trening a inferencja | trening zmienia wagi modelu i wykonuje się raz na wersję; inferencja korzysta z gotowych wag przy każdym zapytaniu |
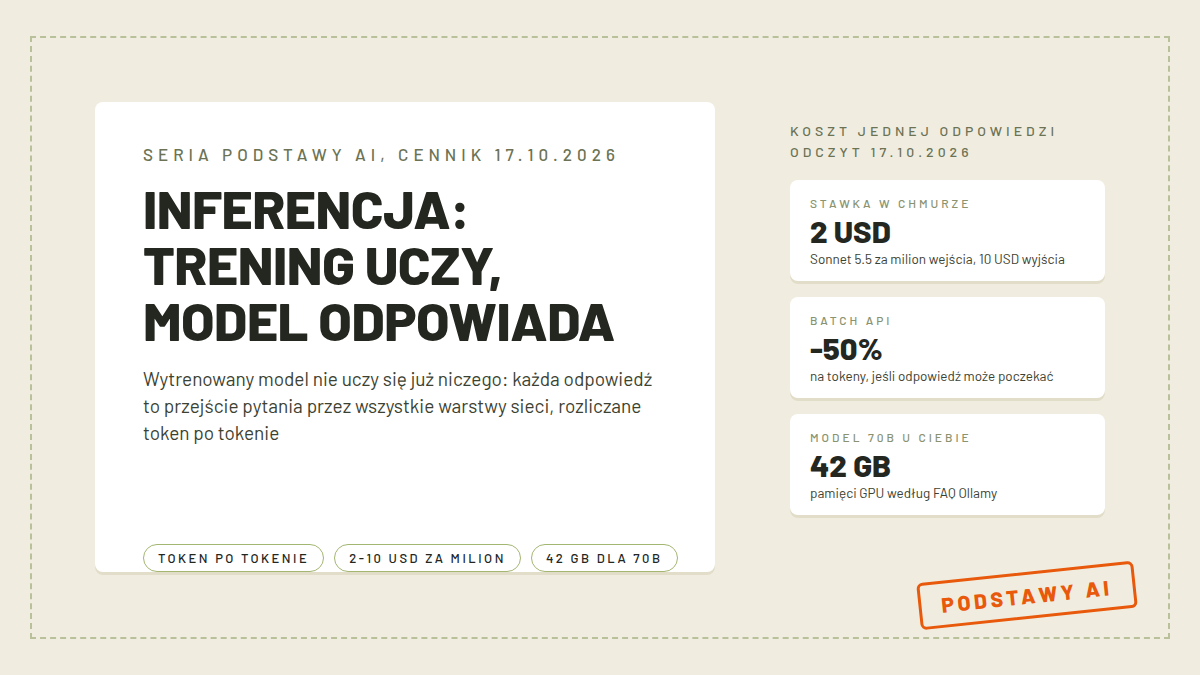
| Ceny u producenta | Claude Sonnet 5.5: 2 USD za milion tokenów wejścia, 10 USD za wyjście; Haiku 5.5: 0,10 i 0,50 USD do promptu 100 tys. tokenów (cennik Anthropicu) |
| Tańsze warianty | Batch API Anthropicu minus 50%; cache promptu na Sonnecie 5.5: 0,10 USD zamiast 2 USD za milion |
| Koszt sprzętu | wg benchmarków SemiAnalysis przywołanych przez NVIDIA: milion tokenów z 4,20 USD na Hopperze spadł do 0,12 USD na Blackwellu GB300 NVL72 |
| Lokalnie | model 70B to ok. 42 GB pamięci GPU (przykład z FAQ Ollamy); domyślne okno 4096 tokenów |
| Na urządzeniu | telefony i laptopy liczą inferencję na NPU w wąskich zadaniach: filtry aparatu, twarz, mowa na tekst |
| Limit rozmowy | okno kontekstowe aktualnych modeli Claude: do 1 mln tokenów, jedno zapytanie do 128 tys. tokenów wyjścia |
Trening uczy, inferencja odpowiada
Model językowy przechodzi przez dwa etapy, które łączy tylko to, że dzieją się z udziałem tego samego „silnika”. Trening to nauka: model dostaje ogromne ilości danych, przewiduje, myli się, a algorytm poprawia miliardy parametrów, żeby błędy malały. Trwa to tygodniami, pochłania klastry sprzętu i wykonuje się raz na wersję modelu. O tym etapie pisze osobno Jak AI się uczy, więc tutaj zostawię go jako kontrast. Inferencja zaczyna się tam, gdzie trening się kończy: wytrenowany model dostaje dane, których nigdy nie widział, i zwraca wynik. IBM podkreśla, że każdy przypadek, w którym model AI generuje wyjście albo podejmuje decyzję w działającej aplikacji, jest inferencją.
Najważniejsza różnica między tymi etapami jest asymetryczna: trening zmienia model, inferencja nie. Podczas treningu wykonuje się dwa przejścia, w przód, żeby dostać wynik, i wstecz, żeby policzyć poprawki parametrów; IBM zaznacza, że inferencja zawiera wyłącznie to pierwsze. Twoja rozmowa z czatbotem nie dopisuje niczego do jego wiedzy, nie dokłada ani jednej wagi; jutro model zacznie od dokładnie tych samych parametrów. Co ciekawe, te parametry, u dużych modeli miliardy wag, muszą być przy każdej inferencji wczytane do pamięci sprzętu, na którym model działa, i IBM pisze wprost, że już samo to generuje zużycie energii i koszt. Obraz, który to zamyka: trening to szkoła zawodowa, inferencja to dorosła praca, a pracownik nie kończy kolejnego semestru przy każdej rozmowie z klientem.
Granica w praktyce bywa mniej ostra, niż podpowiada teoria. IBM zauważa, że system rekomendacji w serwisie społecznościowym jest wytrenowany zanim jeszcze dołączysz, a jednocześnie jest stale dostrajany na tym, co robisz ty. U dostawców dużych modeli te stadia są jednak wyraźnie rozdzielone: twoje rozmowy nie aktualizują modelu, dopóki producent nie wypuści nowej wersji. Stąd daty graniczne wiedzy w kartach modeli i stąd odpowiedź „nie mam o tym pojęcia” na pytanie o wydarzenie sprzed tygodnia, nawet gdy ten sam model od tygodnia odpowiada na miliony pytań o bieżące sprawy.
Co dzieje się w trakcie odpowiedzi, token po tokenie
Model nie pisze całej odpowiedzi naraz. Tekst, który dostaje i który sam tworzy, jest pocięty na tokeny, czyli kawałki słów i znaków; szeroko pisze o nich Co to jest token AI. Odpowiedź powstaje w pętli: model patrzy na prompt i na to, co już wygenerował, przewiduje najbardziej prawdopodobny następny token, dokleja go i zaczyna kółko od nowa. Dokumentacja Hugging Face opisuje to jako strategię dekodowania, czyli regułę wyboru kolejnego tokenu. Najprostsza, zachłanna, wybiera w każdym kroku najbardziej prawdopodobny token i domyślnie generuje maksymalnie 20 nowych, jeśli nie ustawisz inaczej. Obok niej działają strategie losujące z rozkładu prawdopodobieństwa, dające bardziej urozmaicone odpowiedzi, i wyszukiwanie wiązkowe, śledzące kilka kandydackich kontynuacji naraz.
Ta pętla tłumaczy dwie rzeczy widoczne na ekranie. Odpowiedź „płynie”, bo serwis pokazuje tokeny w momencie ich powstania, nie po zakończeniu całej generacji. A długość odpowiedzi przekłada się wprost na rachunek: każde przejście pętli to kolejny token wyjściowy do rozliczenia. W cenniku Anthropicu, który sprawdziłem 17.10, tokeny wyjściowe kosztują pięć razy więcej niż wejściowe na Sonnecie 5.5. Model „mówi” więc drożej, niż „słucha”, i każde zbędne zdanie ma swoją cenę.
Ile model ogarnia w trakcie tej pętli, wyznacza okno kontekstowe. Dokumentacja Anthropicu definiuje je jako cały tekst, na który model może się powołać przy generowaniu odpowiedzi, łącznie z samą odpowiedzią, i nazywa to roboczą pamięcią, w odróżnieniu od korpusu treningowego. To schowek na bieżącą rozmowę, nie wiedza; szerzej rozpisuję go w tekście Okno kontekstowe. Wg odczytu z 17.10 aktualne modele Claude mają okno do 1 mln tokenów, a jedno zapytanie do 128 tys. tokenów wyjścia. Ta sama dokumentacja ostrzega, że wraz ze wzrostem liczby tokenów spada dokładność przypominania sobie treści z okna (context rot), więc pojemność nie jest celem samym w sobie.
Dlaczego inferencja kosztuje
Skoro model niczego się nie uczy przy odpowiedzi, skąd rachunki? Z fizyki obliczeń. Każde zapytanie przepuszcza wejście przez wszystkie warstwy modelu, a to wymaga sprzętu do masowych obliczeń równoległych, czyli w praktyce GPU w centrach danych. NVIDIA traktuje koszt pojedynczego tokenu jako główną miarę ekonomii inferencji i przywołuje benchmarki SemiAnalysis InferenceX: koszt miliona tokenów spadł z 4,20 USD na platformie Hopper do 0,12 USD na Blackwellu GB300 NVL72, a przepustowość wzrosła z 90 do 6000 tokenów na sekundę na jednej karcie. W inferencji liczy się więc nie cena sprzętu, tylko cena dostarczonej odpowiedzi.
Ceny u producentów rozliczają dokładnie te tokeny. Z cennika Anthropicu odczytanego 17.10: Sonnet 5.5 kosztuje 2 USD za milion tokenów wejścia i 10 USD za milion wyjścia, Haiku 5.5 odpowiednio 0,10 USD i 0,50 USD przy promptach do 100 tys. tokenów, Opus 5.5 płaci 4 USD i 20 USD, a Fable 5.1 10 USD i 50 USD. Ta sama strona podaje gotowy przykład: godzina sesji z Opusem 5.5 za 50 tys. tokenów wejścia i 15 tys. wyjścia kosztuje 0,58 USD, bo prócz tokenów doliczana jest opłata za sam czas sesji, tu 0,08 USD za godzinę. Drobiazg, który realnie wpływa na faktury: modele od Claude 4.7 w górę używają nowego tokenizera, produkującego dla tego samego tekstu około 30% więcej tokenów, więc ta sama rozmowa potrafi kosztować inaczej zależnie od wersji modelu.
Na całość składa się też inżynieria, która sprawia, że zapytań jest „mniej”. IBM opisuje micro-batching u platform czatowych: gdy tysiące ludzi pyta jednocześnie, serwis przetwarza prompty równolegle na tych samych kartach, żeby nie jeździły jak autobus z pustymi miejscami. Google w słowniku definiuje batch inference jako przewidywania na wielu przykładach w paczkach, z pełnym wykorzystaniem równoległości akceleratorów, a osobno offline inference, czyli przewidywania policzone z góry i zapisane w cache, jak prognoza pogody odświeżana co kilka godzin. U Anthropicu asynchroniczne zapytania przez Batch API kosztują o połowę mniej, więc Sonnet 5.5 w trybie batch to 1 USD zamiast 2 USD za milion tokenów wejścia, a trafienie w cache promptu na Sonnecie 5.5 to 0,10 USD za milion zamiast pełnych 2 USD. Po stronie infrastruktury AWS dokumentuje w SageMaker endpointy czasu rzeczywistego, serverless i asynchroniczne, te ostatnie dla zadań z payloadem do 1 GB i przetwarzaniem do godziny. Wszystkie te drogi prowadzą do jednego: inferencja jest tania na sztukę tylko wtedy, gdy sprzęt nie stoi bezczynnie.
Inferencja lokalna na własnym sprzęcie
Ta sama operacja da się wykonać poza chmurą. Ściągasz wagi modelu na dysk, wczytasz je do pamięci swojego komputera i odpowiedź powstaje lokalnie, bez internetu. Haczykiem jest pamięć, bo to ty teraz musisz mieć miejsce na te miliardy wag. Przykład z FAQ Ollamy, odczytany 17.10: model llama3:70b zajmuje 42 GB i w pokazanym odczycie siedzi w całości w pamięci GPU. Okno kontekstowe domyślnie ma tam 4096 tokenów, powiększane zmienną OLLAMA_CONTEXT_LENGTH, a każdy równoległy request mnoży zapotrzebowanie na pamięć: kontekst 2K przy czterech równoległych zapytaniach rozrasta się do 8K.
Odpowiedzią na ciasną pamięć jest kwantyzacja, czyli celowe uproszczenie liczb w wagach i cache. Ollama dokumentuje ją dla pamięci podręcznej kontekstu: wariant q8_0 zużywa około połowy pamięci względem pełnej precyzji f16, a q4_0 około jednej czwartej, kosztem drobnej, czasem zauważalnej utraty jakości. Do tego higiena czasu życia modelu: domyślnie Ollama trzyma wczytany model w pamięci 5 minut od ostatniego zapytania, więc kolejne pytanie nie płaci ponownego wczytywania kilkudziesięciu gigabajtów.
Co dostajesz w zamian? Zero opłat za tokeny, pracę bez internetu i prywatność opisaną czarno na białym: FAQ Ollamy mówi wprost, że przy lokalnym działaniu nie widzi twoich promptów ani danych. Całą ścieżkę od wyboru modelu po pierwsze uruchomienie rozpisuje osobno Lokalne AI na komputerze; tu zostawiam sam mechanizm: lokalnie wykonujesz dokładnie tę samą inferencję co centrum danych, tylko na mniejszym modelu i swoim sprzęcie.
Inferencja na urządzeniu: telefon, laptop, NPU
IBM wyróżnia wdrożenie na urządzeniu jako najprostszy scenariusz: inferencja działa bezpośrednio na sprzęcie użytkownika, na laptopie albo smartfonie, bez serwera pośredniczącego. W telefonach obok procesora pracuje zwykle NPU, układ zaprojektowany pod obliczenia sieci neuronowych; IBM podaje, że jego węższa specjalizacja zużywa mniej energii niż GPU, co w telefonie ma znaczenie podstawowe.
Ceną tej samowystarczalności jest zakres zadań. Sprzęt z kieszeni blednie na tle serwerowni, więc inferencja na urządzeniu ogranicza się zwykle do wąskich zastosowań; IBM wymienia filtry aparatu, rozpoznawanie twarzy i zamianę mowy na tekst, rzeczy, które mają być natychmiastowe i których nie opłaca się wysyłać w sieć. Zasada działania jest wszędzie ta sama: wytrenowane gdzieś indziej wagi odpalają się tam, gdzie potrzebna jest odpowiedź. Różni się skala, nie mechanizm. „AI w telefonie działa offline” i „model był trenowany w gigantycznym centrum danych” to więc nie sprzeczność, tylko dwa końce jednego cyklu życia.
Gdzie spotkasz inferencję na co dzień
NVIDIA otwiera swoją stronę poświęconą inferencji zdaniem, że to właśnie przez inferencję doświadczamy AI: czatboty, copiloty, narzędzia kreatywne. Rozszerzając na codzienność: każda odpowiedź czatu, autouzupełnianie wiadomości, tłumaczenie strony, podsumowanie dokumentu czy przepisana z dyktanda notatka to inferencja. Czasem jesteś jej adresatem, a czasem inicjatorem, nie znając słowa: gdy w aplikacji klikasz „streść”, ktoś zaprogramował wywołanie modelu i płaci za twoje tokeny.
Drugi tor to API dla twórców aplikacji; tam najczyściej widać ekonomię z sekcji wyżej, bo rozliczenie idzie za tokeny. Zadania niecierpiące natychmiastowości idą w paczkach asynchronicznych, jak nocne raporty z batch inference u IBM, gdzie wagi modelu ładuje się do pamięci raz na całą paczkę, więc koszt rozkłada się na wszystkie zapytania. Jeśli chcesz uporządkować pozostałe pojęcia tego obszaru, od tokenów po uczenie maszynowe, zbieram je na stronie Podstawy AI.
FAQ
Co to jest inferencja w AI?
To użycie wytrenowanego modelu do wygenerowania wyniku dla nowych danych. W tradycyjnym uczeniu maszynowym mówi się o przewidywaniach, w modelach językowych o generowaniu odpowiedzi na prompt. Google definiuje to drugie ujęcie wprost: inferencja to proces generowania odpowiedzi na wejście przez wytrenowany model. W praktyce każda odpowiedź czatbota jest inferencją.
Czym różni się trening od inferencji?
Trening uczy model: poprawia jego parametry na podstawie danych i odbywa się raz na wersję, tygodniami, na klastrach sprzętu. Inferencja korzysta z gotowych wag i wykonuje się przy każdym zapytaniu, bez żadnych poprawek. IBM podsumowuje to mechaniką: podczas treningu model robi przejście w przód i wstecz, podczas inferencji wyłącznie w przód. Efekt: trening zmienia model, rozmowa z nim już nie.
Dlaczego inferencja kosztuje?
Bo każde zapytanie to realne obliczenia na GPU, robione od zera dla każdego użytkownika. Dostawcy rozliczają je za token: wg cennika Anthropicu odczytanego 17.10 Sonnet 5.5 kosztuje 2 USD za milion tokenów wejścia i 10 USD za milion wyjścia, a godzina sesji z Opusem 5.5 to w podanym przykładzie 0,58 USD. Koszt obniżają pakowanie zapytań w paczki, cache promptu i tańszy tryb asynchroniczny z rabatem 50%.
Czy inferencja działa na zwykłym komputerze?
Tak. Model musi zmieścić się w twojej pamięci RAM albo VRAM, co wyklucza największe modele: przykład z FAQ Ollamy pokazuje 42 GB dla modelu 70B. Mniejsze modele i kwantyzacja mieszczą się jednak na typowym sprzęcie, a odpowiedź powstaje lokalnie, bez internetu i opłat za tokeny, zwykle wolniej niż w chmurze.
Co to jest inferencja na urządzeniu?
To wariant inferencji wykonywany bezpośrednio na sprzęcie użytkownika, telefonie albo laptopie, często z pomocą NPU, czyli układu zaprojektowanego pod sieci neuronowe i tańszego energetycznie niż GPU. Ogranicza się do wąskich zadań, jak filtry aparatu, rozpoznawanie twarzy czy zamiana mowy na tekst, a w zamian daje natychmiastową odpowiedź bez internetu i dane, które nie opuszczają urządzenia.
Źródła
- IBM Think, „What is AI inference?” (Dave Bergmann, aktualizacja 13.01.2026), odczyt 17.10.2026: https://www.ibm.com/think/topics/ai-inference
- NVIDIA, strona „AI Inference Solutions” wraz z danymi SemiAnalysis InferenceX, odczyt 17.10.2026: https://www.nvidia.com/en-us/solutions/ai/inference/
- Google for Developers, „Machine Learning Glossary” (hasła inference, batch inference, online i offline inference), odczyt 17.10.2026: https://developers.google.com/machine-learning/glossary
- Google Cloud, dokumentacja Agent Platform (Vertex AI), „Overview of getting inferences”, odczyt 17.10.2026: https://cloud.google.com/vertex-ai/docs/predictions/overview
- AWS, dokumentacja Amazon Bedrock, „Making inference requests”, odczyt 17.10.2026: https://docs.aws.amazon.com/bedrock/latest/userguide/inference.html
- AWS, dokumentacja Amazon SageMaker AI, „Deploy models for inference”, odczyt 17.10.2026: https://docs.aws.amazon.com/sagemaker/latest/dg/deploy-model.html
- Anthropic, dokumentacja „Pricing” (ceny modeli Claude za token, Batch API, prompt caching), odczyt 17.10.2026: https://platform.claude.com/docs/en/about-claude/pricing
- Anthropic, dokumentacja „Context windows” (definicja okna kontekstowego, rozmiary per model), odczyt 17.10.2026: https://platform.claude.com/docs/en/build-with-claude/context-windows
- Hugging Face, dokumentacja Transformers, „Generation strategies” (strategie wyboru kolejnego tokenu), odczyt 17.10.2026: https://huggingface.co/docs/transformers/generation_strategies
- Ollama, FAQ w oficjalnym repozytorium (pamięć modeli, okno kontekstowe, kwantyzacja cache), odczyt 17.10.2026: https://github.com/ollama/ollama/blob/main/docs/faq.mdx