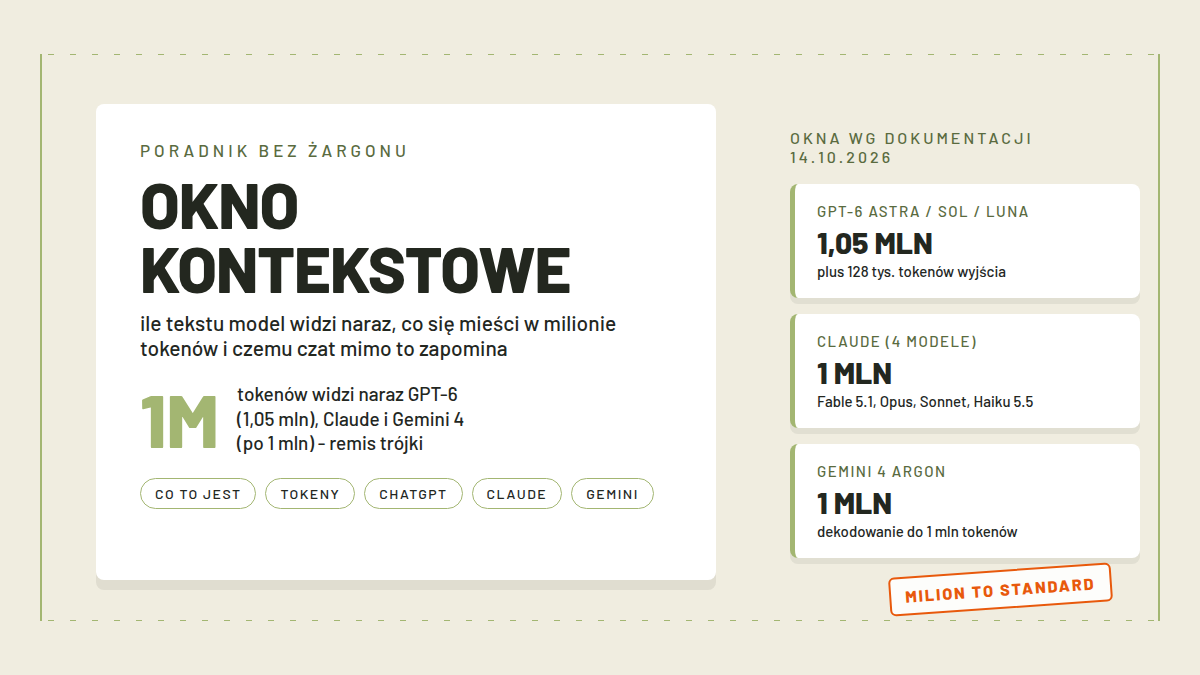
Okno kontekstowe to całość tekstu, którą model językowy widzi naraz: twoje pytanie, cała dotychczasowa rozmowa, wklejone dokumenty i instrukcje systemowe, wszystko razem, wyrażone w tokenach. Model nie ma pamięci długotrwałej w trakcie jednej rozmowy; ma stolik, na który aplikacja wykłada całą historię przy każdym pytaniu, i gdy historia przestaje się mieścić, coś z tego stolika spada, zwykle początek rozmowy. Najciekawsze w tym wszystkim jest to, że wyścig o długość okna właśnie się zakończył i to remisem: wg dokumentacji odczytanej czternastego października 2026 modele GPT-6 mają okno 1,05 mln tokenów, wszystkie cztery aktualne Claude po 1 mln, a Gemini 4 Argon milion. Wychodzi na to, że kontekst przestał być kryterium wyboru narzędzia, a zaczął być standardem, o który nikt już nie walczy. Ten tekst jest częścią przewodnika Podstawy AI: wyjaśniam tu, co się w oknie mieści, dlaczego czat mimo milion tokenów zapomina, czym kontekst różni się od pamięci i od treningu, oraz jak pracować z długimi dokumentami, żeby nie palić okna na darmo.
- Najważniejsze informacje
- Okno kontekstowe: co to jest, bez metafizyki
- Ile mieści milion tokenów
- Okna u ChatGPT, Claude i Gemini: stan na 14 października 2026
- Dlaczego czat zapomina, choć okno ma milion
- Jak pracować z długimi dokumentami bez wypalania okna
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Definicja | Cały tekst widziany naraz przez model: rozmowa, dokumenty, instrukcje; liczony w tokenach |
| GPT-6 (OpenAI) | 1,05 mln tokenów okna, 128 tys. tokenów wyjścia; dotyczy Astry, Sol i Luny |
| Claude (Anthropic) | 1 mln tokenów dla wszystkich czterech modeli: Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 |
| Gemini 4 Argon (Google) | 1 mln tokenów okna, dekodowanie do 1 mln tokenów |
| GPT-5.x (OpenAI) | Liczb okien dokumentacja nie podaje; zapisujemy wprost: nie ma danych |
| Kontekst a pamięć | Okno żyje w obrębie jednej rozmowy; pamięć aplikacji to osobny mechanizm |
| Stan liczb | Dokumentacja deweloperska trzech firm, odczyt 14 października 2026 |
Okno kontekstowe: co to jest, bez metafizyki
Wyobraź sobie, że rozmawiasz z kimś, kto przy każdym twoim zdaniu dostaje do przeczytania całą waszą korespondencję od początku, wszystkie załączone pliki i kartkę z instrukcjami. Dokładnie tak pracuje model językowy: przy każdym pytaniu aplikacja skleja w jeden długi tekst historię rozmowy plus twoją nową wiadomość i wysyła to wszystko do modelu. Ten jeden długi tekst to właśnie kontekst, a jego maksymalna długość to okno kontekstowe. Model niczego nie „pamięta” między zapytaniami w sensie ludzkim; po prostu za każdym razem dostaje wszystko od nowa, a skoro dostaje, to musi się mieścić.
Skąd się bierze zapominanie, skoro każda wiadomość nosi całą historię? Gdy rozmowa urośnie ponad okno, aplikacja musi coś odciąć albo streścić starsze fragmenty, zanim dosypie nowsze wiadomości. Pierwsze znika to, co najdawniej padło, dlatego długi czat „nie pamięta”, jak się przedstawiłeś na starcie, choć model jest ten sam. Okno to pojemność, nie trwała pamięć: zamkniesz rozmowę, otworzysz nową, i stolik jest znów pusty. Mechanizm przewidywania kolejnych fragmentów tekstu, który za tym stoi, rozłożyliśmy na czynniki pierwsze w poradniku Co to jest LLM.
Warto przy tym policzyć, że rozmowa rośnie z dwóch stron, nie tylko od twoich pytań. Wysyłasz wiadomość, model odpowiada, i przy następnym pytaniu aplikacja dokłada do kontekstu jedno i drugie; odpowiedzi modelu bywają dłuższe niż pytania, więc dziesięć wymian zjada kontekstu więcej, niż się wydaje przy pisaniu. Do tego dochodzą rzeczy, których nie widzisz: instrukcje systemowe aplikacji, definicje narzędzi u agentów, notatki z pamięci dosypane do rozmowy. Okno jest wspólne dla wszystkiego, co model dostaje, także dla tego, co dosypał mu program, a nie ty.
Ile mieści milion tokenów
Token to kawałek słowa, zwykle od pojedynczych znaków do całości krótkiego wyrazu; angielski tekst rozdrabnia się sprawniej, polski diakrytyki i końcówki rozsadzają na więcej kawałków, więc nasz akapit kosztuje w tokenach więcej niż jego angielski odpowiednik. Milion tokenów mieści z grubsza kilka grubych książek albo całą teczkę dokumentów projektowych, ale nie chcę tu doklejać fałszywej precyzji: dokładna przeliczanka na strony zależy od języka, formatowania i tego, czy wklejasz tekst, czy wrzucasz plik. Realny sens skali lepiej pokazuje wyjście: GPT-6 potrafi odpowiedzieć ciągiem do 128 tys. tokenów, czyli wydać jedną odpowiedź dłuższą niż niejedna książka, zanim padnie.
Dla porządku: te liczby to okna modeli w dokumentacji deweloperskiej, czyli w API. Aplikacje konsumenckie, takie jak ChatGPT czy Claude, pracują na tych samych modelach, ale dorzucają swoje mechanizmy zarządzania historią (ucinanie, streszczanie, podsyłanie notatek z pamięci), więc odczucie „ile zmieści rozmowę” w aplikacji bywa inne niż surowe okno z tabelki. O tym, jak aplikacja ChatGPT obchodzi się z archiwum i usuwaniem rozmów, piszemy w rozbiórce historii rozmów.
Sposób podania dokumentów też zmienia rachunek. Wklejony tekst wchodzi do okna dokładnie tak, jak go wkleisz, razem z twoimi błędami formatowania; plik wrzucony do aplikacji jest najpierw przetwarzany na jej sposób, więc model dostaje wersję uporządkowaną, a przy większych plikach aplikacja potrafi sama decydować, który fragment dosypać do okna w odpowiedzi na pytanie. Z polskimi dokumentami nie ma przy tym żadnej blokady: umowy, regulaminy i instrukcje po polsku wszystkie trzy czaty trawią bez problemu, płaci się tylko większą liczbą tokenów za naszą odmianę, o czym wspomniałem przy przeliczance.
Okna u ChatGPT, Claude i Gemini: stan na 14 października 2026
| Usługodawca | Model | Okno |
|---|---|---|
| OpenAI | GPT-6 Astra / Sol / Luna | 1,05 mln tokenów |
| Anthropic | Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 5.5 | 1 mln tokenów |
| Gemini 4 Argon | 1 mln tokenów |
Trzy firmy, trzy ekosystemy, jeden rząd wielkości. Jeszcze dwa lata temu okna mierzyły się w dziesiątkach tysięcy tokenów i każde podwojenie było newsem; dziś dokumentacja trzech konkurentów podaje liczby tak blisko siebie, że kupujący abonament może przestać zadawać pytanie o kontekst i zapytać o rzeczy, które faktycznie różnią produkty: limity wiadomości, integracje, cenę, jakość po polsku. Dla porządku zapisujemy też, czego w dokumentacji nie ma: dla starszych modeli GPT-5.x OpenAI liczb okien już nie publikuje, więc nie będziemy ich zgadywać.
Skąd ten wspólny milion, tego dokumentacje nie tłumaczą, więc i my nie będziemy wymyślać: zapisujemy zjawisko, nie jego przyczyny. Dla użytkownika znaczy to tyle, że różnice w obsłudze długich dokumentów między czatami wynikają dziś z mechanizmów aplikacji (jak ta aplikacja tnie i streszcza historię, jak podaje pliki, jakie ma limity wiadomości na plan), a nie z surowej pojemności okna, bo ta jest u trzech graczy niemal identyczna.
Gemini 4 Argon ma przy okazji ciekawą cechę zapisaną w dokumentacji: dekodowanie do 1 mln tokenów, czyli bardzo długi ciąg generowania w jednej odpowiedzi; o samej rodzinie Gemini 4 i o tym, co Argon oznacza dla planów cenowych, piszemy w osobnej analizie.
Dlaczego czat zapomina, choć okno ma milion
Bo okno to nie pamięć, a pamięć to nie trening, i te trzy rzeczy plącze się najczęściej. Kontekst żyje w obrębie jednej rozmowy i ginie z jej zamknięciem. Pamięć aplikacji, na przykład ta w ChatGPT, to osobny mechanizm, w którym asystent robi notatki o tobie między rozmowami; możesz ją obejrzeć i wyczyścić, o czym piszemy w tekście o pamięci ChatGPT. Trening to z kolei wchłonięcie miliardów tekstów przy tworzeniu modelu, z datą graniczną, po której model świata już nie zna, chyba że dostanie go w kontekście albo podpięte wyszukiwanie.
Scenariusz domyka obraz. Prowadzisz tydzień rozmowy z asystentem o swoim projekcie, zamykasz czat, wracasz po miesiącu w nowej rozmowie: kontekst jest pusty, więc model nie wie o projekcie nic poza tym, co zapisano w pamięci aplikacji jako trwałą notatkę. Gdybyś ten sam tydzień prowadził w jednym wątku, model „pamiętałby” wszystko, ale tylko dlatego, że aplikacja przy każdym pytaniu dosypywałaby mu całą historię od nowa. Ani raz nie zaszło nic, co przypominałoby ludzkie zapamiętywanie; wszystko sprowadza się do tego, co w danej chwili leży na stoliku.
Praktyczne konsekwencje są proste. Długa rozmowa zużywa okno, więc na nowy temat lepiej otworzyć nową rozmowę, a nie dokładać setną wiadomość do wątku sprzed tygodnia. Dokumenty lepiej wrzucić jako plik niż wklejać fragmentami, bo aplikacja poda je modelowi w uporządkowanej postaci. A jeśli zależy ci na notatkach, które mają przetrwać rozmowę, używaj pamięci aplikacji albo po prostu każ asystentowi streścić ustalenia przed zamknięciem czatu, bo streszczenie zabierzesz ze sobą, a kontekstu nie.
Jest jeszcze jeden trik znany z aplikacji czatowych: edycja starszej wiadomości. Gdy wracasz do środka rozmowy, zmieniasz tam jedno zdanie i wysyłasz ponownie, wątek przelicza się od tego miejsca, a wszystko, co padło później, schodzi ze stolika. To najszybszy sposób na „reset” błędnego toru w środku długiej rozmowy bez zaczynania wszystkiego od zera.
Jak pracować z długimi dokumentami bez wypalania okna
Kilka nawyków, które realnie oszczędzają kontekst. Najpierw selekcja: zamiast wrzucać całą teczkę, podaj fragmenty, o które naprawdę pytasz, bo okno zużywa też bezużyteczny balast. Potem pytania punktowe: „co mówi rozdział 4 o terminach” pracuje lepiej niż „przeczytaj i powiedz wszystko”. Przy wielu dokumentach pomaga najpierw poprosić o spis treści czy indeks, a dopiero potem dopytywać o strony. W pracy z kodem i większymi projektami ludzie sięgają po narzędzia, które same decydują, co dosypać do okna, ale to już wyższa szkoła jazdy; na poziomie czatu wystarczy trzymać się zasady, że nowy temat to nowa rozmowa.
Na przykładzie umowy najmu: zamiast wklejać dwadzieścia stron, wrzucasz plik, prosisz o listę klauzul z karami, dostajesz pięć cytatów z numerami paragrafów, i dopiero teraz pytasz o interpretację konkretnej klauzuli wraz z akapitem wokół niej. Rozmowa zostaje krótka, odpowiedzi celują w sedno, a ty nie płacisz (pieniędzmi w API albo limitem wiadomości w aplikacji) za przetrawienie dwudziestu stron przy każdym pytaniu.
Zostaje kwestia pieniędzy. W aplikacjach konsumenckich okno jest częścią abonamentu i nie liczysz go osobno, ale w API kontekst to realny koszt: płacisz za każdy token wejścia, więc milejaca rozmowa o sto tysięcy tokenów kosztuje sto razy więcej niż pytanie o tysiąc. Ceny za milion tokenów z polskim przykładem rozpisujemy w podstawach AI i przy okazji modeli w analizach; tam też znajdziesz wyjaśnienie tokenów.
Najczęstsze pytania
Okno kontekstowe co to jest?
To maksymalna ilość tekstu (rozmowa plus dokumenty plus instrukcje), którą model widzi naraz podczas pracy, liczona w tokenach. Po przekroczeniu okna aplikacja ucina lub streszcza starsze fragmenty rozmowy.
Okno kontekstowe ChatGPT: ile wynosi?
Modele GPT-6 (Astra, Sol, Luna) mają okno 1,05 mln tokenów i limit wyjścia 128 tys. tokenów wg dokumentacji deweloperskiej OpenAI. Dla starszych modeli GPT-5.x OpenAI liczb nie publikuje.
Okno kontekstowe Gemini: ile wynosi?
Gemini 4 Argon ma okno 1 mln tokenów i dekodowanie do 1 mln tokenów, podaje dokumentacja Gemini API. W praktyce plany w aplikacji różnicują limity wiadomości, nie samo okno.
Okno kontekstowe Claude: ile wynosi?
Wszystkie cztery aktualne modele Claude (Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5) mają okno 1 mln tokenów wg dokumentacji Anthropic.
Czy okno kontekstowe to to samo co pamięć czatu?
Nie. Okno żyje w obrębie jednej rozmowy i znika z jej zamknięciem. Pamięć aplikacji to trwałe notatki o tobie między rozmowami, a trening to wiedza modelu z czasu tworzenia; trzy różne mechanizmy.
Źródła
- Dokumentacja modeli OpenAI, GPT-6 context window: https://developers.openai.com/api/docs/models
- Dokumentacja modeli Anthropic, Claude context window: https://platform.claude.com/docs/en/docs/about-claude/models
- Dokumentacja Gemini API, modele i okna kontekstu: https://ai.google.dev/gemini-api/docs/models