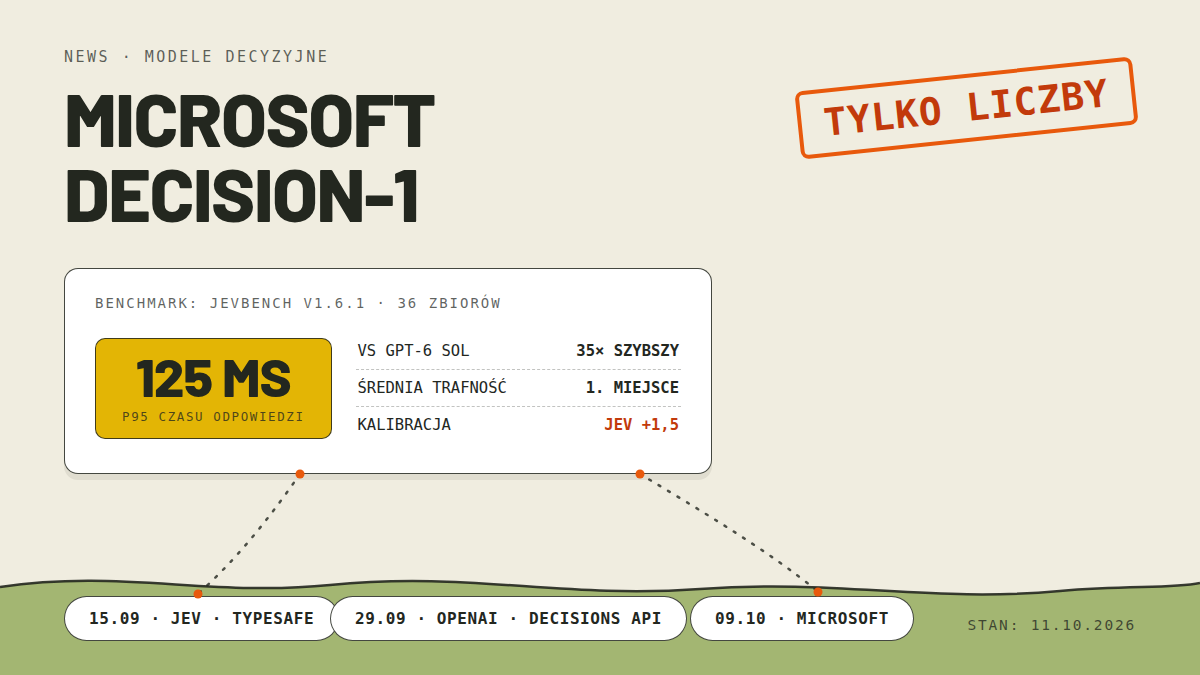
Dziewiątego października Microsoft ogłosił na firmowym blogu Command Line model o nazwie Microsoft-Decision-1. Nie pisze on esejów, nie odpowiada na pytania i nie prowadzi rozmowy. Dostaje tekst albo JSON oraz zestaw pytań zdefiniowanych z góry, a w odpowiedzi zwraca liczby: prawdopodobieństwo od 0 do 1, wybór jednej z opcji albo ocenę na wskazanej skali. Microsoft podaje go jako model do sortowania zgłoszeń, routingu zapytań, filtrowania treści i oceniania odpowiedzi innych modeli.
To już trzecie duże wejście w tę kategorię w niecałe trzy tygodnie. Piętnastego września TypeSafe pokazał Jeva, dwudziestego dziewiątego OpenAI otworzyło własne Decisions API, a teraz dołącza Microsoft z modelem, który we własnym porównaniu wyszedł najlepiej ze wszystkich startujących w nim modeli. Ten tekst wyjaśnia, czym różni się taki model od ChatGPT, co dokładnie zmierzył Microsoft, ile to kosztuje i jaką drogą dostaje się do tego z Polski.
Spis treści:
Model, który nie pisze, tylko decyduje
Dokumentacja Microsoftu opisuje trzy typy pytań, jakie przyjmuje model. Typ noul zwraca prawdopodobieństwo od 0 do 1, na przykład czy dokument zawiera próbę prompt injection albo czy odpowiedź wsparcia obiecuje zwrot pieniędzy. Typ choice dostaje podane z góry opcje i wskazuje jedną, dołączając rozkład prawdopodobieństwa na wszystkie. Typ score zwraca wartość na zdefiniowanej wcześniej skali z opisanymi poziomami. W odpowiedzi nie ma ani zdania uzasadnienia, ani free-form tekstu; jest typowana liczba, którą program może od razu użyć, na przykład ustawić próg odrzucenia. Odpowiedź wraca w obiekcie, którego pola nazywają się tak jak pytania z zapytania, do tego z nazwą wdrożonego modelu i zużyciem tokenów, więc jeden parser obsłuży każde takie zapytanie.
Sama idea nie jest nowa i Microsoft nie udaje, że ją wymyślił. Kategorię nazwał wcześniej TypeSafe, który piętnastego września pokazał Jeva, model zbudowany dokładnie po tym schemacie i opisany przez nas osobno. Dokumentacja Foundry mówi zresztą wprost, że wzorzec zapytań jest podobny do API systemu pierwszego, czyli odwołuje się do tego samego podziału Kahnemana na szybki odruch i wolne rozumowanie. Różnica siedzi w skali nadawcy: Jev to startup z rundą 870 milionów dolarów ogłoszoną również dziewiątego października, a Decision-1 to Microsoft z dystrybucją przez własną chmurę.
Ciekawszy od marketingu jest fundament techniczny. Microsoft pisze, że Decision-1 powstał przez post-training modelu Qwen3.5-9B, czyli otwartych wag od chińskiego zespołu Qwen, i zapowiada przebazowanie na inne modele, w tym własne MAI oraz OpenAI. W dyskusji na Hacker News to właśnie ten szczegół wywołał najwięcej komentarzy: firma, która latami budowała własne fundamenty, zaczyna kategorię od cudzego otwartego modelu, bo na tym poziomie zadania liczy się szybkość, cena i kalibracja, nie imię na pudełku.
Benchmark zbudowany na boisku konkurenta
Microsoft przyjął do porównania suite JevBench, czyli zestaw benchmarków utrzymywany przez TypeSafe, i zmierzył na nim 36 zbiorów, łącznie 147 137 pytań, z których żaden nie brał udziału w treningu. Decision-1 wyszedł stamtąd z najwyższą średnią trafnością spośród porównywanych modeli i jako najszybszy: 2,5 raza szybszy od drugiego w kolejce H2O-Lightning-4B v1.1 i 35 razy szybszy niż GPT-6 Sol, który poszedł do porównania jako punkt odniesienia dla dużych modeli czatowych.
Liczby czasu i kosztu wyglądają następująco. Mediana czasu odpowiedzi Decision-1 mieści się w 125 ms na 95 percentylu, a na trzech zbiorach użytych do porównania kosztu model klasyfikował każdy tekst w poniżej 200 ms; GPT-6 Sol potrzebował na to samo od 2,6 do 2,8 sekundy. Przeliczone na milion sklasyfikowanych tekstów wychodzi około 11 dolarów dla Decision-1 i około 2434 dolarów dla GPT-6 Sol, przy czym Sol płaci też za wyjście, a Decision-1 nie, bo zamiast tekstu zwraca kilka liczb.
Najciekawsza jest jednak trzecia miara, kalibracja, czyli zgodność deklarowanej pewności z realną trafnością. Tu Decision-1 zajął trzecie miejsce, 1,5 punktu za Jevem w wersji 1.13.0 i 0,9 za Quyet-1.0-Large, innym modelem tej samej kategorii. Kalibracja to dla kogoś, kto podpina taki model pod proces produkcyjny, często ważniejsza miara niż sama trafność: model zawsze pewny siebie jest mniej użyteczny niż ten, który wie, kiedy nie wie. Z notki edytorskiej na blogu wynika, że wyniki Jeva dodano do wykresów już po pierwszej publikacji wpisu, więc porównanie z nim nie było od początku głównym argumentem sprzedażowym.
Pomiar budował jednak Microsoft, choć na cudzym suite i z modelami konkurencji w zestawie, a wątek na Hacker News wyłapał, że na starcie zabrakło dokumentacji; ta pojawiła się jeszcze tego samego dnia w serwisie Microsoft Learn. Dla skali kategorii: model Strands-Decider 2B dał radę odpowiedzieć tylko na 23 z 36 zbiorów, więc rynek jest młody i nierówny.
Jak dostać się do Decision-1
Droga przez Microsoft Foundry wymaga konta Azure z podpiętą płatnością, projektu Foundry i roli pozwalającej tworzyć wdrożenia modeli; dokumentacja podaje Cognitive Services Contributor. Autoryzacja przez Microsoft Entra ID albo klucz API, quickstart w Pythonie 3.10 z biblioteką azure-identity prowadzi od wdrożenia do prostego klasyfikatora zgłoszeń supportu. Stawki za tokeny Microsoft publikuje dopiero w katalogu Foundry, czyli za logowaniem; w ogłoszeniu i dokumentacji ich nie ma, znam na razie tylko efektywny koszt z porównania, te 11 dolarów za milion tekstów.
Drugim kanałem ma być OpenRouter, agregator modeli, przez który płaci się jednym kontem za wiele dostawców. W publicznym katalogu API OpenRouter nie widziałem Decision-1 jeszcze jedenastego października rano, choć strona modelu już stoi, więc dystrybucja dopiero się rozkręca. Trzecia opcja dla kogoś, kto chce dzisiaj dotknąć tej kategorii bez Microsoftu, to Decisions API od OpenAI, w publicznej becie od szóstego października.
Wag Decision-1 do ściągnięcia nie ma. Model nie trafił na Hugging Face, więc lokalnie odpali się rodzina Kev od społeczności albo własne zabawy z Qwenem, nie oficjalny model Microsoftu.
Co z tego dla Polski
Całość jest po angielsku, ceny w dolarach, a przy karcie zapłacisz polski VAT według adresu rozliczeniowego. Konto Azure to formalność rzędu kilku minut, ale trzeba mieć świadomość, że mierzone przez Microsoft czasy odpowiedzi pochodzą z jednego regionu chmury; z Polski do każdej decyzji doliczysz jeszcze podróż pakietu do serwera i z powrotem.
Do realnych wdrożeń w polskich firmach na razie cicho, co przy modelu dostępnym od dwóch dni nie dziwi. Popyt po polsku dopiero się buduje: fraza „microsoft decision 1″ wyskakuje już jako pierwsza podpowiedź pod „microsoft decision”, a szersza fraza „modele decyzyjne” działa w Google jako język ogólny, więc kto szuka po polsku, znajduje dziś głównie materiały o drzewach decyzyjnych z kursów statystyki, nie o tej kategorii modeli.
Źródła
Microsoft Command Line, „Introducing Microsoft-Decision-1, our model for fast decision-making”, 09.10.2026, commandline.microsoft.com
Microsoft Learn, „Deploy and use Microsoft-Decision-1 in Microsoft Foundry”, stan na 11.10.2026, learn.microsoft.com
Dyskusja nad ogłoszeniem na Hacker News, 09.10.2026, news.ycombinator.com
OpenAI, „Decisions API is in public beta”, 06.10.2026, developers.openai.com
TypeSafe AI, „TypeSafe A raises Series AI”, 09.10.2026, typesafe.ai
Thibault Sottiaux na X, ogłoszenie Decisions API, 29.09.2026, twitter.com
Nota uczciwości
Modelu nie testowaliśmy: droga przez Foundry wymaga konta Azure z podpiętą płatnością, a kont nie zakładamy w ramach testów. Wszystkie liczby pochodzą z materiałów Microsoftu (blog Command Line i dokumentacja Learn) oraz dyskusji na Hacker News, przy czym benchmark zbudował sam Microsoft, traktuj go więc jako materiał producenta, nie niezależny test. Stan wiedzy: 11 października 2026.