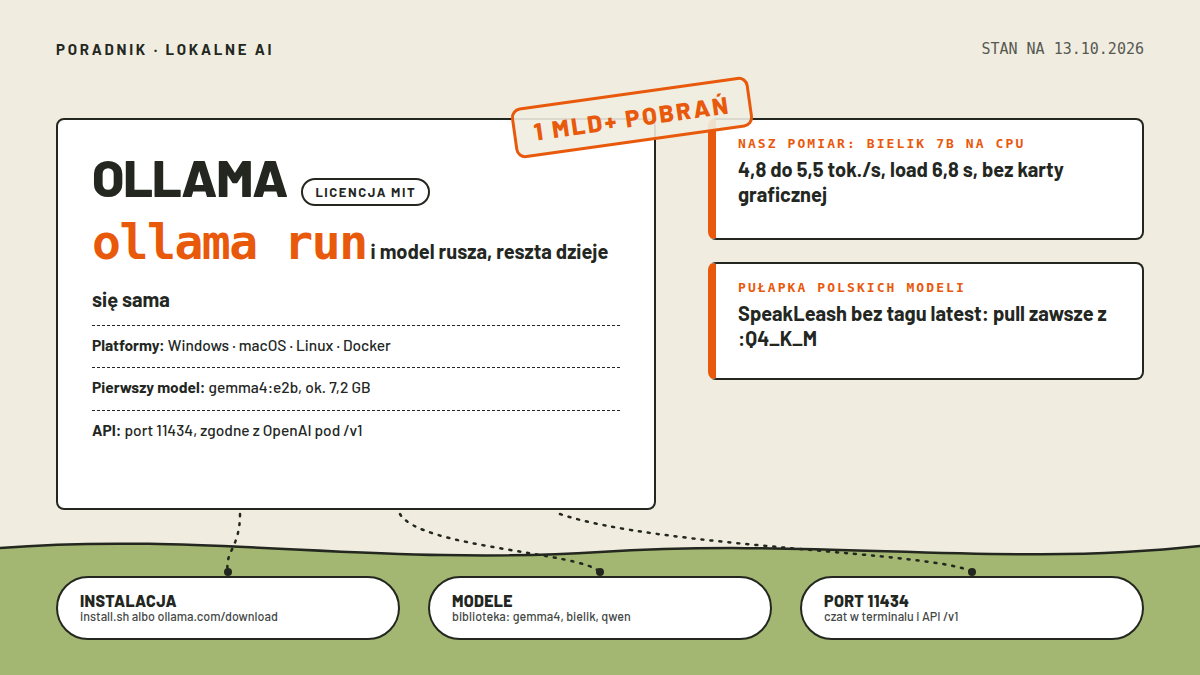
Gdyby lokalna sztuczna inteligencja miała jeden przycisk, byłby nim Ollama. To narzędzie, które sprowadza uruchamianie otwartych modeli na własnym komputerze do jednego polecenia w terminalu, i które zrobiło to na tyle dobrze, że liczba jego instalacji przekracza dziewięć milionów miesięcznie, a z biblioteki modeli pobrano już ponad miliard sztuk. Ta strona jest przewodnikiem od zera: skąd pobrać, jak zainstalować na Windows, Macu i Linuksie, jak uruchomić pierwszy model, co zrobić, żeby rozmawiać po polsku, i co robić, gdy coś się wysypie. Wszystkie ścieżki zweryfikowaliśmy 13 października 2026, a większość przeszliśmy na własnej maszynie, więc obok dokumentacji znajdziesz tu nasze pomiary i błędy, które sami złapaliśmy.
Żeby nie było złudzeń na starcie: Ollama nie jest modelem ani polskim produktem. To darmowe narzędzie o otwartym kodzie na licencji MIT, którego twórcy siedzą za oceanem, a jego zadaniem jest spakowanie całej mało przyjaznej machiny uruchamiania modeli, silnika llama.cpp i pobierania plików, w jedno słowo wpisywane w terminalu. Po polsku bywa z nim jak z większością narzędzi tego typu: działa świetnie, ale dokumentacja i komunikaty są po angielsku, i właśnie tę lukę ta strona łata.
- Najważniejsze informacje
- Co to jest Ollama i skąd ta popularność
- Instalacja krok po kroku
- Pierwszy model i pierwsza rozmowa
- Rozmowa po polsku i jakość odpowiedzi
- Ollama na słabszym komputerze
- API dla skryptów: Ollama jako lokalny serwer
- Nasz pomiar na zwykłym procesorze
- Co gdy nie działa
- Ściąga: Ollama w pięciu krokach
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły | |
|---|---|---|
| Czym jest | darmowe narzędzie do lokalnych modeli AI (MIT) | |
| Platformy | Windows, macOS, Linux, Docker | |
| Instalacja Linux | curl -fsSL https://ollama.com/install.sh \ | sh |
| Pierwszy model | ollama run gemma4:e2b, pobiera ok. 7,2 GB | |
| Domyślny port | 11434, API zgodne z OpenAI pod /v1 | |
| Kontekst domyślny | 4096 tokenów, zmienia się przez OLLAMA_CONTEXT_LENGTH | |
| Polski model | bielik od SpeakLeash, wymaga jawnego tagu | |
| Nasz test CPU | Bielik 7B: 4,8 do 5,5 tok./s | |
| Cena | 0 zł, także do użytku firmowego |
Co to jest Ollama i skąd ta popularność
Liczby z oficjalnej strony mówią same za siebie: ponad dziewięć milionów instalacji miesięcznie, ponad miliard pobrań modeli, ponad dwieście bilionów przetworzonych tokenów i 183 tysiące gwiazdek na GitHubie, co stawia projekt w ścisłej czołówce otwartego oprogramowania ostatnich lat. Sekret jest prosty: przed Ollamą uruchomienie modelu lokalnie oznaczało kompilację silnika, szukanie plików wag, dopasowywanie parametrów kwantyzacji i modlenie się o zgodność. Po Ollamie to jedno polecenie, które pobiera, uruchamia i otwiera czat.
Projekt jest otwarty na licencji MIT, więc można go używać także komercyjnie i w firmie bez opłat. Obok trybu lokalnego strona projektu oferuje jeszcze modele w chmurze producenta, dla osób bez własnej karty graficznej, ale ten przewodnik trzyma się wersji lokalnej, bo to ona daje pełną prywatność i pracę bez internetu po pobraniu modelu.
Do klimatu dodajmy kontekst z naszej serii, zbieranej na hubie lokalnego AI: to właśnie przez Ollamę przepuściliśmy polskiego Bielika w teście na zwykłym procesorze, narzędzie okazało się na tyle przewidywalne, że pomiar powtarzaliśmy wielokrotnie bez niespodzianek, a skrajnym biegunem tej samej serii jest eksperyment z modelem BitNet na mikrokontrolerze ESP32, pokazujący, że lokalne AI schodzi aż do płytki za kilkadziesiąt złotych.
Instalacja krok po kroku
Na Linuksie instalacja to jeden wiersz: `curl -fsSL https://ollama.com/install.sh | sh`. Skrypt doda repozytorium, zainstaluje program i usługę w tle, więc po restarcie Ollama wstaje sama. Na Windows i macOS pobierasz instalator ze strony ollama.com/download, klikasz przez kreatora i dostajesz ikonkę w zasobniku systemowym; aktualizacje przychodzą potem same, przez opcję restartu do nowej wersji. Najwyższa wersja, na której testowaliśmy, to 0.40.3.
Jest też droga bez instalowania czegokolwiek w systemie, którą wybraliśmy do naszych pomiarów: pobranie paczki z binarkami prosto z release’ów na GitHubie i uruchomienie z dowolnego katalogu. Serwer rusza poleceniem `ollama serve`, a katalog na modele i adres portu ustawiasz zmiennymi środowiskowymi, więc nic nie rusza w systemie. Dla początkujących to ciekawostka, dla porządku w systemie zbawienie.
Po instalacji sprawdź, że wszystko żyje: polecenie `ollama list` wypisze pustą listę modeli i nie zgłosi błędu, co znaczy, że klient widzi działający serwer.
Wariant czwarty, dla lubiących kontenery: oficjalny obraz na Dockera, z dokumentacją w podstronie docker.md, uruchamia Ollamę w izolacji z przymontowanym katalogiem na modele. W domowym użytkowaniu rzadko potrzebny, w serwerowni albo na firmowym NAS-ie bywa jedynym sensownym sposobem, bo aktualizacja to wtedy ściągnięcie nowego obrazu bez ruszania reszty systemu.
Pierwszy model i pierwsza rozmowa
Kolejność jest jednorazowa i pamiętna. Wpisujesz `ollama run gemma4:e2b`, Ollama sprawdza bibliotekę, pobiera około 7,2 GB modelu z paskiem postępu, po czym otwiera czat prosto w terminalu. Od tej chwili piszesz po polsku, a model odpowiada; dokumentacja zaleca dla tego modelu osiem gigabajtów pamięci wideo albo zunifikowanej pamięci Maca, ale przy mniejszej ilości model nie odmawia współpracy, tylko schodzi do pamięci systemowej kosztem tempa. Rozmowę kończysz wpisując `/bye`, listę pobranych modeli sprawdzisz przez `ollama list`, a pobranie bez czatu robisz przez `ollama pull` z tą samą nazwą.
Nazwa modelu ma swoją gramatykę i warto ją zrozumieć od razu. Część przed dwukropkiem to model, część po dwukropku to wariant, najczęściej kwantyzacja albo rozmiar: `gemma4:e2b` to konkretny rozmiar, a `:Q4_K_M`, które zaraz zobaczysz przy Bieliku, to konkretny stopień kompresji. Pejzaż wariantów przeglądasz na ollama.com/search, gdzie każdy model ma stronę z listą tagów i rozmiarami.
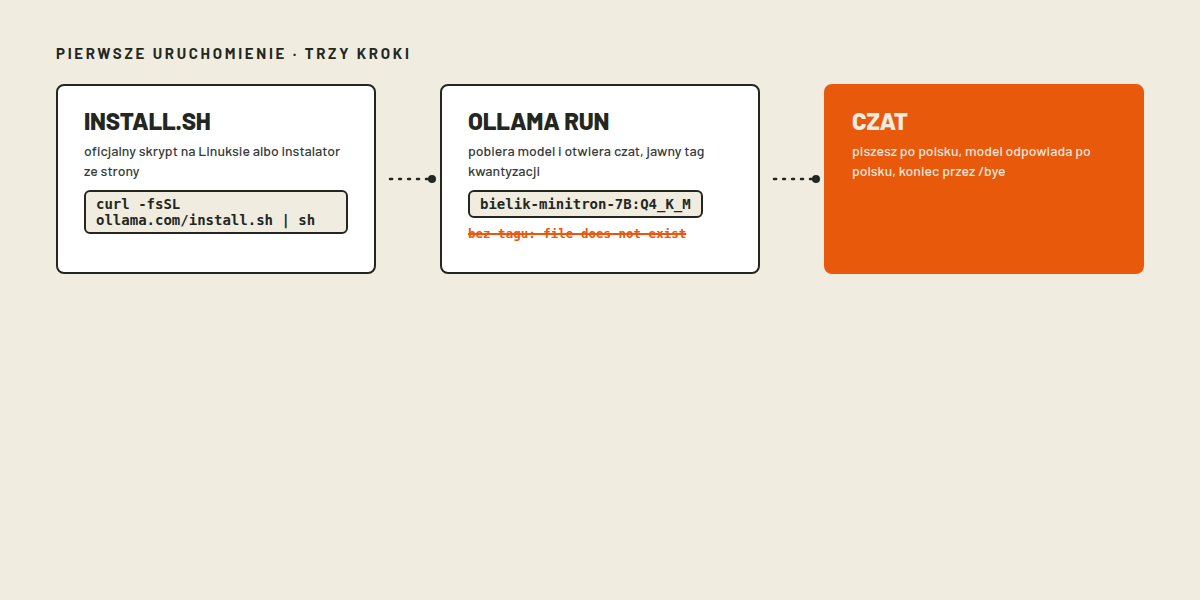
Tu wchodzi nasze odkrycie z testów, którego nie znajdziesz w dokumentacji Ollama: część autorów, w tym polski SpeakLeash, nie publikuje domyślnego tagu latest. Polecenie `ollama pull speakleash/bielik-minitron-7B-v3.0-instruct` skończy się błędem o braku pliku, zanim dodasz tag, na przykład `:Q4_K_M`. Zanim uznasz, że model nie istnieje, wejdź na jego stronę w bibliotece i sprawdź zakładkę z tagami.
Rozmowa po polsku i jakość odpowiedzi
Nie ma tu żadnego przełącznika języka, i to jest plus. Model jest wielojęzyczny, więc piszesz po polsku, a on odpowiada po polsku; jakości nie trzeba wymuszać konfiguracją, bo zależy od samego modelu. W naszym teście Bielik Minitron 7B pisał płynną, naturalną polszczyzną, radził sobie z rejestrem kulturowym, ale na pytaniu technicznym poza swoją kompetencją skonfabulował pewną siebie bzdurę. Ta przestroga dotyczy lokalnych modeli ogólnie: im mniejszy model i mocniejsza kompresja, tym czujniej traktuj jego fakty.
Podpowiedź praktyczna na koniec rozmów: Ollama trzyma model w pamięci jeszcze pięć minut po ostatniej wiadomości, więc kolejne pytanie pada natychmiast, bez ładowania gigabajtów. Kto chce mieć model w pamięci na stałe, ustawi zmienną OLLAMA_KEEP_ALIVE na wartość -1, a kto chce zwalniać od razu, na zero.
Ollama na słabszym komputerze
Trzy pokrętła decydują o tym, czy Ollama zmieści się na twoim sprzęcie. Pierwsze to rozmiar modelu: wariant 7B w kompresji Q4 zajmuje około 4,5 GB i działa na 16 GB ramu bez karty graficznej, o czym przekonaliśmy się własnym pomiarem. Drugie to długość kontekstu, czyli okno pamięci rozmowy: domyślne 4096 tokenów jest oszczędne, ale przy wklejaniu długich dokumentów odpowiedzi będą się gubić; zmieniasz je globalnie przez OLLAMA_CONTEXT_LENGTH albo per rozmowa komendą `/set parameter num_ctx` w czacie. Trzecie to dysk: modele lądują w katalogu ukrytym `.ollama` w twoim profilu (na Linuksie w ścieżce systemowej), a gdy partycja z systemem jest mała, zmienna OLLAMA_MODELS przenosi skład modeli gdzie indziej, na przykład na drugi dysk.
Ilość pamięci wideo nie jest warunkiem. Bez karty graficznej liczy procesor i ram, odpowiedzi przychodzą w tempie spokojnego czytania; z kartą model trafia do niej automatycznie i przyspiesza wielokrotnie.
API dla skryptów: Ollama jako lokalny serwer
To funkcja, dla której programiści pokochali to narzędzie. Działający Ollama wystawia na lokalnym porcie 11434 pełne API, w tym endpointy zgodne z OpenAI pod ścieżką `/v1`, więc skrypt pisany pod ChatGPT przenosisz na lokalny model, zmieniając jeden adres. Dokumentacja opisuje też natywne endpointy czatu i generowania, biblioteki dla Pythona i JavaScript oraz zgodę z formatem narzędzi.
Nasze pomiary z sekcji niżej robiliśmy dokładnie tym kanałem: lokalny serwer, zapytanie POST, odpowiedź z licznikami tokenów i czasami, z których wyliczyliśmy prędkość. Jedna decyzja konfiguracyjna przed wystawieniem API na sieci lokalnej: domyślnie serwer słucha tylko na twoim komputerze; zmienna OLLAMA_HOST z wartością 0.0.0.0 otwiera go innym urządzeniom w domu albo firmie, co bywa wygodne przy jednym mocnym komputerze i kilku laptopach.
Nasz pomiar na zwykłym procesorze
Liczby z własnej maszyny, bez karty graficznej, dwanaście wątków procesora i 62 GB ramu, model Bielik Minitron 7B w kompresji Q4_K_M pobrany z rejestru Ollama. Załadowanie wag przy pierwszym pytaniu: 6,8 sekundy. Generowanie: od 4,8 do 5,5 tokena na sekundę przy odpowiedziach po 250 do 290 tokenów, czyli pełna odpowiedź rodziła się około minuty. Na tym samym modelu i sprzęcie wersja headless LM Studio osiągnęła 2,2 tokena na sekundę, więc domyślne strojenie Ollama wypada w tym porównaniu ponad dwukrotnie lepiej; szczegóły obu pomiarów rozłożyliśmy we wpisie o LM Studio, a kontekst wyboru modeli opisuje przewodnik po lokalnym AI na komputerze.
Co gdy nie działa
Cztery sytuacje zdarzają się najczęściej i wszystkie da się rozwiączyć w minutę. Błąd o braku pliku przy pobieraniu: brak tagu latest u autora modelu, lekarstwo to jawny tag z zakładki na stronie modelu, jak przy Bieliku. Serwer nie wstaje po instalacji: najpewniej port 11434 zajęła inna usługa albo druga instancja Ollama; sprawdź `ollama list`, a konflikt portów rozwiążesz zmienną OLLAMA_HOST z innym portem. Model odpowiada, ale gubi początek długiej rozmowy: domyślne okno 4096 tokenów się skończyło, podnieś kontekst przez OLLAMA_CONTEXT_LENGTH albo `/set parameter num_ctx`. Dysk pełny: `ollama list` pokaże rozmiary, nieużywane modele usuwasz przez `ollama rm` z nazwą, a przyszłe pobrania kierujesz zmienną OLLAMA_MODELS na większy dysk.
Osobna kategoria to pytania o bezpieczeństwo, bo serwer lokalny to jednak serwer. Domyślna konfiguracja słucha wyłącznie na twoim komputerze i jest rozsądna; wystawianie na sieć przez OLLAMA_HOST rób świadomie, tylko w zaufanej sieci, bo endpoint nie ma hasła ani logowania.
Wreszcie aktualizacje, o które pytają czytelnicy po pierwszym miesiącu. Na Windows i macOS aplikacja w zasobniku sama zaproponuje restart do nowej wersji, więc nie ma co kombinować. Na Linuksie nie ma autoaktualizacji: najnowszą wersję wgrywasz, powtarzając ten sam oficjalny skrypt install.sh co przy pierwszej instalacji, a pobrane wcześniej modele i ustawienia zostają nietknięte. Wersję sprawdzisz poleceniem `ollama –version`, a przed dużym przeskokiem numeru warto zajrzeć do notki wydania na GitHubie, bo zmieniały się w historii domyślne wartości kontekstu i zasady wykrywania kart graficznych.
Ściąga: Ollama w pięciu krokach
| Cel | Ścieżka |
|---|---|
| Instalacja | ollama.com/download albo install.sh na Linuksie |
| Pierwszy model | ollama run gemma4:e2b (pobiera ok. 7,2 GB) |
| Polski model | ollama run speakleash/bielik-minitron-7B-v3.0-instruct:Q4_K_M |
| Rozmowa po polsku | po prostu pisz po polsku, bez przełączników |
| API dla skryptów | port 11434, endpointy zgodne z OpenAI pod /v1 |
Po każdej większej aktualizacji projektu warto zajrzeć na blog twórców, bo zmieniają się domyślne wartości i lista obsługiwanych mechanizmów kart graficznych.
Najczęstsze pytania
Ollama: co to jest?
Darmowe narzędzie open source na licencji MIT, które uruchamia otwarte modele językowe na twoim komputerze jednym poleceniem. Samo w sobie nie jest modelem ani firmą AI: pobiera wybrany model z biblioteki, np. Gemmę, Bielika czy Kwena, i pozwala z nim rozmawiać w terminalu albo przez lokalne API. Działa na Windows, macOS i Linuksie.
Ollama download: skąd pobrać?
Ze strony ollama.com/download dla Windows i macOS albo przez oficjalny skrypt install.sh na Linuksie. Instalator jest darmowy; pobieranie z nieoficjalnych mirrorów odradzamy, jak przy każdym narzędziu z dostępem do twojego komputera.
Czy Ollama jest darmowe?
Tak, na dwóch poziomach: licencja MIT pozwala używać narzędzia bez opłat, także w firmie, a modele z biblioteki mają własne licencje, w większości otwarte. Płatne bywają tylko modele w chmurze producenta, z których korzysta się dobrowolnie, gdy nie masz lokalnego GPU.
Jak używać Ollama API?
Ollama wystawia lokalny serwer na porcie 11434 z endpointami zgodnymi z OpenAI pod /v1 oraz natywnymi endpointami czatu i generowania. W skrypcie wystarczy zamienić adres API na localhost:11434, biblioteki dla Pythona i JavaScript są w dokumentacji. Zmienną OLLAMA_HOST wystawisz serwer w sieci lokalnej.
Ollama na Windows: jakie wymagania?
Instalator 64-bitowy ze strony producenta, najlepiej 16 GB ramu i trochę wolnego miejsca na modele (od kilku do kilkudziesięciu GB). Karta graficzna przyspiesza pracę, ale nie jest wymagana: bez niej model liczy się na procesorze, wolniej, ale poprawnie.
Nota uczciwości
Ścieżki instalacji, polecenia, zmienne środowiskowe i liczby statystyczne pochodzą z oficjalnej strony i dokumentacji Ollama pobranej 13 października 2026 oraz z API GitHuba (licencja, gwiazdki). Pomiary prędkości i wszystkie opisane błędy to nasze własne przejścia: przenośna wersja 0.40.3 na Linuksie, model Bielik Minitron 7B v3.0 Q4_K_M od SpeakLeash, procesor bez karty graficznej, okno kontekstu domyślne. Trybu chmurowego ani aplikacji na Windows nie testowaliśmy. Ilustracje są stylizowanymi mapami ścieżek, nie zrzutami ekranu.
Źródła
- Ollama, strona główna: statystyki i biblioteka modeli (pobrane 13.10.2026): https://ollama.com
- Ollama, szybki start: instalacja i pierwszy model (pobrane 13.10.2026): https://docs.ollama.com/quickstart
- Ollama, FAQ: lokalizacje modeli, zmienne środowiskowe, kontekst (pobrane 13.10.2026): https://docs.ollama.com/faq
- Ollama, zgodność API z OpenAI (pobrane 13.10.2026): https://docs.ollama.com/api/openai-compatibility
- Ollama, repozytorium GitHub: licencja MIT (pobrane 13.10.2026): https://github.com/ollama/ollama