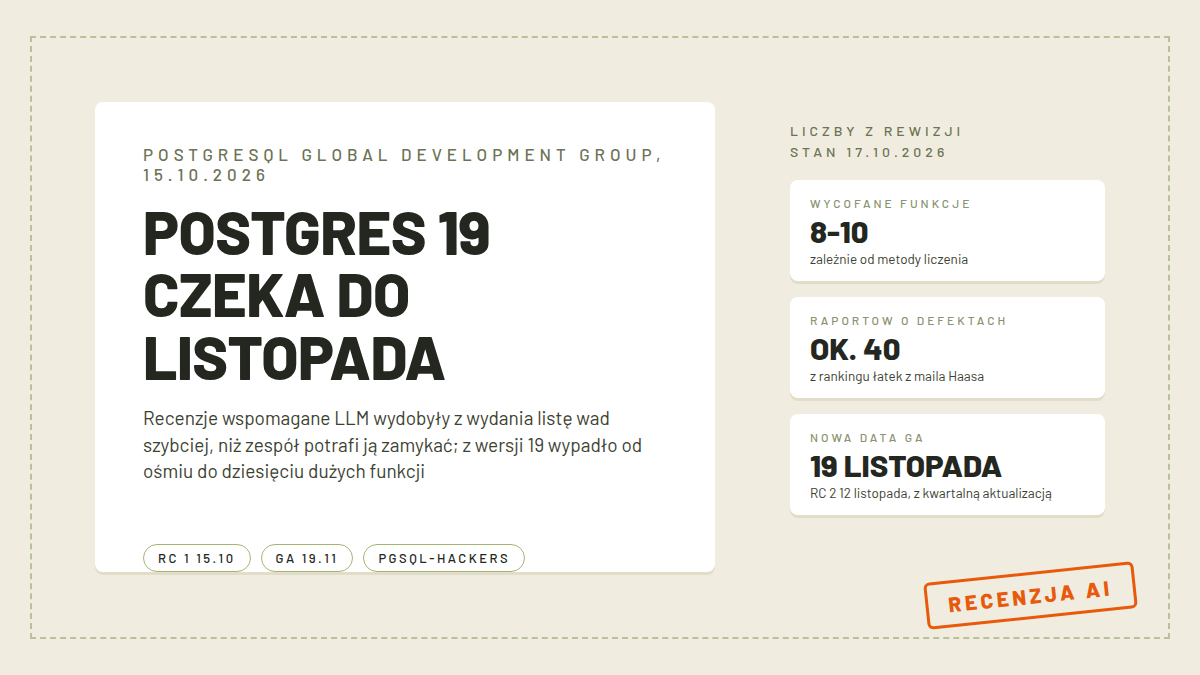
Postgres 19 miał trafić do użytkowników jesienią, zgodnie z rytuałem corocznych dużych wydań, które ostatnio lądowały pod koniec września; oficjalna roadmapa mówiła o październiku 2026. Zamiast tego 15 października zespół opublikował pierwszego kandydata wydania i twardą datę: 19 listopada 2026 jako planowaną ogólną dostępność. Po drodze z PostgreSQL 19 wypadło od ośmiu do dziesięciu istotnych funkcji. Recenzje kodu wspomagane modelami językowymi wyciągają z kodu tak długo ukrywaną listę problemów, że ludzie nie nadążają jej domykać przed premierą. Peter Eisentraut, jeden z czołowych komitterów projektu i wiceprezes EDB, napisał to na blogu wprost: patrzysz na listę czterdziestu raportów o defektach i nawet jeśli każdy wymaga średnio trzech linijek poprawki, każdy ma też stały narzut obsługi, po którym czas się kończy.
To nie ciekawostka z życia bazy danych, tylko twarda odpowiedź na pytanie każdego zespołu: co się dzieje z harmonogramem, gdy narzędzie do szukania problemów nagle staje się lepsze niż narzędzie do ich naprawiania. W PostgreSQL wyszły z tego dwa miesiące opóźnienia względem wrześniowego rytmu, kilka tygodni względem październikowej roadmapy i paczka funkcji przesunięta o rok.
- Najważniejsze informacje
- Co dokładnie się przesunęło
- Jak do tego doszło: od maila Haasa do wycofań
- Model znajduje, człowiek nie nadąża
- Więcej błędów czy więcej wiedzy o błędach
- Co to znaczy dla pracy z AI
- Co dalej z Postgresem 19
- FAQ
Najważniejsze informacje
| Co | Stan na odczyt 17.10 |
|---|---|
| Nowa data | GA PostgreSQL 19 planowana na 19 listopada 2026, RC 2 na 12 listopada (ogłoszenie z 15.10) |
| Skala cięć | od 8 do 10 istotnych funkcji wycofanych z gałęzi wydania, większość pójdzie do wersji 20 |
| Powód wg zespołu | recenzje wspomagane LLM znajdują długą listę drobnych wad szybciej, niż ludzie zdołają ją zamknąć |
| Czy to vibe coding | nie, Eisentraut: kod powstał dawno, zanim to stało się możliwe |
| Punkt wyjścia | mail Roberta Haasa z 25 sierpnia z rankingiem najgroźniejszych łatek, przygotowanym przez Claude |
| Wątek HN | 198 punktów, 77 komentarzy (odczyt 17.10) |
Co dokładnie się przesunęło
Duże wydania PostgreSQL zwykle idą tak: zamrożenie funkcji wiosną, trzy bety do sierpnia, kandydat na przełomie sierpnia i września, wersja stabilna pod koniec września. Poprzednie wersje trzymały ten rytm niemal co do tygodnia, 18.0 wyszła 25 września 2025, 17.0 26 września 2024, 16.0 14 września 2023.
Formalnie potwierdziło je ogłoszenie z 15 października: RC 1 wyszedł tego dnia, RC 2 wyjdzie 12 listopada, razem z kwartalną zbiorczą aktualizacją obsługiwanych wersji, bo zespół chce wpuścić do wydania dużą paczkę poprawek, a GA ma wypaść tydzień później, pod warunkiem że nic się nie wysypie. W ogłoszeniu widać zresztą ślad wrześniowej burzy: w poprawkach czwartej bety figurują łatki do REPACK (CONCURRENTLY) i pg_plan_advice, obszarów spornych we wrześniu.
Cięcia są większe niż data. Z wydania wycofano od ośmiu do dziesięciu istotnych funkcji, zależnie od metody liczenia. Najgłośniejszy jest powrót zapytań do grafów właściwości ze standardu SQL, SQL/PGQ, implementowanego przez samego Eisentrauta i Ashutosha Bapata. Tom Lane z core team pisał, że stawia kolację: jeśli to wyślą w wersji 19, po premierze wyjdą błędy nienaprawialne do wersji 20. Zespół zarządzający wydaniem zgłosił poważne zastrzeżenia i PGQ wypadł z obu gałęzi, 19 i mastera. Czy wróci na czas do wersji 20, w chwili pisania nie ma rozstrzygnięcia.
Jak do tego doszło: od maila Haasa do wycofań
Punkt wyjścia da się wskazać co do dnia. 25 sierpnia Robert Haas, weteran projektu z EDB, wysłał na listę pgsql-hackers maila z tematem scary patch contest. Zaczął od zdania, które obiegło sieć: poprosił Claude o ocenę, które łatki wersji 19 są najgroźniejsze, na podstawie liczby i typu błędów naprawianych po zamrożeniu. Wyniki opublikował z dopiskiem, że wyciął z nich kilka szczególnie obciachowych uwag modelu, i zapytał, czy któraś z łatek jest w tak złym stanie, że trzeba ją wycofać przed premierą.
Lista miała sześć pozycji i każdą da się policzyć. Sprawdzanie kluczy obcych z fast-path i batchowaniem: około 16 poprawek, w tym zapis poza zakresem pamięci i pięć klas błędnego egzekwowania kluczy. REPACK z REPACK CONCURRENTLY: 28 poprawek, między nimi utrata danych i dwie z gatunku bezpieczeństwa. Online data checksums: około 25 poważnych poprawek, a funkcja wykrywająca uszkodzenia danych, która fałszywie alarmuje, to w ocenie Haasa dokładnie zły tryb awarii. FOR PORTION OF dla tabel temporalnych: 17 poprawek, trzy bezpieczeńściowe, a macierz interakcji z widokami, kolumnami generowanymi i partycjami wymagała po zamrożeniu zakazów albo naprawy kawałek po kawałku. SQL/PGQ: 17 poprawek, generalnie lżejszych, statystyki w postgres_fdw: 7. Haas podsumował, że boi się długiego ogona niewykrytych błędów w pierwszej trójce.
Dyskusja pokazała, że projekt nie miał procedury na taką sytuację. Bruce Momjian z core team pisał o bezprecedensowej sytuacji: wycofujemy kilka dużych funkcji naraz i nie wiemy, czy ich brak nie połamie innych zmian. Doszła czwarta beta, zapowiedziana przez Jonathana Katza na 24 września, a daty RC i GA pozostały niewypisane. Joshua Drake 7 września zaproponował nawet przesunięcie premiery na wiosnę 2027, z argumentem o letnim oknie testowym, ale na dzień podsumowania LWN nikt na ten pomysł nie odpowiedział.
Model znajduje, człowiek nie nadąża
Sedno sprawy leży w ekonomii, którą Eisentraut rozpisał 9 października. Część wycofanych funkcji miała wady architektoniczne nienaprawialne szybko w okresie bety. Ale obok nich szła długa lista drobiazgów przy krawędziowych przypadkach, które kiedyś wychodziły na jaw latami po premierze. Z recenzją wspomaganą LLM wychodzą w tygodnie. I tu jest haczyk: nawet gdy każdy raport wymaga trzech linijek, obsługa każdego ma swój stały narzut, a raportów jest około czterdziestu. Wąskim gardłem przestało być znajdowanie problemów, stało się ich zamykanie.
Do tego dochodzi fakt, o którym Eisentraut pisze z niedowierzaniem. Dotknięte funkcje powstały dawno, gdy recenzja kodu przez modele była bezużyteczna albo w ogóle nieosiągalna. W trakcie jednego cyklu skuteczność tych narzędzi skoczyła na tyle, że poprzeczka jakości wzrosła po tym, jak kod był już napisany i wkommitowany. Wydanie pakowane według starych kryteriów oceniono według nowych. Eisentraut prognozuje, że jeśli tempo poprawy LLM wyhamuje, sprawa wyrówna się w kolejnych cyklach, a fuzzing wspomagany modelem powinien zostać stałą częścią pisania funkcji, bo wypisuje kombinacje kontekstów, których nikt człowiek nie umie wyliczyć.
Sprawę komplikuje czynnik niezwiązany z AI. Eisentraut wspomina falę poprawek bezpieczeństwa, którą nazywa Vulnpocalypse: między kwietniem a sierpniem starsi programiści byli odciągnięci do łatek bezpieczeństwa, więc weryfikacja w okresie bety była cieńsza niż zwykle. Gdy w sierpniu wrócili, na wierzch wyszła kopia problemów naraz. Społeczność wybrała trzymanie się harmonogramu zamiast dalszego zwlekania, bo, jak pisze, nigdy nie wiadomo, jak długi jest długi ogon.
Więcej błędów czy więcej wiedzy o błędach
Pytanie, czy software nagle ma więcej błędów, czy po prostu od niedawna wiemy o wszystkich, których zawsze było pełno, pojawiło się w projekcie dawno przed tą aferą. LWN podsumowało je 10 września: Melanie Plageman z zespołu zarządzającego wydaniem pytała na liście, czy modele ułatwiające testowanie funkcji na wytrzymałość sprawiają, że błędy znajdujemy szybciej niż kiedyś. Nathan Bossart z tego samego zespołu spodziewał się, iż LLM ustabilizują nowe funkcje jeszcze przed zamrożeniem, i napisał wprost, że się to nie potwierdziło. Daniel Gustafsson dodał, że większość dużych funkcji w 19 powstała, zanim narzędzia AI w ogóle istniały albo były choć trochę tak dobre jak dziś.
Wątek Hacker News z 16 października dorzucił głos sceptyczny. Jeden z komentujących przypominał podobną historię z jądrem Linuksa, gdzie z 82 zgłoszonych przez model błędów rzeczywistymi okazało się zaledwie kilka. Inny przestrzegał, żeby nieedytowanego raportu z modelu nie wrzucać do bugtrackera bez ludzkiej weryfikacji, choć więcej par oczu zawsze pomaga. To się spina z tym, co napisaliśmy w tekście o bezpieczeństwie vibe codingu: wynik modelu to wskazówka do sprawdzenia, nie rozstrzygnięcie. Każdy punkt listy Haasa ktoś musiał otworzyć, przeczytać i potwierdzić, zanim padło słowo revert.
Co to znaczy dla pracy z AI
Najciekawszy w tej historii jest dla mnie kontekst zawodowy. Kiedy mówimy o pracy z modelami, dyskusja kręci się wokół pisania kodu, a tymczasem zastosowanie, które właśnie wywróciło harmonogram najbardziej rozpoznawalnej bazy open source, to recenzja. Zgadza się to z tym, co pokazuje wprowadzenie automatycznego code review u Claude Code: pierwszą liną frontu staje się model czytający różnice, nie model je produkujący. Samo pisanie zdaje się być najmniej wymagającą częścią układanki, o czym piszemy szeroko w hubie o vibe codingu.
Dla zespołów płynie stąd konkretna konsekwencja planistyczna. Jeśli wdrażacie recenzję AI w projekcie, który żyje od lat, załóżcie w pierwszym cyklu bufor na naprawę tego, co recenzja wyciągnie z historii kodu, bo poprzeczka podnosi się w środku waszego harmonogramu, nie na jego początku. Recenzent, który nie napisał ani linijki, może zatrzymać wydanie, i to jest teraz udokumentowany przypadek, nie hipoteza. Jak to odbija się na rolach w zespołach i na juniorach, rozpisujemy w tekście o vibe codingu a pracy. Uczciwość wymaga dopisku, że własnej recenzji AI w projekcie wielkości PostgreSQL nie przeprowadziliśmy, oceniamy po źródłach.
Co dalej z Postgresem 19
Harmonogram na listopad wygląda rozsądnie. RC 2 na 12 listopada zbierze poprawki z kwartalnej aktualizacji, a tydzień później, jeśli nic się nie wysypie, wyjdzie PostgreSQL 19. Eisentraut zapewnia, że mimo cięć to będzie mocne wydanie: REPACK CONCURRENTLY bez blokowania tabel, logiczna replikacja sekwencji i podpowiadanie planera przez pg_plan_advice zostają, a po dodatkowej lustracji wydanie będzie bardzo solidne.
Największy efekt uboczny dotyczy wersji 20. Jeszcze w połowie roku Eisentraut przewidywał, że 20 wyjdzie wyłącznie z poprawkami. Teraz w kolejce stoi od ośmiu do dziesięciu funkcji przeniesionych z 19, a ich dojrzałość żartobliwie ocenia na osiemdziesiąt procent, bo do pełnej gotowości brakuje właśnie pozostałych osiemdziesięciu procent. Projekt rozważa też status eksperymentalny dla dużych funkcji, kommitowane by stopniowo dojrzewały w głównym drzewie zamiast wypadać tuż przed bramką.
FAQ
Kiedy ukaże się PostgreSQL 19?
Planowana data ogólnej dostępności to 19 listopada 2026, pod warunkiem że nie wyjdzie problem wymagający dodatkowej rundy. RC 2 ma pojawić się 12 listopada razem z kwartalną aktualizacją starszych wersji.
Dlaczego recenzje AI opóźniły wydanie bazy danych?
Bo znalazły więcej problemów, niż zespół zdołał zamknąć w pozostałym oknie czasowym. Około czterdziestu raportów o defektach, każdy wymaga nawet tylko trzech linijek poprawki, ale obsługa każdego ma stały narzut dyskusji i testów, a czasu brakuje. Część funkcji miała też wady architektoniczne nieusuwalne szybko w okresie bety.
Czy to wina pisania kodu przez AI, czyli vibe codingu?
Nie. Eisentraut pisze wprost, że dotknięte funkcje powstały dawno temu, zanim vibe coding był w ogóle możliwy. Recenzja kodu wspomagana modelami to narzędzie innego rodzaju niż generowanie kodu i to one zmieniły sytuację, nie sposób pisania.
Czy Postgres 19 będzie mniej stabilny przez te cięcia?
Zespół twierdzi odwrotnie. Problemowe funkcje wyleciały, w tym SQL/PGQ, a te, które zostały, przeszły dodatkową lustrację. Eisentraut obiecuje wydanie bardzo solidne po całym dodatkowym badaniu.
Co stanie się z odrzuconymi funkcjami?
Najpewniej wrócą w PostgreSQL 20 w 2027 roku, który zamiast planowanych wcześniej samych poprawek dostanie te funkcje z 19. Los SQL/PGQ pozostaje otwarty, funkcja wypadła także z gałęzi master.
Źródła
- The Register, „Postgres 19 delayed after AI reviewers find more bugs than humans can fix”, publikacja 16.10.2026, odczyt 17.10.2026 (curl z UA przeglądarki): https://www.theregister.com/databases/2026/10/16/postgres-19-delayed-after-ai-reviewers-find-more-bugs-than-humans-can-fix/5303471
- Peter Eisentraut, „The reverts will continue until morale improves”, blog, 9.10.2026, odczyt 17.10.2026 (curl z UA przeglądarki): https://peter.eisentraut.org/blog/2026/10/09/the-reverts-will-continue-until-morale-improves
- Robert Haas, mail „scary patch contest” na liście pgsql-hackers, 25.08.2026 16:48:25, odczyt 17.10.2026 (archiwum postgresql.org, curl z UA przeglądarki): https://www.postgresql.org/message-id/CA%2BTgmob9NY6m0YNFTQ4nFH2d0iC9SQRruDYxfndGKKzh8OC80w%40mail.gmail.com
- PostgreSQL Global Development Group, „PostgreSQL 19 RC 1 Released!”, ogłoszenie, 15.10.2026, odczyt 17.10.2026 (curl z UA przeglądarki; planowana GA 19 listopada 2026, RC 2 na 12 listopada): https://www.postgresql.org/about/news/postgresql-19-rc-1-released-3409/
- Joe Brockmeier, „PostgreSQL 19’s scary patch contest”, LWN.net, 10.09.2026, odczyt 17.10.2026 (curl z UA przeglądarki): https://lwn.net/Articles/1092003/
- Daty GA wersji głównych PostgreSQL 14.0 do 18.0 i tekst roadmapy, odczyt 17.10.2026 (strony /docs/release/X.0/ i /developer/roadmap/ na postgresql.org): https://www.postgresql.org/docs/release/
- Wątek Hacker News 50119991 przez API Algolii, odczyt 17.10.2026 (198 punktów, 77 komentarzy w chwili odczytu; utworzony 16.10): https://hn.algolia.com/api/v1/items/50119991