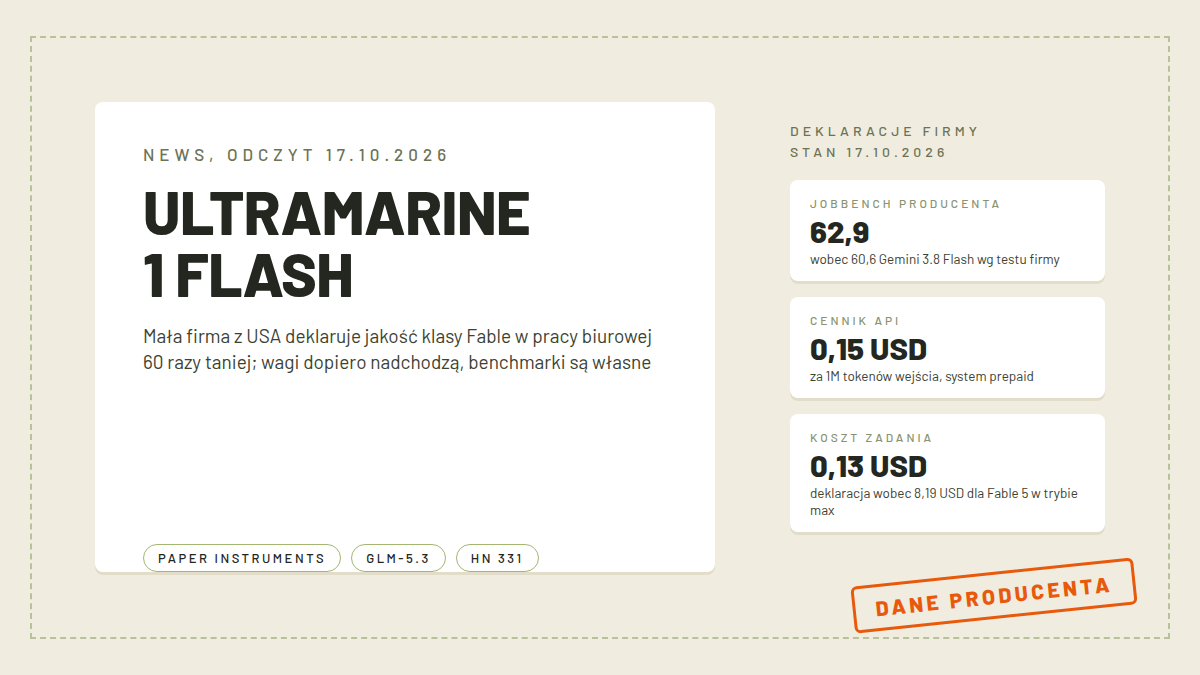
14 października firma Paper Instruments opublikowała raport techniczny Ultramarine 1 Flash, a dzień później wątek na Hacker News dobił do 331 punktów w odczycie z 17.10. Deklaracje brzmią jak z innej epoki cen: klasy Fable w pracy biurowej, czyli w finansach, prawie, konsultingu i operacjach, przy 60 razy niższej cenie niż Fable. Producent pisze to na stronie produktu wprost: Fable-class, 60x cheaper than Fable. To jego deklaracja, nie wynik niezależnego testu.
Ultramarine 1 Flash nie powstał od zera. To model agentowy zbudowany na otwartym GLM-5.3 Flash od Z.ai, dostrajany metodami uczenia ze wzmocnieniem do zadań biurowych: arkusze, prezentacje, dokumenty Word i praca w żywych systemach firmowych typu ERP. API już działa w modelu prepaid, wagi bez podanej daty. O samej firmie wiadomo niewiele.
- Kto stoi za Paper Instruments
- Co obiecuje producent i co pokazują jego liczby
- Jak ten model powstał
- Cennik API i dostępność
- Reakcje na Hacker News
- Co to zmienia w wyścigu tanich modeli
- Czego nie wiemy
- Najczęstsze pytania
Kto stoi za Paper Instruments
Paper Instruments, Inc. to firma z USA, tyle ile można ustalić bez spekulacji. Na stronach nie ma ani jednego nazwiska, jest adres [email protected] i rekrutacja research engineers z dopiskiem, że firma buduje open source. SOC 2 Type II w stopce oznacza, że ktoś przeszedł audyt kontroli bezpieczeństwa. O finansowaniu, wielkości zespołu i konkretnych ludziach nie podano nic.
Więcej mówi organizacja na GitHubie, założona 13 marca 2025 i licząca 19 publicznych repozytoriów: harness treningowy feather-train na licencji MIT, biblioteka rubric do oceny rubrykowej, forki bibliotek biurowych paper-docx, paper-pptx i paper-xlsx. Historia publikacji pokazuje wcześniejszy rozdział: w marcu 2026 wyszedł model medyczny Kos-1 Lite, w maju Kos-1 Experimental, RL na bazie Kimi K2.5. Dopiero potem przyszła praca biurowa: we wrześniu pakiet Paper Office, w październiku Ultramarine.
Co obiecuje producent i co pokazują jego liczby
Sześć benchmarków z tabeli to mieszanka testów zewnętrznych i własnych. PI Knowledge Work jest wewnętrznym zestawem producenta, a DiligenceBench stworzyła i opublikowała w lipcu ta sama firma. Wyniki pochodzą od producenta, niezależnej weryfikacji brak.
| Benchmark | Ultramarine 1 Flash | Najlepszy rywal, wynik |
|---|---|---|
| JobBench | 62,9 | Gemini 3.8 Flash, 60,6 (+2,3 pkt) |
| PI Knowledge Work | 59,3 | Fable 5, 57,8 (+1,5 pkt) |
| FrontierFinance | 53,3 | GLM-5.3 Flash, 50,7 (+2,6 pkt) |
| AutomationBench | 50,2 | DeepSeek V4.1 Flash, 51,3 (-1,1 pkt) |
| DiligenceBench | 50,6 | Gemini 3.8 Flash, 53,1 (-2,5 pkt) |
| APEX-Agents 1.1 | 57,0 | Gemini 3.8 Flash, 64,3 (-7,3 pkt) |
Producent pokazuje też trzy rankingi, w których Ultramarine nie jest pierwszy. Przypisy raportu mówią sporo o metodzie: JobBench liczono na harnesie OpenCode 1.14.18 z sędzią Grok 4.3 na 65 zadaniach, wewnętrzny PI Knowledge Work oceniał GPT-5.6 Terra w oknie 262 144 tokenów, a własny DiligenceBench GPT-5.5. Wyniki konkurentów pochodzą częściowo z leaderboardów, częściowo z własnych przebiegów Paper Instruments, a koszty policzono po oficjalnych cenach API z października 2026. W FrontierFinance producent podaje też wariant bez 300-sekundowego budżetu narzędziowego, gdzie Ultramarine idzie w górę do 58,1, ale to wciąż jego własny pomiar.
Najciekawsza liczba dotyka portfela. Na wewnętrznym zestawie Ultramarine kosztuje 0,13 USD za zadanie, Fable 5 w trybie max reasoning 8,19 USD, GPT-5.6 Sol 2,09 USD. Stąd tytułowe 60 razy: 8,19 podzielone przez 0,13 daje około 63, więc deklaracja jest nawet konserwatywna, o ile przyjąć pomiar producenta. Opus 5.5 i GPT-6 Sol w wersjach max kosztują odpowiednio 6,96 USD i 1,26 USD za zadanie i wygrywają o mniej niż trzy punkty. Producent deklaruje korelację wewnętrznego testu z indeksem Artificial Analysis na poziomie r = 0,81 oraz o 6,5% mniejszy apetyt na tokeny: 30,5 mln wobec 32,7 mln u bazy.
Jest jednak drugi koniec rachunku. Dwa referencyjne benchmarki kodowania wychodzą dla Ultramarine odrobinę niżej niż dla bazy: Terminal-Bench 2.1 daje 83,2 wobec 84,3 u GLM-5.3 Flash, a DeepSWE 61,5 wobec 63,4. Model był trenowany pod biuro i to widać.
Jak ten model powstał
Raport techniczny opisuje dość oszczędną procedurę, co przy obiecywanych wynikach mówi samo za siebie. Baza to otwarty GLM-5.3 Flash, na którym położono trening RL z adapterami LoRA rzędu 64, z funkcją celu CISPO, optymalizatorem AdamW i kontekstem 131 072 tokenów. Trenowano w maksymalnie 250 turach agenta, w sandboxach E2B z osobnymi kontenerami na usługi i ocenę, harnesem Feather o narzędziach read, edit, write, grep, glob i bash. Rozmiar modelu producent nie podaje, poza tym, że dziedziczy go po bazie.
Ciekawsza jest decyzja o danych. Zespół odrzucił ślady produkcyjne i zadania pisane przez ekspertów na rzecz curriculum w pełni syntetycznego: cztery domeny, 19 obszarów praktyki, 88 typów środowisk, od sali transakcyjnej M&A po program SOX, rozpisane na pipeline’y generujące zadania z rubrykami. Materiały pochodzą z plików SEC EDGAR, publicznych stron i dokumentów generowanych, każde środowisko ma prywatną kartę poprawnych odpowiedzi, a filtry polują na przecieki odpowiedzi i reward hacking.
Cennik API i dostępność
API działa w trybie prepaid. Z dokumentacji billingowej (odczyt 17.10): 0,15 USD za milion tokenów wejścia, 0,03 USD za wejście keszowane i 0,50 USD za wyjście z reasoningiem wliczonym. Producent deklaruje na stronie produktu, że stawki trzymają poziom GLM-5.3 Flash. Aktualne stawki zwraca GET /v1/pricing bez autoryzacji, a system przed każdym zapytaniem rezerwuje maksymalny koszt, więc bez ustawionego max_completion_tokens może zabraknąć środków na saldzie.
Dostęp bywa różny: jeden z komentujących na HN po zapisie czekał długo, inny dostał klucz następnego dnia. Wagi to osobna historia: na stronie wisi plakietka Model weights coming soon, przycisk do Hugging Face jest w stanie wyłączonym, licencji nie nazwano, daty nie podano.
Reakcje na Hacker News
Wątek na Hacker News, wystawiony 15 października, zebrał 101 komentarzy w odczycie z 17.10 i pokazał obie strony sporu. Najczęstszy zarzut dotyka wyboru porównań: jeden z komentujących wytknął producentowi, że „choose to compare Ultramarine only to models that it’s better than on every metric”, a modele typu Fable 5.1 czy GPT-6 Astra wróciły na wykres kosztowy dopiero tam, gdzie ich wyższa cena grała na korzyść nowego modelu. Status samego modelu też wywołał spór: „Lol this is not Fable-class. This is Luna class. Look at the graphs”, ocenił inny, wskazując niższe modele z rodziny GPT-6. Ktoś nazwał produkt kosmetyką na GLM-5.3 Flash z kilkoma trikami kontekstowymi, inni ripostowali, że skoro deklarowany trening RL jest prawdziwy, to nie jest to trywialna robota.
Głosy praktyczne też padły. Jeden z użytkowników porównał model na własnym zadaniu z Haiku, GPT-mini i DeepSeek v4 i stwierdził: „Price/performance is as advertised in my limited testing”. Inni zauważyli, że fala drobnych dostrojeń otwartych baz pod niszę to już trend i wskazali wariant Qwen od Thomson Reutersa do analizy dokumentów jako przykład, który się broni. Część czeka na wagi w kwantyzacjach, bo bez nich lokalny montaż nie ruszy. Z osobna brzmi głos biznesowy: dla firmy bez działu technicznego wybór harnesa i wdrożenie modelu API to koszt, którego subskrypcja gotowego asystenta nie ma, nawet jak jest droższa.
Co to zmienia w wyścigu tanich modeli
Tabela Paper Instruments czyta się jak przekrój obecnej czołówki tanich modeli: DeepSeek V4.1 Flash, GLM-5.3 Flash i Kimi K3 stoją w niej obok marek z wielkich laboratoriów, a otwartym modelom AI przyglądaliśmy się już szerzej. Nowość nie leży w samym dostrojeniu, tylko w kierunku: wszyscy strzelają w kodowanie, bo tam da się oceniać automatycznie, a Ultramarine idzie w zadania, których nie da się sprawdzić parserem, i buduje wokół tego cały łańcuch od syntetycznych środowisk po biblioteki biurowe. Jeśli deklaracje choć w połowie wytrzymają kontakt z klientami, rachunek ekonomiczny używania AI w pracy biurowej przestanie być oczywisty, bo mocne zadania agentowe po 0,13 USD pozwalają na wielokrotne podejścia, których drogi model nie płaci.
Ale uwaga na kategorię. To nie jest chatbot do rozmowy, tylko model agentowy, który pracuje w harnesie na plikach i usługach, o czym pisaliśmy przy okazji agentów AI. Dla pojedynczego użytkownika pytanie brzmi więc nie tyle, czy Ultramarine jest 60 razy tańszy, ile czy jego przypadek użycia w ogóle dochodzi do płacenia za API per zadanie, czy raczej ryczałtu za wygodę. Tę drugą drogę rozkładaliśmy przy okazji wyliczanki, czy warto płacić za ChatGPT, a rynek tanich baz opisywał wpis o DeepSeek V4.
Czego nie wiemy
Listę niewiadomych otwiera licencja wag, bo bez niej open oznacza tylko obietnicę. Nie wiadomo, kiedy wagi wjadą, ani w jakich kwantyzacjach. Nie podano rozmiaru modelu, jedynie bazę, z której wyrósł. Nie ma żadnego niezależnego przeliczenia benchmarków: rankingi pochodzą od firmy, która ma interes w ich kształcie, a dwa z sześciu testów, w tym ten stojący za ceną per zadanie, są jej własnością. Sędziami ocen są inne modele językowe, co otwiera pole do dyskusji o kalibracji. Wreszcie firma: brak nazwisk, brak informacji o finansowaniu, jedyny trop to repozytoria na GitHubie. Odpowiedzi przyniosą dopiero wagi i pierwsze niezależne odtworzenia wyników.
Najczęstsze pytania
Ile kosztuje Ultramarine 1 Flash?
API liczy 0,15 USD za milion tokenów wejścia, 0,03 USD za wejście keszowane i 0,50 USD za wyjście, w systemie prepaid. Producent wylicza 0,13 USD na zadanie na swoim benchmarku. Planu darmowego nie podano.
Czy wagi Ultramarine 1 Flash można już pobrać?
Nie. Na stronie wisi komunikat Model weights coming soon bez daty, przycisk do Hugging Face jest wyłączony, licencji nie nazwano.
Co znaczy deklaracja klasy Fable?
To określenie producenta z jego własnych benchmarków biurowych. Komentujący na Hacker News odpowiadali, że z wykresów wynika raczej poziom modeli typu GPT-6 Luna, a niezależna weryfikacja na razie nie istnieje.
Czy Ultramarine 1 Flash nadaje się do kodowania?
Słabiej niż jego baza. Terminal-Bench 2.1 daje 83,2 wobec 84,3 u GLM-5.3 Flash, DeepSWE 61,5 wobec 63,4. Model był trenowany pod pracę biurową, nie pod repozytoria.
Czym różni się od GLM-5.3 Flash, na którym stoi?
To trening RL na tej bazie, z adapterami LoRA rzędu 64. Producent deklaruje średnio 4,1 punktu więcej na sześciu benchmarkach biurowych i o 6,5% mniej tokenów generowanych, przy lekko niższych wynikach w kodowaniu.
Źródła
- Strona produktu Ultramarine 1 Flash, benchmarki, cennik i komunikat o wagach, odczyt: https://www.paperinstruments.com/ultramarine
- Raport techniczny Ultramarine 1 Flash: Scaling Non-Verifiable RL z 14.10.2026, przypisy do ewaluacji i tabela treningu, odczyt: https://www.paperinstruments.com/blog/ultramarine
- Dokumentacja Ultramarine API, strona Billing ze stawkami i zasadami prepaid, odczyt: https://docs.paperinstruments.com/docs/ultramarine/billing
- Wątek Ultramarine 1 Flash na Hacker News z 15.10.2026, 331 punktów w odczycie 17.10, komentarze zacytowane w tekście, odczyt: https://news.ycombinator.com/item?id=50106747
- Organizacja Paper Instruments na GitHubie, daty utworzenia i repozytoria, odczyt: https://github.com/paper-instruments
- Blog Paper Instruments z historią wydań od Kos-1 Lite do Ultramarine, odczyt: https://www.paperinstruments.com/blog
- Autouzupełnianie Google po polsku dla fraz dotyczących tanich modeli, odczyt: https://suggestqueries.google.com/complete/search?client=firefox&hl=pl&q=tanie+modele+ai