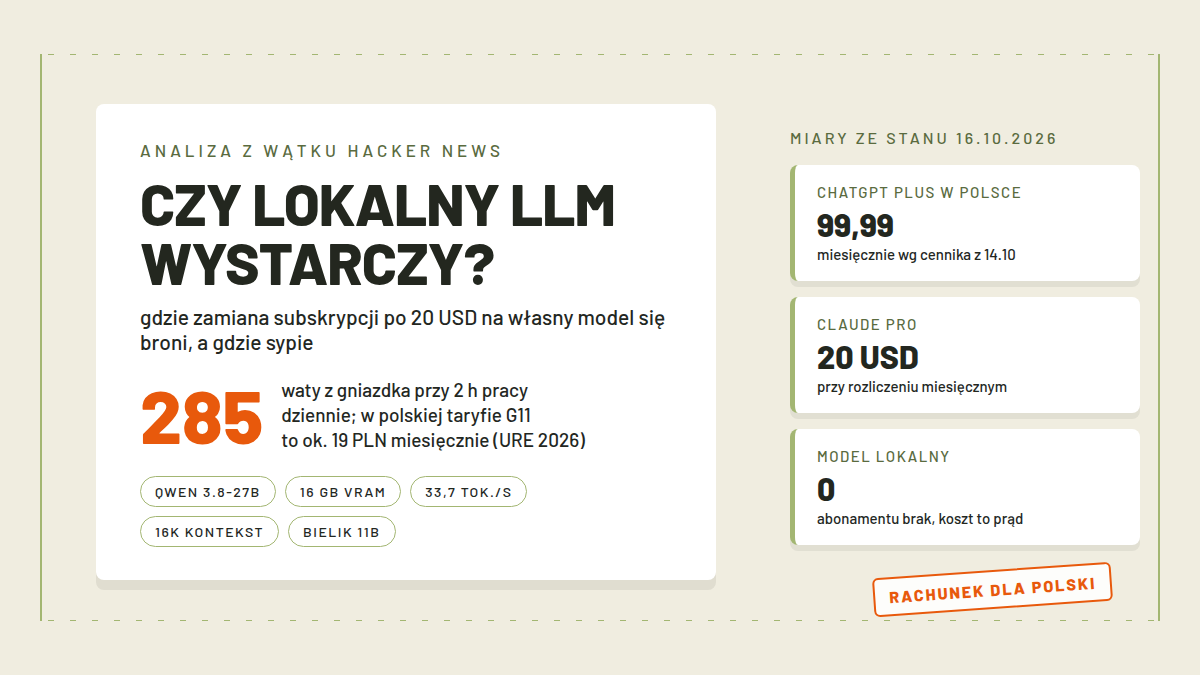
6 października Abhinav Raj z XDA-Developers opublikował tekst, którego tytuł w przekładzie brzmi: „Nie płacę 20 dolarów za ChatGPT ani za Claude, bo darmowy lokalny LLM robi wszystko, czego potrzebuję”. Raj wywalił ChatGPT Plus i Claude Pro po 20 dolarach miesięcznie, pobrał model Qwen 3.8-27B i odpalił go serwerem llama.cpp na własnym komputerze z kartą RTX 4070 Ti Super. Wątek na Hacker News urosł do 52 punktów i 22 komentarzy (stan na 16.10), a komentujący rozjechali się na dwa obozy. Jedni wyliczają, że karta za 1200 dolarów to 60 miesięcy subskrypcji, drudzy piszą, że po latach pracy z licznikami i limitami nie zamierzają wracać.
Rozkładamy tezę autora na części i przeliczamy ją na polskie warunki, w złotówkach, z taryfami prądu zatwierdzonymi przez URE na 2026 rok. Lokalne modele testowaliśmy wielokrotnie, ale porównania z płatnym czatem na własnym sprzęcie nie robiliśmy, więc tam, gdzie kończą się nasze pomiary, opieramy się na źródłach i mówimy o tym wprost. Jeśli dopiero zaczynasz, podstawy modeli na własnym sprzęcie mamy zebrane na hubie lokalne AI, a tu idziemy od razu w rachunki.
- Najważniejsze informacje
- Co dokładnie twierdzi autor z XDA
- Kiedy lokalny model realnie zastępuje subskrypcję
- Gdzie ta teza się sypie
- Rachunek dla Polski
- Praktyczna granica: kiedy lokalny wystarcza, a kiedy nie
- Najczęstsze pytania
Najważniejsze informacje
Ściągawka z najważniejszych liczb, wszystkie z datami odczytów.
| Co | Szczegóły |
|---|---|
| ChatGPT w Polsce | Free 0 zł, Go 34,99 zł, Plus 99,99 zł, Pro od 439 zł miesięcznie (cennik chatgpt.com, odczyt 14.10.2026) |
| Claude | Pro 17 USD przy rozliczeniu rocznym albo 20 USD przy miesięcznym, Max 100/200 USD (cennik claude.com, odczyt 13.10.2026) |
| Gemini | AI Plus 46,99 zł, AI Pro 97,99 zł miesięcznie, planu Ultra w Polsce brak (lista Google One, odczyt 13.10.2026) |
| Sprzęt pod Qwen 3.8-27B | karta z 16 GB VRAM, autor pracował na RTX 4070 Ti Super z serwerem llama.cpp na localhost |
| Pobieranie | wariant UD-IQ4_XS od Unsloth, 13,3 GB wg autora, w repozytorium Hugging Face ta sama waga widnieje jako 14,25 GB (odczyt 16.10.2026) |
| Sprzęt pod Stratę + Qwen 3.8 Flash Next | min. 12 GB VRAM i 32 GB RAM, pobranie ok. 70 GB (nasz test z 10.2026) |
| Prąd | 285 W przez 2 h dziennie to ok. 17,1 kWh miesięcznie, czyli ok. 19 zł w taryfie G11 albo ok. 10 zł w G12 (taryfy URE na 2026) |
| Wydajność | 33,7 tokenu na sekundę i okno kontekstu 16 tys. tokenów (pomiar autora, 6.10.2026) |
Co dokładnie twierdzi autor z XDA
ChatGPT Plus i Claude Pro zamienił na jeden model na własnym sprzęcie. Qwen 3.8-27B w wariancie UD-IQ4_XS od Unsloth waży według niego 13,3 GB (w repozytorium na Hugging Face ta sama waga widnieje jako 14,25 GB, to różnica jednostek, odczyt 16.10) i mieści się w 16 GB pamięci karty RTX 4070 Ti Super. Serwer llama.cpp postawiony na localhost generuje 33,7 tokenu na sekundę, a okno kontekstu autor ustawił na 16 tys. tokenów, choć karta modelu deklaruje natywne wsparcie dla 262 tys.
Z listy zastąpionych zadań wymienia poprawianie maili, streszczenia i analizę nastrojów z forów produktowych. W teście model napisał działającą grę Snake w Pygame za jednym podejściem, a chaotycznego maila o cenach podzespołów, pełnego tuzina liczb, przełożył na czytelną tabelę. Argumentem jest i prywatność, nic nie opuszcza komputera, półgotowe aplikacje oraz dane z benchmarków zostają na dysku.
Z Claude jest szczerszy. Przyznaje, że modele frontowe Anthropica w kodowaniu są lepsze. Jego zdaniem przewaga topnieje w codziennej pracy iteracyjnej, bo pięciogodzinne limity łamią tempo, po wyczerpaniu przydziału siadasz i czekasz do resetu. Lokalnie ściany nie ma, tygodniowego limitu też nie, a model może iterować całą noc. Jedynym kosztem jest pobór 285 W z gniazdka. I uczciwe zastrzeżenie samego autora: „Qwen 3.8-27B doesn’t exactly top the benchmark charts”, czyli jego model nie pcha się na szczyty benchmarków. Rodzinę Gemma docenia z kolei na laptopie z 16 GB RAM, o czym pisze w drugim tekście XDA.
Kiedy lokalny model realnie zastępuje subskrypcję
Najbezpieczniejszy teren to powtarzalne zadania niskiej wagi. Poprawiony mail albo streszczenie długiego dokumentu, z tych obszarów autor zrezygnował z chmury bez żalu, a jego przykłady ze Snake’em i przetworzonym mailem wyglądają przekonująco. W takiej pracy model nie musi być czołówką benchmarków, wystarczy, że odpowiada bez licznika.
Drugą kategorią są dane, których nie chcesz nikomu oddawać. Komentujący na HN wymieniają formularze podatkowe, umowy i dokumenty prawne jako powód utrzymania modelu lokalnie, autor dokłada półgotowe aplikacje i wyniki benchmarków. Żaden plan chmurowy tej właściwości nie oferuje, bo o prywatności w chmurze decyduje regulamin, a nie fizyka.
Trzeci jest najmniej oczywisty, objętość. Bez licznika promptów i bez rachunku nadwyżkowego można zostawić model iterującego na noc, co autor opisuje jako powrót do spokojnego tempa pracy nad kodem. Jeden z komentujących dodał, że karta i tak stoi pod biurkiem do gier, więc dodatkowy koszt sprowadza się do prądu.
W kodzie sytuacja jest ciekawsza, bo lokalne modele od frontu dzieli już mniej, niż sugeruje debata. Testowaliśmy Stratę z Qwen 3.8 Flash Next, eksperymentalnym podglądem czwartej generacji rodziny. W benchmarku producenta SWE-bench Pro model zdobywa 62,5 punktu, wobec 61,7 gęstego Qwen 3.8 27B. To wciąż nie jest poziom subskrypcji za sto złotych, ale różnica względem modelu z tekstu XDA robi się kosmetyczna.
Gdzie ta teza się sypie
Komentujący na HN rozebrali rachunek ekonomiczny. Karta za 1200 dolarów to 60 miesięcy subskrypcji po 20 dolarach, więc inwestycja zwraca się dopiero po pięciu latach, o ile karta służy wyłącznie do modeli. W USA, gdzie prąd kosztuje 30-40 centów za kWh, miesięczne konto za energię potrafi przebić cenę Plusa. Jeden z komentarzy sprowadza całość do sarkazmu: „wydałem 1100 dolarów na kartę, żeby oszczędzać 20 miesięcznie na modelu średniej inteligencji z 33 tokenami na sekundę i 16K kontekstu”. Inny jest złośliwiej i pisze, że skoro płaciłeś tylko 20 dolarów miesięcznie, to prawie wcale nie używałeś.
Drugi zarzut dotyczy jakości. „Na subie za 20 dolarów mam model klasy Astra, nieporównywalne z chińskim modelem na jednej karcie”, pisze komentujący. Zarzut trafia, skoro autor sam przyznaje, że w kodowaniu modele Anthropica są lepsze, a jego Qwen benchmarków nie wygrywa. Sprzęt dodaje swoje, komentujący z M5 Pro i 48 GB RAM mierzy 10 tokenów na sekundę na tym samym Qwen 3.8 27B, podczas gdy RTX 5900 deklaruje około 200. „Ideologiczne nachylenie do self-hostingu zaciemnia osąd”, zauważa jeszcze jeden z głosów w wątku. Wynik zależy więc od tego, co akurat stoi pod biurkiem.
Rachunek dla Polski
Argument o 30-40 centach za kWh u nas nie działa, bo polskie taryfy wyglądają inaczej. Według zestawienia WysokiegoNapięcia z 18.12.2025, dla taryf zatwierdzonych przez URE na 2026 rok, całodobowa G11 z dystrybucją kosztuje około 1,09-1,10 zł za kWh brutto, a dwustrefowa G12 w tanich godzinach około 0,61 zł.
Kartę autora przeliczyliśmy od zera. Pobór 285 W to 0,285 kW, więc dwie godziny pracy dziennie przez 30 dni dają 17,1 kWh, czyli około 19 zł miesięcznie w G11 albo około 10 zł w G12, jeśli wpadasz w tanie godziny. Nocne iteracje po 8 godzin to już 68,4 kWh, czyli około 75 zł w G11 albo około 42 zł w G12.
Z tych liczb wychodzi, że prąd sam w sobie nie przesądza sporu o lokalny LLM w Polsce. Nawet agresywny scenariusz nocny w G11 kosztuje mniej niż ChatGPT Plus za 99,99 zł, a w G12 mniej niż połowę. Prawdziwy koszt siedzi w sprzęcie i tu wyliczenie z HN o 60 miesiącach pozostaje w mocy, chyba że karta już stoi pod biurkiem, wtedy rachunek sprowadza się do tabeli powyżej.
Praktyczna granica: kiedy lokalny wystarcza, a kiedy nie
Granica przebiega mniej więcej po pamięci karty i po typie zadań. Masz 12-16 GB VRAM i pytania z gatunku maili czy streszczeń, lokalny model pokryje to bez liczników, a start ułatwia nasza instrukcja Ollamy po polsku.
Bez karty graficznej zostają drogi pośrednie. Czat DeepSeek jest darmowy, a jego API zaczyna się od 0,30 USD za milion tokenów w wariancie Flash w godzinach szczytu, co opisujemy w tekście o DeepSeeku. Dnem tego spektrum jest AI w przeglądarce, które testowaliśmy we wrześniu. Wyszły 2 tokeny na sekundę i halucynacje po polsku na najmniejszych wagach, doświadczenie, po którym wraca się do chmury albo po porządny sprzęt.
Pytanie o najlepszy lokalny LLM do programowania zostawiamy otwartym, bo uczciwa odpowiedź brzmi dziś „zależy od progu bólu”. Jeden z komentujących ujął to tak: przesiądę się na stałe, gdy lokalnie dostanę klasę Opusa z ponad 100 tokenami na sekundę i kontekstem 1M. Do tej pory mix wygląda rozsądnie. Lokalny model bierze na siebie prywatne dane i nocne iteracje, a subskrypcja wchodzi tam, gdzie naprawdę potrzebna jest jakość frontu.
Najczęstsze pytania
Czy warto płacić za ChatGPT Plus?
Zależy, do czego używasz go na co dzień. Plus kosztuje w Polsce 99,99 zł miesięcznie (cennik z 14.10.2026), a darmowy plan z GPT-6 Luna spokojnie obsługuje maile i streszczenia. Jeśli natomiast pracujesz na długich dokumentach, piszesz dużo kodu i zależy ci na najmocniejszym modelu w danym momencie, różnica względem modeli 27B jest wyraźna i subskrypcja się broni.
Jaki lokalny LLM wybrać na start?
Na karcie z 16 GB VRAM naturalnym punktem wyjścia jest Qwen 3.8-27B w wariancie UD-IQ4_XS, czyli dokładnie zestaw autora z XDA. Do zadań po polsku polecamy sprawdzonego przez nas Bielika 11B v3.0 Instruct, model SpeakLeash i ACK Cyfronet AGH na licencji Apache 2.0, którego pliki GGUF zaczynają się od 4,5 GB i który daje radę nawet na samym procesorze. Nie musisz wybierać na stałe, każdy ma inny teren.
Czy lokalny LLM nadaje się do programowania?
Do prostych skryptów i pojedynczych plików tak, autor XDA dostał działającą grę Snake za jednym podejściem, a Strata z Qwen 3.8 Flash Next ma 62,5 punktu w SWE-bench Pro wg benchmarku producenta. Przy dużych refactorach i pracy wieloplikowej autor sam przyznaje wyższość modeli Anthropica, a pięciogodzinne limity chmury są wtedy jedynym realnym powodem, by mimo wszystko próbować lokalnie.
Ile VRAM potrzeba do lokalnego modelu AI?
Dla modelu 27B w 4-bitowej kwantyzacji wygodnym minimum jest 16 GB, bo sam plik waży ponad 13 GB, a do tego dochodzi pamięć na kontekst. Komentujący na HN pokazują węższe konfiguracje, wariant MoE o rozmiarze ok. 20 GB uruchomiony na 8 GB VRAM z dorzuceniem 20 GB RAM albo ok. 20 GB w 12 GB VRAM z kontekstem 64K. Dla dużego modelu MoE, jak testowana przez nas Strata, realne minimum to 12 GB VRAM i 32 GB RAM plus pobranie ok. 70 GB.
Ile prądu zużywa lokalny model AI?
Karta autora z XDA ciągnie 285 W podczas pracy. W polskich realiach daje to 17,1 kWh miesięcznie przy dwóch godzinach dziennie, czyli około 19 zł w taryfie G11 albo około 10 zł w G12 w tanich godzinach, a nocne iteracje po 8 godzin to odpowiednio około 75 zł i 42 zł (taryfy zatwierdzone przez URE na 2026, wg WysokiegoNapięcia). Dla porównania, ChatGPT Plus kosztuje 99,99 zł.
Źródła
- Tekst XDA-Developers Abhinava Raja o rezygnacji z subskrypcji ChatGPT i Claude, odczyt 16.10.2026: https://www.xda-developers.com/im-not-paying-20-for-chatgpt-claude-or-gemini-because-a-free-local-llm-does-everything-i-need/
- Wątek na Hacker News pod tekstem XDA (52 punkty, 22 komentarze), odczyt 16.10.2026: https://news.ycombinator.com/item?id=49996713
- Karta modelu unsloth/Qwen3.8-27B-GGUF na Hugging Face, wariant UD-IQ4_XS i plik 14,25 GB, odczyt 16.10.2026: https://huggingface.co/unsloth/Qwen3.8-27B-GGUF
- Cennik ChatGPT z cenami w złotówkach, odczyt 14.10.2026: https://chatgpt.com/pricing
- Cennik Claude, odczyt 13.10.2026: https://claude.com/pricing
- Zestawienie taryf prądu na 2026 zatwierdzonych przez URE, WysokieNapiecie.pl, publikacja 18.12.2025: https://wysokienapiecie.pl/115767-ceny-pradu-na-2026-ile-lacznie-zaplacimy-kto-odczuje-obnizke/
- Repozytorium llama.cpp na GitHubie: https://github.com/ggml-org/llama.cpp
- Nasz test Straty i Qwen 3.8 Flash Next z pomiarami i SWE-bench Pro, publikacja 10.2026: https://technetblog.pl/2026/10/lokalne-ai-na-komputerze/
- Nasz test Bielika 11B v3.0 na zwykłym procesorze, publikacja 10.2026: https://technetblog.pl/2026/10/bielik-ai/
- Nasz test AI w przeglądarce, publikacja 09.2026: https://technetblog.pl/2026/09/ai-w-przegladarce/
- Nasza instrukcja Ollama po polsku, publikacja 10.2026: https://technetblog.pl/2026/10/ollama-po-polsku/
- Nasz tekst DeepSeek po polsku ze stawkami API, publikacja 09.2026: https://technetblog.pl/2026/09/deepseek-po-polsku/
- Nasz tekst ChatGPT za darmo o planie Free, publikacja 10.2026: https://technetblog.pl/2026/10/chatgpt-za-darmo/
- Nasz tekst o Gemini 4 Argon z cenami planów Google One w Polsce, odczyt cen 13.10.2026: https://technetblog.pl/2026/10/gemini-4-argon/
- Hub lokalne AI: https://technetblog.pl/lokalne-ai/