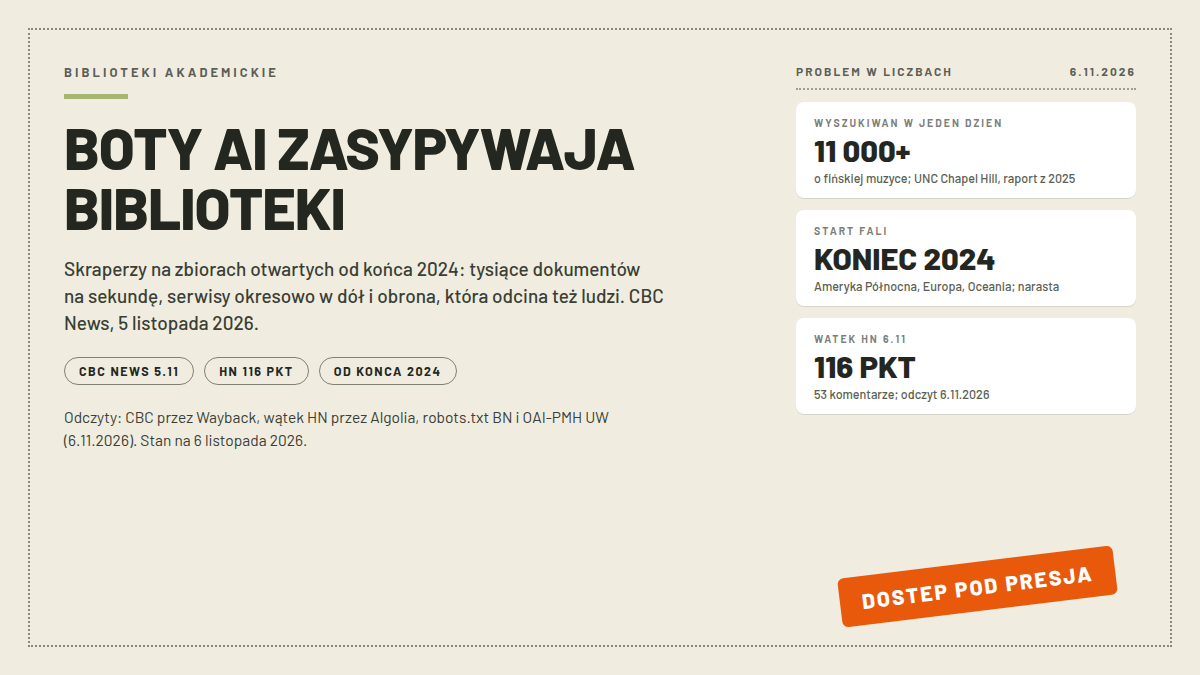
Katalog biblioteki University of North Carolina w Chapel Hill bywał okresowo zamykany dla studentów, pracowników nauki i administracji, bo w jednym dniu odebrał ponad 11 tysięcy wyszukiwań o fińskiej muzyce z tysięcy różnych adresów internetowych. Uczelnia podała te liczby w 2025 roku, a CBC News 5 listopada 2026 opisało całą falę: biblioteki akademickie w Ameryce Północnej, Europie i Oceanii od końca 2024 odpierają skraperów danych, którzy potrafią żądać tysięcy dokumentów na sekundę i ściągać je w każdym dostępnym formacie. Instytucje sięgają po CAPTCHA, logowanie i blokady adresów, czyli środki, które odcinają też zwykłych czytelników. Ten tekst rozdziela fakty z artykułu CBC, głosy wątku Hacker News i sprawdzone dziś na żywo ślady po stronie polskich bibliotek.
- Najważniejsze informacje
- Co dokładnie opisało CBC
- Dobre boty, złe boty i kanał, który istnieje legalnie
- Co mówi dyskusja Hacker News
- Środki obronne i ich cena
- Co z tego wynika dla polskich bibliotek
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Przykład UNC Chapel Hill | ponad 11 000 wyszukiwań o fińskiej muzyce w jeden dzień, z tysięcy różnych adresów; katalog okresowo odcinał studentów i pracowników (raport z 2025, za CBC 5.11.2026) |
| Skala techniczna | skraperzy potrafią żądać tysięcy dokumentów na sekundę i pobierać je w każdym dostępnym formacie (CBC, 5.11.2026) |
| Kiedy się zaczęło | zgłoszenia od końca 2024 z Ameryki Północnej, Europy i Oceanii; eksperci mówią CBC, że problem narasta |
| Kto stoi za botami | firmy AI i podmioty trzecie; dane często zasilają duże modele, CBC wymienia Claude, Gemini i ChatGPT |
| Dlaczego akurat biblioteki | treści sprawdzone, wartościowe i zwykle bez paywalli oraz bez logowania |
| Deklaracja firm | Anthropic, OpenAI, Google i Microsoft wyraziły w ostatnim tygodniu października 2026 wsparcie dla jednego sygnału opt-out w robots.txt; zgodność dobrowolna, podmioty trzecie poza porozumieniem |
| Polska | brak komunikatów POLONA, BN, FBC i NUKAT w odczytach 6.11.2026; kanał OAI-PMH repozytorium UW odpowiada na żywo |
Co dokładnie opisało CBC
Tekst Kevina Maimanna wyszedł 5 listopada 2026 o 4:00 czasu wschodnioamerykańskiego. Obraz jest tam twardy: całe kolekcje znika z sieci, bo serwery przestają wyrabiać się ze strumieniem żądań. Jill Strykowski, prowadząca katalogowanie i dokumenty rządowe na San Jose State University, opisuje to tak: „Stoją tam w internecie i bombardują nas próbami wgrzebania się w jak najwięcej materiału” (oryginał: „They’re just out there on the internet, just bombarding us with trying to grab up as much material as possible”). W jej ocenie boty sprawiają „niesamowitą ilość pracy i problemów każdej instytucji, która cyfryzuje zbiory, i każdej, która próbuje otwarcie udostępniać informacje”.
Boty te są używane przez firmy AI oraz podmioty trzecie, a dane najczęściej trafiają pod duże modele językowe; CBC wymienia z nazwy Claude, Gemini i ChatGPT. Cel jest dobierany logicznie: biblioteki, muzea i inne instytucje dziedzictwa mają treści sprawdzone i zwykle nie schowane za paywallem ani za kontem. Wg CBC fala takich zgłoszeń zaczęła się pod koniec 2024 roku na trzech kontynentach, a pytani eksperci mówią, że problem wciąż narasta.
Dean Seeman, dyrektor ds. kolekcji i infrastruktury cyfrowej w bibliotekach University of Victoria, opisuje czarne sceny: bywa, że ruch botów „powoduje, że serwisy całkowicie padają na jakiś czas”. Te przerwy nazwał „real problem” dla dostępu publicznego. Peter Lewis, kanadyjska katedra badawcza ds. godnej zaufania AI na Ontario Tech University, ujmuje sprawę najciężej: zwykli użytkownicy konkurują dziś o dostęp do biblioteki z „nieskończonym ruchem z farm botów”. Duże firmy prywatne korzystają wg niego z instytucji służących wspólnemu dobru w sposób „bardzo ekstraktywny”, zakładają, że dane są darmowe, a potem sprzedają komercyjne modele tym samym ludziom, którzy do tej pory brali je bezpłatnie.
Dobre boty, złe boty i kanał, który istnieje legalnie
Crawler obchodzi strony po linkach i z założenia respektuje plik robots.txt, czyli dobrowolną deklarację właściciela o tym, czego pobierać nie wolno; skrapowanie danych to masowe pobieranie treści bez liczenia się z tą deklaracją. Harvestery OAI-PMH działają odwrotnie: biblioteka sama wystawia metadane na uzgodnionym kanale, a deklaracja robots.txt nie ma mocy prawnej, więc cała siła tego pliku zależy od dobrej woli pobierającego; szeroko o blokadach tego typu piszemy w tekście o serwisach blokujących agentów AI, a o drodze danych do modelu w tekście jak AI się uczy.
Eric Hellman, szef Project Gutenberg, nazwał w blogu z 2025 roku te boty źle zaprogramowanymi „potwornościami” („monstrosities”), które „niszczą otwarty dostęp” do sieci; w komentarzu dla CBC 5 listopada mówi, że od tamtej pory „wszystko się pogorszyło”. Wg niego wyszukiwarki takie jak Google czy Internet Archive trzymają się robots.txt, a skraperzy AI ignorują go i potrafią żądać tysięcy dokumentów na sekundę, pobierając każdy dostępny format. Stara metoda, czyli blokowanie adresów IP, przestała działać, bo jedna firma albo farma botów może pracować z tysięcy adresów naraz.
Project Gutenberg sam udostępnia jednym kliknięciem całą bibliotekę książek z domeny publicznej, „ale boty są za głupie, żeby z tego skorzystać” („the bots are too stupid to use it”), jak mówi Michael Weinberg, współdyrektor GLAM-E, inicjatywy o politykach otwartego dostępu działającej na NYU Law School i University of Warwick. Jego materiał jest niemal w całości publiczny, czyli dokładnie taki, na jakim powinny trenować modele. Dzielenie się zbiorami bez wywracania cudzych serwerów jest więc technicznie możliwe, boty wybierają jednak najkosztowniejszą ścieżkę.
Co mówi dyskusja Hacker News
Wątek 50392499 zebrał do wieczornego odczytu 6 listopada 116 punktów i 53 komentarze. To osobny tor od artykułu CBC: głosy użytkowników, nie sprawdzone fakty, więc przypisuję je nickami. Użytkownik Bender podał swoją receptę na skraperów: limit 16 kb/s i jedno żądanie na 5 sekund, strona statusu 429 z prośbą o zwolnienie tempa, a dla upartych status 444 i wpis adresów do zestawów nftables. Phil Eaton (eatonphil), autor serwisu The Consensus, opisał drugą stronę medalu: dostaje dziesiątki tysięcy adresów IP po jednym lub dwa żądania, a taki ruch psuje liczniki odsłon, od których uzależnił sprzedaż sponsoringu; pisze też, że nawet płatne systemy Cloudflare do klasyfikacji ruchu botów tego nie rozwiązały. Autor wątku blakesterz dodał kontekst do liczby z Chapel Hill: uczelnia była przyzwyczajona do mniej więcej 11 tysięcy wyszukiwań łącznie na dzień, a tu 11 tysięcy weszło na samą fińską muzykę.
Głosów sprzeciwu też nie brakuje. Część komentujących uznaje skalę z artykułu za przereklamowaną, ktoś inny przypomina, że instytucje publiczne nie mają zespołów w rozmiarze big tech i że kto za tę rozbudowę infrastruktury zapłaci, pozostaje otwarte pytanie. Skala pozostaje więc sporna.
Środki obronne i ich cena
Pierwsza linia obrony to CAPTCHA i inne testy weryfikacyjne. Weinberg zwraca uwagę na paradoks: te same mechanizmy odsiewają też boty użyteczne, na przykład indeksujące wyszukiwarki albo harwestery metadanych. Druga linia, wymaganie logowania, jest w relacji CBC nazwana kontrowersyjną: pytani eksperci chcą jej unikać, bo stawia barierę przed ludźmi, dla których te zbiory w ogóle otwierano. Trzecia, blokowanie adresów, nie działa wg Hellmana z powodu rotacji tysięcy adresów.
Pomoc deklarują też same firmy AI. Przez lata argumentowały, że skrapowanie publicznych danych mieści się w fair use i służy interesowi publicznemu; pod naporem krytyki i procesów o prawa autorskie Anthropic, OpenAI, Google i Microsoft zadeklarowały w ostatnim tygodniu przed publikacją tekstu CBC, czyli pod koniec października 2026, wsparcie dla jednego znormalizowanego sygnału opt-out zapisywanego w robots.txt. Zastrzeżenia są dwa i oba twarde: zgodność pozostaje dobrowolna, a porozumienie nie obejmuje problematycznych botów od podmiotów trzecich i mniejszych startupów. Weinberg wskazuje wprost najgorszą konsekwencję długoterminową: boty stwarzają „zniechęcenie dla bibliotek i innych instytucji do udostępniania online części zbiorów”. Otwarte zasoby wiedzy mierzą się z AI zresztą nie tylko na kolekcjach danych; angielska Wikipedia sprząta treści pisane przez modele, opisaliśmy to w tekście o czystce na Wikipedii.
Co z tego wynika dla polskich bibliotek
W odczytach z 6 listopada 2026 nie znalazłem komunikatu POLONA, Biblioteki Narodowej, Federacji Bibliotek Cyfrowych ani katalogu NUKAT o presji botów AI; pisze to wprost jako brak danych, nie jako brak problemu. Zastrzegam granicę odczytu: serwis POLONA zwracał mi dziś status 503 na części ścieżek, więc pełnego przeglądu tej platformy nie zrobiłem. Przez aktualności Biblioteki Narodowej przeszedłem bez trafień na boty, skrapowanie i crawlery.
Konfiguracja jest za to sprawdzalna na żywo i daje trzy konkretne odczyty. Plik robots.txt Biblioteki Narodowej (bn.org.pl, odczyt 6.11.2026) blokuje boty SEO typu AhrefsBot, SemrushBot czy MJ12bot i nie wymienia żadnego bota AI: ani GPTBot, ani ClaudeBot, ani CCBot. POLONA w ogóle nie serwuje robots.txt, żądanie tego pliku kończy się kodem 404. Repozytorium Instytucjonalne UW ma standardowy plik DSpace bez reguł dla botów AI. Kanał legalnego zbierania przy tym działa: żądanie Identify do endpointu OAI-PMH repozytorium UW odpowiada dziś pełnym nagłówkiem protokołu 2.0, czyli maszyny mogą brać metadane hurtowo, nie obciążając katalogu.
Polski popyt na temat przed falą: w autocompletach Google PL z 6.11.2026 żyją rodziny „scrapowanie danych” i „crawler co to”, jest dokładna fraza „jak zablokować boty ai” i pytanie „co to są boty ai”. Gdy polska instytucja opublikuje własny komunikat albo pomiar skali, dopiszę go do tego tekstu.
Najczęstsze pytania
Co to są boty AI?
To programy, które wykonują działania w sieci automatycznie, w tym pobierają strony i treści; w relacji CBC chodzi o skraperów danych zasilających duże modele językowe. Biblioteki i muzea są celem dobranym logicznie, bo mają treści sprawdzone i zwykle bez paywalli. Skala z przykładu UNC Chapel Hill: ponad 11 tysięcy wyszukiwań z tysięcy adresów w jeden dzień (raport 2025, za CBC 5.11.2026).
Czym są boty w internecie?
Bot to oprogramowanie wykonujące w sieci żądania bez człowieka przy klawiaturze. Nie wszystkie są szkodliwe: wg relacji CBC wyszukiwarki i Internet Archive trzymają się reguł robots.txt i nie wywracają serwisów. Problem zaczyna się, gdy bot ignoruje te reguły i żąda tysięcy dokumentów na sekundę.
Jak zablokować boty AI?
Deklaracja w robots.txt to pierwszy krok, a pod koniec października 2026 Anthropic, OpenAI, Google i Microsoft zadeklarowały wsparcie dla znormalizowanego sygnału opt-out; zgodność pozostaje jednak dobrowolna, a podmioty trzecie zostają poza porozumieniem. Blokowanie adresów IP traci sens przy rotacji tysięcy adresów. W relacji CBC na stole są jeszcze CAPTCHA, która odsiewa też boty użyteczne, i logowanie, które odcina ludzi; skutecznej obrony bez kosztów po stronie czytelnika ten tekst nie opisuje.
Co to web crawler?
Web crawler to bot, który obchodzi strony i zbiera ich treść, zwykle poruszając się po linkach. Crawlerzy wyszukiwarek honorują robots.txt, więc indeksowanie działa bez wywracania serwisów. Skraper AI różni się od niego zachowaniem: potrafi pominąć reguły i ściągać dane w każdym formacie, i to on generuje opisywane przez CBC awarie bibliotek.
Źródła
- University libraries are being swarmed by AI bots, putting public access at risk, CBC News, Kevin Maimann, 5.11.2026 (odczyt 6.11.2026, przez kopię w Wayback Machine z 6.11.2026)
- Wątek Hacker News o artykule (116 punktów, 53 komentarze, odczyt 6.11.2026)
- Robots.txt Biblioteki Narodowej (odczyt 6.11.2026)
- OAI-PMH repozytorium UW, żądanie Identify (odczyt 6.11.2026)