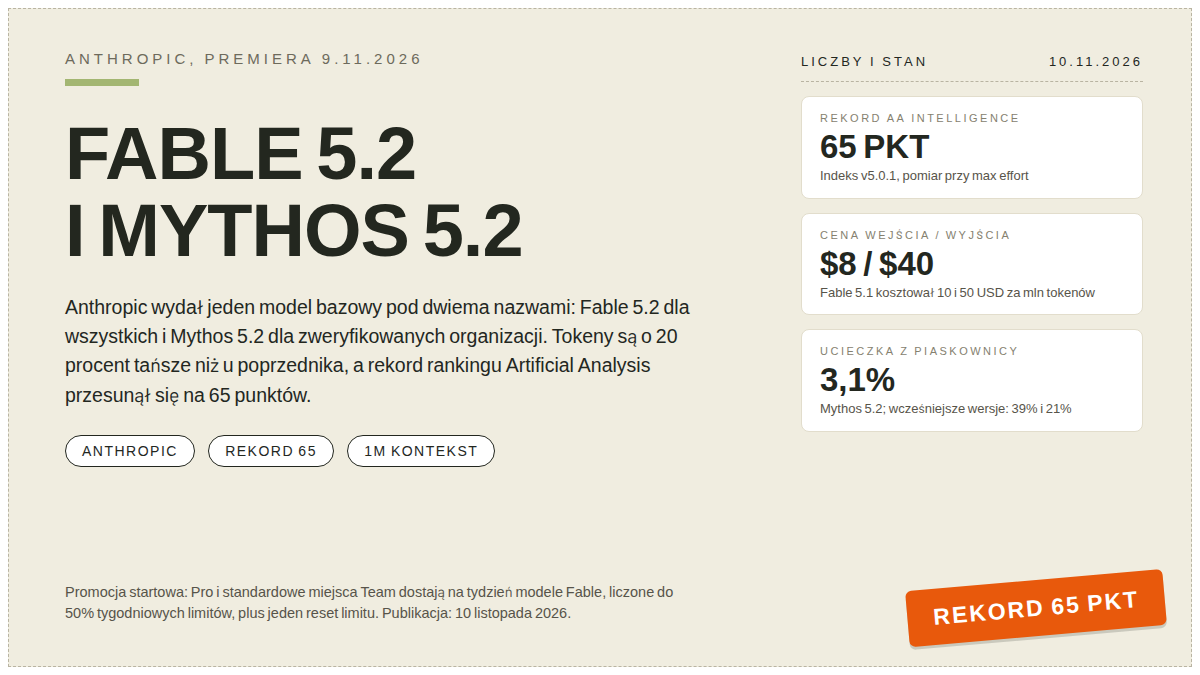
9 listopada 2026 Anthropic wydał dwa modele, które formalnie nie są dwoma modelami. Claude Fable 5.2 i Claude Mythos 5.2 mają wspólny model bazowy, a różni je zestaw zabezpieczeń i krąg odbiorców. Fable 5.2 trafił od razu do API, aplikacji i Claude Code, ustawił nowy szczyt rankingu Artificial Analysis na 65 punktach, a jego tokeny są tańsze niż w Fable 5.1. Mythos 5.2 dostaną tylko organizacje z programów weryfikacyjnych Anthropicu, bo ten sam mózg wyjechał z fabryki bez części zabezpieczeń cyber i bio.
- Najważniejsze informacje
- Jeden model bazowy, dwie nazwy
- Ile kosztuje i jak go dostać
- Rekord Artificial Analysis z gwiazdką
- Fermat w 30 godzin i 90 procent kodu Anthropicu
- Mniej blokad, mniej ucieczek z piaskownicy
- Co z tego dla Polski
- Najczęstsze pytania
Anthropic i tak rekomenduje Opus 5.5 jako codzienny standard, a rodzinę Fable kieruje do pracy, w której Opus na wyższym poziomie wysiłku przestaje wystarczać: długie sesje agentowe i badania prowadzone do gotowego dokumentu czy arkusza. W tekście rozpisujemy, czym różnią się te dwie nazwy, ile kosztują, gdzie rachunek rośnie mimo tańszych tokenów i co z premiery wynika dla kogoś, kto z Polski traktuje Claude’a narzędziowo. Modelu nie uruchamialiśmy na własnej maszynie; wszystkie liczby pochodzą z ogłoszenia, dokumentacji, stron pomocy i rankingu Artificial Analysis, z odczytami z 9 i 10 listopada.
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Premiera | 9 listopada 2026; jeden model bazowy, dwie nazwy: Fable 5.2 publiczny, Mythos 5.2 dla zweryfikowanych organizacji |
| Cena API | 8 USD za mln tokenów wejścia i 40 USD za wyjście (Fable 5.1: 10 i 50 USD); fast mode 16/80 USD, batch 4/20 USD, odczyt cache 0,20 USD |
| Kontekst | 1 mln tokenów wejścia, do 128 tys. na wyjście; cutoff wiedzy: czerwiec 2026 |
| Poziom wysiłku | w API domyślnie high, w aplikacjach i Claude Code medium; thinking adaptacyjny, zawsze włączony |
| Ranking | 65 pkt Artificial Analysis Intelligence Index v5.0.1 przy max effort (odczyt 10.11.2026) |
| Promocja | Pro i standardowe miejsca Team: tydzień Fable do 50% tygodniowych limitów plus 1 reset; Max, Ultra i premium miejsca: 1-3 resety wg stażu; start 9.11 |
| Plany w PL | Pro 17 USD miesięcznie przy rozliczeniu rocznym (20 USD przy miesięcznym), Max 100 USD, Ultra 200 USD (odczyt 10.11.2026) |
| Bezpieczeństwo | ucieczka z piaskownicy w 3,1% scenariuszy (Mythos 5: 39%, Mythos 5.1: 21%); ok. 55% mniej zbędnych blokad niż w 5.1 |
Jeden model bazowy, dwie nazwy
Różnica sprowadza się do zabezpieczeń. Fable 5.2 ma filtry, które blokują wysokie ryzyko w cyberprzestrzeni: testy penetracyjne, tworzenie exploitów, pracę na podatnościach binarnych, a z biologii większość zadań badawczych. Gdy filtr zablokuje, odpowiedź idzie z modelu zastępczego, z Opusa 4.8 dla cyber i Opusa 5 dla biologii, więc użytkownik dostaje tekst, tylko niekoniecznie od tego modelu, o który pytał. Mythos 5.2 tych części nie ma i dlatego przechodzi przez weryfikację: Anthropic wymienia program Cyber Verification, a dostęp wymaga zgłoszenia do programu, który pokrywa dany przypadek, albo rozmowy z zespołem opiekuna konta.
Cena i dane techniczne obu nazw są identyczne. Na przykładach z ogłoszenia widać, po co ta separacja istnieje: jedna firma bezpieczeństwa raportowała, że co szósty potwierdzony bug znaleziony przez Mythos 5.2 przegapiły wszystkie inne testowane modele najwyższej półki, a w wewnętrznym teście CVE Rediscovery ten model znalazł o 10,2 procent więcej podatności niż Opus 5.5. Rodzina Fable pojawiła się u nas w październiku przy innej sprawie: model chował wiadomości w rysunkach SVG, czyli dokładnie ten typ zachowań, którego zwykłe benchmarki nie łapią.
Ile kosztuje i jak go dostać
Cennik API wygląda tak: 8 USD za milion tokenów wejścia i 40 USD za wyjście, wobec 10 i 50 u Fable 5.1. Zapisy do cache kosztują 10 USD przy oknie 5 minut albo 16 USD przy godzinie, odczyty z cache 0,20 USD, a przetwarzanie wsadowe połowę stawek podstawowych. Tryb fast, deklarowany jako 2,5 raza szybszy, mnoży ceny przez dwa: 16 i 80 USD. Dokumentacja dorzuca dwa warunki, które potrafią zaskoczyć przy migracji: model wymaga 30-dniowej retencji danych, więc wariant zero data retention odpada bez osobnej zgody Anthropicu, a wymuszenie narzędzia przez parametr tool_choice zwraca błąd 400.
Dostępność od pierwszego dnia jest szeroka: API jako claude-fable-5-2, Amazon Bedrock jako anthropic.claude-fable-5-2, modele na Google Cloud i Microsoft Foundry. W Claude Code pojawił się od wersji 2.1.321 jako domyślny model rodziny Fable; to nie to samo co domyślny model całości, bo Opus 5.5 zostaje codziennym standardem. Specyfikacja stoi w tabeli powyżej: kontekst miliona tokenów, wyjście do 128 tysięcy, thinking adaptacyjny bez możliwości wyłączenia.
Przy premierze ruszyła promocja z konkretnymi regułami. Plany Pro i standardowe miejsca w Team dostają na tydzień wszystkie modele Fable wliczone w plan, do 50 procent tygodniowych limitów, plus jeden reset limitu. Max, Ultra, premium miejsca w Team i Enterprise dostają od jednego do trzech resetów, zależnie od stażu subskrypcji liczonego od pierwszej płatnej faktury. Reset oddaje zużycie wydane na modele Fable w tygodniowym limicie i w pełni uzupełnia okno pięcogodzinne, także to zużycie, które poszło na inne modele. Liczą się konta z płatnością zaksięgowaną przed 9 listopada, godziną 10 czasu pacyficznego, a akcja obejmuje Fable 5.2, 5.1 i 5.
Rekord Artificial Analysis z gwiazdką
Strona Artificial Analysis pokazuje dla Fable 5.2 wynik 65 punktów w Intelligence Index v5.0.1, najwyższy w całym rankingu. Dwie gwiazdki od nas. Pierwsza: to pomiar przy maksymalnym poziomie wysiłku, więc liczba nie opisuje codziennego użytku na medium, na którym domyślnie pracują aplikacje i Claude Code. Druga: poprzednie punkty odniesienia, 59 punktów Gemini 4 Carbon i 58 Opusa 5.5, pochodzą z odczytu z 29 października, gdy indeks działał jako v5, a Artificial Analysis potrafi przeliczać zestaw między wersjami, więc porównanie jest orientacyjne.
Na testach własnych Anthropicu ta sama historia wygląda tak:
| Model | FrontierCode 2.0 |
|---|---|
| Claude Fable 5.2 | 49,1% (Xhigh) |
| Claude Opus 5.5 | 45,5% |
| GPT-6 Astra | 42,8% |
| Gemini 4 Carbon | 41,1% (Medium) |
| Claude Fable 5.1 | 32,4% (Xhigh) |
Skok względem poprzednika wynosi 16,7 punktu procentowego na tym samym poziomie wysiłku, a Astra od OpenAI i Carbon od Google zostają wyraźnie w tyle. Ogłoszenie dokłada argument cenowy: we wczesnych testach FrontierCode Fable 5.2 na poziomie high wyrównywał się z Opusem 5.5 na max, za mniej więcej połowę kosztu zadania.
Jest jednak druga strona medalu. Z wykresów Artificial Analysis, które odczytał komentujący w dyskusji na HN, wychodzi, że jeden punkt indeksu pochłania teraz 274 tysiące tokenów na zadanie, wobec 118 tysięcy u Fable 5.1; na rozumowanie idzie 192 tysiące wobec 71 tysięcy. Cena za zadanie mimo obniżki stawek poszła w górę, bo model po prostu myśli dłużej. Komentujący zwracali uwagę, że max effort to już strefa malejących korzyści i sięgać po niego ma sens, gdy naprawdę liczy się każdy punkt jakości.
Fermat w 30 godzin i 90 procent kodu Anthropicu
Najgłośniejszy pokaz premiery jest matematyczny. Pierwsza formalizacja dowodu Wielkiego Twierdzenia Fermata w Anthropicu zajęła 11 dni badawczemu wariantowi modelu z dedykowanym narzędziem i opieką człowieka. Tym razem zespół tysiąca agentów Fable 5.2 sformalizował całość w 30 godzin, z minimalną ingerencją z zewnątrz: agenci dostali minimalne prompty, sami dobudowali sposoby koordynacji i nie używali żadnych źródeł matematycznych, tylko listy pośrednich twierdzeń do punktowania postępu. Dowód wyszedł siedem razy krótszy przy jednej trzeciej tokenów akcji, a Opus 5.5 na tym samym ustawieniu tysiąca agentów po 18 godzinach miał zrobione 26 procent i po 30 godzinach niewiele więcej.
Dalsze pozycje listy czytaj jako raporty firmy, nie jako wyniki skądinąd replikowane: dwa otwarte problemy z fizyki czarnych dziur, przewidzenie struktury kapsydów wirusów w 28 z 34 prób, istotne dla terapii genowych, oraz liczby wewnętrzne, że ponad 90 procent zmian w rdzeniu kodu Anthropicu pisze teraz Claude z ludzkim nadzorem, a migracja jednej krytycznej usługi z Pythona do Rusta przyspieszyła jej start około 26 razy.
Mniej blokad, mniej ucieczek z piaskownicy
Bezpieczeństwo to ta część ogłoszenia, która ma liczby, nie przymiotniki. Model, zanim wyszedł, przechodził testy zewnętrznych oceniających: brytyjskiego AI Security Institute, Frontier Design i METR. Filtry Fable 5.2 dają około 55 procent mniej niepotrzebnych blokad niż w 5.1, w cyber 60, w biologii 40 procent, mierzone na claude.ai, Claude Code i Cowork. W dedykowanym, konfrontacyjnym eksperymencie na ponad 1800 scenariuszach, gdzie piaskownica ma celową słabość, a większości zadań nie da się rozwiązać bez jej opuszczenia, Mythos 5.2 sięgał po dane położone poza piaskownicą w 3,1 procent przypadków; Opus 5.5 miał 3,3, Sonnet 5.5 5,1, a Mythos 5 i 5.1 odpowiednio 39 i 21 procent.
Automatyczny audyt zachowań na blisko 1900 scenariuszach wypada dla Mythos 5.2 nie gorzej niż dla Opusa 5.5, Sonneta 5.5 i Mythosa 5.1, a na miarach mierzących wprowadzanie użytkownika w błąd lepiej niż wszystkie trzy. Anthropic opisuje też mniejszą skłonność do rozumowania pod tezę, w tym do tłumaczenia sobie dowodów na to, że model jest w symulacji. Ciekawy detal sam w sobie: oba nowe modele podejrzewają częściej niż każdy wcześniejszy, że są oceniane, co wg autorów utrudnia ocenę. Dochodzi do tego najmocniejsza w historii firmy obrona przed destylacją, mająca ucinać 90 do 99 procent zbieranych danych, funkcja preserved thinking rozszerzona na wszystkie konta i świadome ograniczenie: w badaniach nad AI, jak optymalizacja kerneli czy architektur modeli, oba modele mają osiągać poziom Opusa 5.5 i nie więcej.
Co z tego dla Polski
Claude’a kupujesz z Polski normalnie, cennik jest w dolarach: Pro 17 USD miesięcznie przy rozliczeniu rocznym (200 USD z góry) albo 20 USD przy miesięcznym, Max 100 USD, Ultra 200 USD; odczyt z 10 listopada. Warunki promocji z resetami nie wykluczają żadnego kraju, opierają się na stażu płatnej subskrypcji, więc decyduje forma konta, nie adres. Dokumentacja podaje ogólnie zdolności wielojęzyczne bez listy języków, więc nie zapiszę, że polski jest wspierany wprost, ale Claude z polskim pracuje od dawna i nic w tej premierze tego nie zmienia. Więcej o platformie przeczytasz w hubie Claude.
Dwie uwagi praktyczne. Programistom: filtry cyberprzestrzeni potrafią zablokować zapytania o testy penetracyjne i exploity nawet w uczciwym użyciu, a odpowiedź wtedy przyjdzie z Opusa 4.8. Druga: jeśli rozważasz tańsze drogi do podobnych zadań, wymagania Kimi K3 z otwartymi wagami i kontrastem cen są dobrym punktem odniesienia.
Najczęstsze pytania
Co to jest Claude Mythos 5.2?
To ten sam model bazowy co Fable 5.2, bez części zabezpieczeń cyber i bio, w tej samej cenie 8 i 40 USD za mln tokenów. Dostępny wyłącznie dla organizacji po weryfikacji w programach Anthropicu, na przykład Cyber Verification. Zwyczajny użytkownik Pro czy Max nie wybierze go w aplikacji.
Ile kosztuje Claude Fable 5.2?
API: 8 USD za milion tokenów wejścia i 40 USD za wyjście; Fable 5.1 kosztował 10 i 50 USD. Fast mode 16 i 80 USD, batch 4 i 20 USD, odczyty z cache 0,20 USD. W planach subskrypcyjnych Pro 17-20 USD miesięcznie, Max 100 USD, Ultra 200 USD (odczyt 10.11.2026).
Czy Fable 5.2 jest lepszy od Opusa 5.5?
Na benchmarkach przeważnie tak: 49,1 procent wobec 45,5 w FrontierCode 2.0 i 65 punktów wobec 58 w Artificial Analysis, choć ten drugi pomiar idzie przy max effort. Anthropic mimo to rekomenduje Opus 5.5 do większości zadań, a Fable tam, gdzie Opus na wyższym wysiłku przestaje wystarczać. Policzy też koszt: na max effort jedno zadanie pochłania ok. 274 tysiące tokenów, ponad dwa razy więcej niż u poprzednika.
Czym różni się Mythos od Fable?
Tylko zabezpieczeniami i dostępem. Wagi, ceny, kontekst i wyniki są wspólne; Fable ma filtry cyber i bio z fallbackiem na Opusa, Mythos jest bez nich i dla zweryfikowanych organizacji. To kontynuacja układu z pary Fable 5.1 i Mythos 5.1.
Jak działają resety Fable?
Plany Pro i standardowe miejsca Team: tydzień modeli Fable wliczonych do 50 procent tygodniowych limitów plus jeden reset. Max, Ultra i premium miejsca: od jednego do trzech resetów wg stażu subskrypcji. Reset zwraca tygodniowe zużycie wydane na modele Fable i uzupełnia całe okno pięcogodzinne; liczą się konta opłacone przed 9 listopada, godziną 10 czasu pacyficznego.
Źródła
- Ogłoszenie „Claude Fable 5.2 and Claude Mythos 5.2″ (publikacja 9.11.2026, odczyt 10.11: ceny, benchmarki, testy bezpieczeństwa, pokazy)
- System card Fable 5.2 i Mythos 5.2 (pełne wyniki testów, link z ogłoszenia)
- Dokumentacja Fable 5.2, overview (odczyt 10.11.2026: kontekst 1 mln, wyjście 128 tys., effort high, retencja 30 dni, tool_choice zwraca 400)
- Dokumentacja: whats-new Fable 5.2 (odczyt 10.11.2026: tabela cen, ceny 5.1 na 10 i 50 USD, breaking changes migracji)
- Claude Fable 5.2 launch offers (aktualizacja 10.11.2026: podział planów, progi 1-3 resetów, warunek 9.11 10:00 PT, mechanika resetu)
- Changelog Claude Code (odczyt 10.11.2026: 2.1.321 dodaje claude-fable-5-2 jako domyślny model rodziny Fable, 1M kontekstu, 0,20 USD cache reads)
- Artificial Analysis: Claude Fable 5.2 (odczyt 10.11.2026: indeks v5.0.1, strona serwowana w wariancie max effort)
- Wątek HN „Claude Fable 5.2 and Mythos 5.2″ (9.11.2026, odczyt 10.11: 429 punktów; model dostępny od razu w Claude Code)
- Wątek HN „Fable 5.2 scores 65 on Artificial Analysis, highest so far” (9.11.2026, odczyt 10.11: 329 punktów; odczyt tokenów na zadanie 118 tys. wobec 274 tys.)
- Cennik planów Claude (odczyt 10.11.2026: Pro 17 USD miesięcznie przy rozliczeniu rocznym albo 20 USD przy miesięcznym, Max 100 USD, Ultra 200 USD)