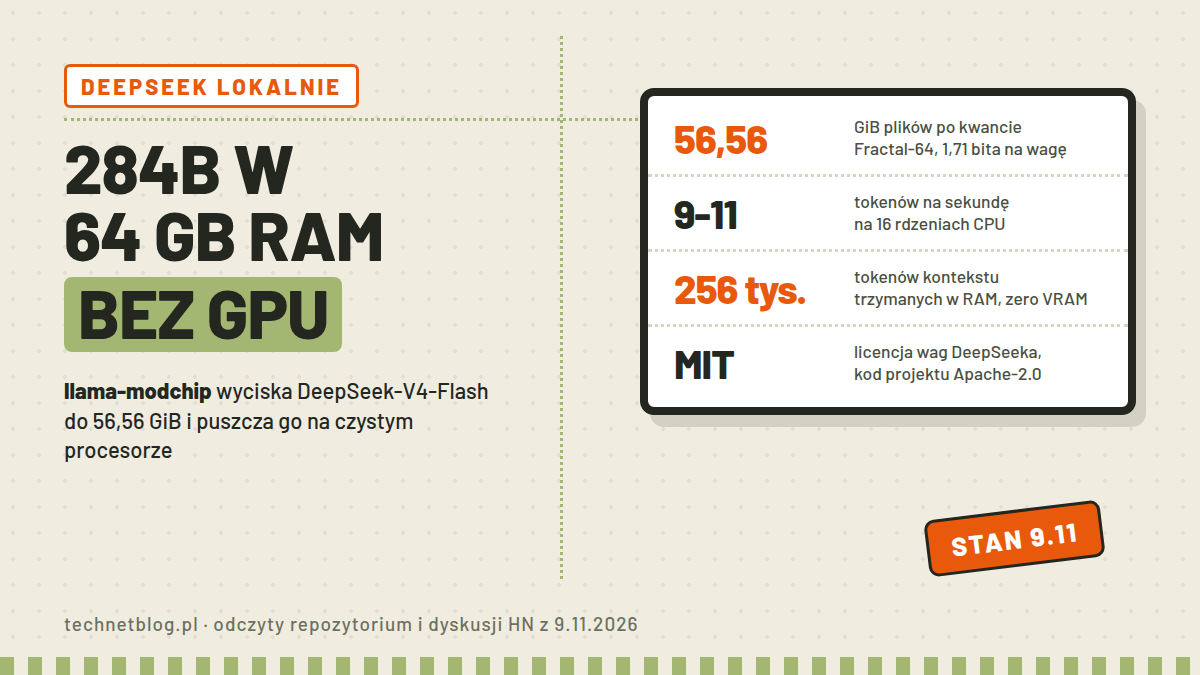
Wątek „Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU” zebrał na Hacker News 402 punkty w odczycie z 9 listopada i w tytule ma całą obietnicę projektu: synchopate/llama-modchip to zestaw patchy do llama.cpp plus transkoder kwantów, które razem pozwalają wczytać DeepSeek-V4-Flash, model o 284 mld parametrów, w 64 GB zwykłej pamięci operacyjnej, bez karty graficznej. Autor deklaruje 56,56 GiB na dysku, od 9 do 11 tokenów na sekundę generowania na 16-rdzeniowym procesorze Ryzen 9 i szczyty blisko 15 tok/s przy spekulacji. W tym tekście sprawdzamy, skąd bierze się ta pojemność, dlaczego część komentarzy na HN kwestionuje sens tak głębokiej kwantyzacji, a część broni jej z codziennego użytku, i co z tego uruchomisz na sprzęcie klasy domowej. Projektu nie testowaliśmy na własnej maszynie, bo nie mamy wolnego desktopa z 64 GB RAM; wszystkie liczby pochodzą z repozytorium, notek wydania, metadanych Hugging Face i dyskusji, z odczytami z 9 listopada.
- Najważniejsze informacje
- Jak 284B mieści się w 64 GB RAM
- Dwa bity na wagę, czyli spór o jakość
- Pułapka: Ollama i LM Studio tego nie wczytają
- Ile to faktycznie działa w praktyce
- Wymagania w praktyce: laptop, desktop i brak w Ollamie
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Model | DeepSeek-V4-Flash-0731: 284,33 mld parametrów, 13,17 mld aktywnych (dane projektu), licencja MIT, publikacja 31.07.2026 |
| Pamięć | 56,56 GiB plików, ok. 57,6-58,9 GiB RAM przy kontekście 256 tys. tokenów, zero VRAM |
| Prędkość | 9,06-10,74 tok/s generowania i 44,36 tok/s prefillu na Ryzen 9 9955HX (pomiar autora, notki v2.4.0) |
| Kontekst | 256 tys. tokenów trzymane w RAM; oficjalny model ma okno do 1 mln tokenów |
| Kompatybilność | własne binarki; czysty llama.cpp, Ollama i LM Studio odmówią („unknown tensor type 40″) |
| Laptop | Nemotron-3.5-30B: 14,35 GiB, 25-60,4 tok/s na maszynie z 16-32 GB RAM |
| Stan projektu | v2.4.0, repo utworzone 29.10.2026, Apache-2.0, 559 gwiazdek, ostatni push 8.11 |
| Kwanty standardowe | unsloth/DeepSeek-V4-Flash-0731-GGUF: 51 plików, 151 tys. pobrań (odczyt 9.11.2026) |
Jak 284B mieści się w 64 GB RAM
DeepSeek-V4-Flash to model typu Mixture of Experts. Wszystkich parametrów ma 284,33 mld, ale na każdy token router wybiera tylko 13,17 mld, rozłożone na 43 warstwy, w każdej po 256 ekspertów obsadzanych dynamicznie plus jeden współdzielony. Pułapka jest ta sama, którą opisywaliśmy przy wymaganiach Kimi K3: żeby router mógł wybierać dowolnie, wszystkie wagi muszą stać w pamięci naraz, więc liczy się pełny rozmiar, nie aktywna część. Najmniejszy standardowy kwant od unsloth, UD-IQ1_S, zajmuje 76,87 GiB, a na komputerze z 64 GB RAM po odjęciu systemu zostaje około 62,5 GiB użytecznej pamięci. Różnica wygląda na niewielką i właśnie dlatego zabija uruchomienie: plik nie mieści się, system zaczyna przepisywać strony pamięci na dysk i wydajność ląduje albo proces dostaje OOM.
llama-modchip rozwiązuje to przepakowaniem wag, nie jakąś nową architekturą silnika. Eksperci lądują głównie w formacie IQ1_S, czyli 1,5625 bita na wagę, z drugorzędnym skalowaniem oznaczonym jako SwiGLU-H2; warstwy uwagi MLA przechodzą na własny format Fractal-64 (typ Q2_0) o 3,75 bita, bloki po 64 wagi ze wspólną skalą BF16; osadzenia i warstwy wrażliwe zostają w Q4_K, Q5_K i F32. Całość zamyka się w 56,56 GiB, co daje miejsce i na kontekst 256 tysięcy tokenów trzymany w RAM.
Pojemność to jednak dopiero połowa pracy, bo czysty procesor dławi przepustowością pamięci. Patche projektu atakują ją od kilku stron: tiling rejestrowy AVX-512 przyspieszył prefill z 24,7 do 44,36 tok/s, czyli o 77%, ostrzeżenia non-temporal pilnują, żeby strumień wag ekspertów nie wypierał gorącego cache kontekstu, a osobny moduł zgadywania kolejnych tokenów, drafter o rozmiarze 1,64 MB inspirowany technikami silnika szachowego Stockfish, dokłada przewidywane tokeny za darmo, kiedy tylko trafi. Drafter zgaduje z akceptacją 94,5%, więc realna prędkość generowania rośnie do 11-14,7 tok/s. Dla pracy agentowej jest jeszcze drobiazg, który robi różnicę: migawka cache kontekstu zapisywana w /dev/shm odtwarza sesję Claude Code z 40 narzędziami w około 13 ms, zamiast ponawiać wielosekundowe liczenie promptu od zera.
Dwa bity na wagę, czyli spór o jakość
1,71 bita na wagę to głęboko poniżej czterech bitów, przy których społeczność lokalnych modeli zwykle umieszcza rozsądny kompromis rozmiaru i jakości, i ta rozbieżność wywołała najżywszą część dyskusji. Najcelniej ujął to komentujący throw10920: „2-bit quant is the 'in mice’ of 'look at how big a model I can fit on this hardware’”. Inny, walrus01, pisał wprost: „exceedingly skeptical of anyone that claims to get good QUALITY results out of it at that size”, argumentując, że model tej skali potrzebuje dla pełnej jakości ok. 150 GB RAM. To głosy z doświadczenia, nie trolingu, i mocno ciążą ku sceptycyzmowi.
Trzeba tylko czytać dokładnie, co projekt deklaruje jako „lossless”. Tabela notek wydania pokazuje podobieństwo logitów 1,00000 i zerową dywergencję KL, ale to zgodność własnego silnika z niepatchowanym llama.cpp na tym samym przepakowanym pliku, czyli miara poprawności implementacji, nie jakości względem pełnego modelu. Benchmarków porównujących Fractal-64 z oryginałem w pełnej precyzji nie ma ani w repozytorium, ani w zgłoszeniach społeczności (odczyt 9 listopada); są tylko odchyłki prawdopodobieństw dla trybów, które dobrowolnie odcinają część ekspertów dla prędkości, od +0,42% do +12,29% zmian w top-10. Jeżeli ktoś obiecuje Ci „bezstratne” 2 bity, sprawdza właśnie inną rzecz.
Kontrargumenty też pochodzą z użytkowania, nie z marketingu. Jeden z komentujących opisuje 2-bitowy checkpoint 0731 jako swoją codzienną dźwignię na ~15 tok/s, a inny przywołuje pogłos z r/LocalLLaMA, że większy model mocno ściśnięty bywa lepszy od mniejszego luźno skwantyzowanego. Skala zjawiska mówi sama za siebie: agresywne kwanty GSQ-RCO nowszego DeepSeek-V4.1-Flash-1017 mają na Hugging Face 3,1 mln pobrań, więc dwubitowe pliki to już nie egzotyk, tylko mainstream lokalnego hobbystycznego AI. Jak to naprawdę działa, rozstrzygnąłbym dopiero własnym testem na własnych zadaniach; takiego pomiaru nie ma w dyskusji, a i my go nie robimy.
Pułapka: Ollama i LM Studio tego nie wczytają
Format Fractal-64 używa własnego typu tensora GGML_TYPE_Q2_0 o numerze 40, którego czyste narzędzia nie znają. README pisze to czarno na białym: niepatchowany llama.cpp, Ollama i LM Studio odmówią z komunikatem „unknown tensor type 40″. Projekt dlatego dowozi własne, wstępnie skompilowane binarki dla Linuksa x86_64 razem z plikami GGUF na Hugging Face, a kto woli, kompiluje z załączonych patchy. Zapisałem to wprost, bo frazy „deepseek ollama” i „deepseek v4 flash gguf” siedzą w autocomplecie Google, a odpowiedź w tym przypadku brzmi: nie przez zwykłe pobranie modelu.
Dokumentację projektu czytaj z rezerwą. Notki wydania v2.3.0 opisują punkt odniesienia jako „4-shard IQ2_XXS”, README jako UD-IQ1_S, a komentarz z 8 listopada wylicza, że kwant IQ2_XXS od unsloth ma 91 GB, więc liczba 76,87 GiB pasuje wyłącznie do IQ1_S; jedna z tych etykiet jest pomylena. Do tego README gęste od emoji i tabel sprzedażowych, co kilka komentarzy na HN nazwało wprost „AI slop”. Żarty mają tu drugie dno: projekt sam siedzi wpięty w Claude Code jako backend dla agentów, czyli pracuje w asystencji modelu. Arytmetykę rozmiarów da się zweryfikować ręcznie i ona się zgadza, ale etykiet kwantów nie przepisuj na wiarę, tylko sprawdzaj rozmiar plików.
Ile to faktycznie działa w praktyce
| Konfiguracja i model | Prędkość | Źródło (data) |
|---|---|---|
| Ryzen 9 9955HX, 16 rdzeni, 64 GB, DeepSeek 284B | 9,06-10,74 tok/s, prefill 44,36 tok/s | notki wydania v2.4.0 (11.2026) |
| Threadripper PRO 7985WX, 256 GB, Nemotron 30B | 111,62 tok/s | zgłoszenie #1 (30.10.2026) |
| AWS Graviton3, 8 vCPU, 32 GB, Nemotron 30B | 44,97 tok/s | zgłoszenie #2 (3.11.2026) |
Uwaga do tabeli: rekordy od społeczności dotyczą mniejszego modelu Nemotron-3.5-30B, nie 284B; dla DeepSeeka o tej skali mamy na razie tylko pomiary autora. Obraz użycia rysują komentarze. Autor biblioteki Redis pokazał na wideo pracę kodującą na maszynie z 128 GB zunifikowanej pamięci i ocenił ją jako „acceptably fast”, z prefilem rzędu 300 tok/s; inny komentujący z tej samej dyskusji policzył na materiale 116 sekund na trywialne zadanie tłumaczeniowe i orzekł „pretty unusable”; kolejny, użytkownik Maca z 128 GB RAM, opisał rozsądne miejsce tych konfiguracji jako długie zadania, które puszcza się na noc i odbiera rano. Do interaktywnej pracy na czystym procesorze 284B zostaje zatem powolny, do wsadów nocnych i przetwarzania wsadowego jest realny od dziś.
Wymagania w praktyce: laptop, desktop i brak w Ollamie
Najbardziej praktyczny wynik całej historii dotyczy laptopów, nie desktopów. Wariant Nemotron-3.5-30B-A3B w kwancie Fractal-64 zajmuje 14,35 GiB i osiąga 25-60,4 tok/s na maszynie z 16-32 GB RAM, więc to dokładnie klasa sprzętu, o którą pyta się w kontekście wyboru modelu pod Ollamę. Desktop z 64 GB RAM dostaje warunki, które łatwo spełnić w domu: Linuksa, dwukanałowy DDR5 i około 63 GB wolnej pamięci w momencie startu, co oznacza zamknięte przeglądarki z setkami kart. Kontekst 256 tysięcy jest już wliczony w podane liczby pamięci.
Z Ollamą jest prosto i gorzko. Biblioteka na odczyt z 9 listopada nie zna pozycji deepseek-v4 ani deepseek-v4.1, oba zapytania zwracają 404; z całej rodziny jest tylko starszy deepseek-r1. Standardowe kwanty GGUF dla 0731 istnieją od sierpnia w repozytorium unsloth, 51 plików od UD-IQ1_M wzwyż i 151 tysięcy pobrań, więc silniki oparte na llama.cpp sobie poradzą, tylko sprzęt musi mieć pamięć na rozmiar rzędu 82 GB dla UD-IQ1_S. Frazy „jak uruchomić deepseek lokalnie” i „deepseek na komputerze” mają więc dziś trzy różne odpowiedzi zależnie od RAM-u, i wszystkie trzy są wyżej.
Modchip obsługuje starszy checkpoint z 31 lipca, a DeepSeek wydał od tego czasu V4.1-Flash (10 września) i V4.1-Flash-1017 (17 października, okno miliona tokenów), więc lokalny eksperyment z 284B nie jest Twoją jedyną drogą do DeepSeeka; rodzinę V4 z rozmiarami GGUF i cenami opisujemy osobno, jak i edycję 1017 oraz start z DeepSeek po polsku. Skala postępu robi jednak wrażenie na tle naszej własnej kroniki: w tekście o Kimi z 4 listopada 2,78 blna parametrów nie mieściło się fizycznie na żadnym komputerze osobistym, dziś 284 mld mieści się na desktopie za równowartość porządnej karty graficznej, bez karty graficznej.
Najczęstsze pytania
Jak uruchomić DeepSeek lokalnie?
Zależnie od sprzętu. Na desktopie z 64 GB RAM: projekt llama-modchip (v2.4.0), binarka i kwant Fractal-64 z jego Hugging Face, 9-11 tok/s na modelu 284B, bez karty graficznej. Na mniejszych maszynach: klasyczne GGUF w llama.cpp albo LM Studio; biblioteka Ollamy nie ma deepseek-v4 (odczyt 9.11), więc pod nią wybierasz inne modele. Rozmiary GGUF całej rodziny opisuje osobny tekst o DeepSeek V4.
Ile RAM potrzebuje DeepSeek V4 Flash?
W pakiecie Fractal-64 projektu llama-modchip: 56,56 GiB plików i ok. 58 GiB RAM przy kontekście 256 tysięcy tokenów, czyli desktop 64 GB. Standardowy kwant UD-IQ1_S od unsloth zajmuje 82,5 GB i w 64 GB się nie mieści. W pełnej precyzji BF16 wyszłoby ok. 569 GB, licząc 284,33 mld parametrów po dwa bajty.
Czy DeepSeek działa bez karty graficznej?
Tak, w konfiguracji llama-modchip na czystym procesorze: 9,06-10,74 tok/s, szczytowo ok. 14,7 tok/s ze spekulacją (pomiar autora na Ryzen 9 9955HX, notki v2.4.0). Punkt odniesienia przed optymalizacjami to 5,91 tok/s, więc działanie bez GPU jest realne, tylko wolne.
Czy jest GGUF DeepSeek V4 Flash?
Tak. unsloth publikuje kwanty od sierpnia: 51 plików GGUF, warianty od UD-IQ1_M wzwyż, 151 tysięcy pobrań (odczyt 9.11.2026). Kwant Fractal-64 od llama-modchip to osobny format z własnym typem tensora o numerze 40, który czyste narzędzia odmówią wczytać, dlatego trafia z własnymi binarkami.
Czy DeepSeek zadziała w Ollamie?
Ten kwant nie, ze względu na typ tensora 40. Biblioteka Ollamy zresztą w ogóle nie zawiera deepseek-v4 ani deepseek-v4.1, oba zapytania zwracają 404 (odczyt 9.11.2026); z rodziny DeepSeek jest tam tylko starszy deepseek-r1.
Źródła
- Repozytorium synchopate/llama-modchip (README v2.4.0, odczyt 9.11.2026: 56,56 GiB, 1,71 bpw, 44,36 tok/s prefill, licencja Apache-2.0, 559 gwiazdek, utworzone 29.10.2026)
- Notki wydania v2.4.0 i v2.3.0 (odczyt 9.11.2026: prefill +77,1%, decode 9,06-10,74 tok/s, akceptacja draftu 94,5%, restore 13,1 ms; v2.3.0 opisuje baseline jako „4-shard IQ2_XXS”, README jako UD-IQ1_S 76,87 GiB)
- FAQ techniczny projektu (odczyt 9.11.2026: typ tensora Fractal-64, tryby Top-K, pomiar produkcyjny na 9955HX)
- Wątek Hacker News „Llama-modchip” (utworzony 8.11.2026, odczyt 9.11: 402 punkty, 180 komentarzy; cytaty o jakości kwantu 2-bit, o video z 128 GB RAM i ocenie „pretty unusable”)
- deepseek-ai/DeepSeek-V4-Flash-0731 (odczyt 9.11.2026: publikacja 31.07.2026, licencja MIT, 2 701 813 pobrań, 4 098 polubień)
- deepseek-ai/DeepSeek-V4.1-Flash-1017 (odczyt 9.11.2026: publikacja 17.10.2026, MIT, kontekst 1 mln tokenów, 295 747 pobrań)
- Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF (odczyt 9.11.2026: 3 pliki GGUF, prekompilowane binarki Linux x86_64, patche, 234 pobrania)
- Zgłoszenie #1 w repo llama-modchip (aifartist, 30.10.2026: Threadripper PRO 7985WX, 256 GB, 111,62 tok/s dla Nemotron 30B)
- Zgłoszenie #2 w repo llama-modchip (gerchik, 3.11.2026: AWS Graviton3 m7g.2xlarge, 32 GB, 44,97 tok/s dla Nemotron 30B)
- unsloth/DeepSeek-V4-Flash-0731-GGUF (odczyt 9.11.2026: 51 plików GGUF, 151 042 pobrania, warianty UD-IQ1_M, UD-IQ1_S, UD-IQ2_M)
- ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF (odczyt 9.11.2026: 3 146 330 pobrań, kwanty nowszego modelu)
- Biblioteka Ollama (odczyt 9.11.2026: deepseek-v4 i deepseek-v4.1 zwracają 404, deepseek-r1 dostępny)