Model językowy nie liczy liter ani słów, tylko tokeny, czyli porcje tekstu, na jakie dzieli się wszystko, co wpisujesz i co dostajesz w odpowiedzi. Od tej jednostki zależą limity czatów i rachunki za API, więc szybkie jej zrozumienie zwraca się w praktyce. W tym tekście wyjaśniam, czym token jest, ile go mają polskie zdania (zmierzyłem to samodzielnie dwoma tokenizerami), ile kosztuje przy aktualnych stawkach OpenAI, Anthropic i Google oraz czy polskie znaki naprawdę podbijają koszt. Jeśli dopiero układasz sobie pojęcia w głowie, wejdź najpierw na hub z podstawami AI, a stamtąd wróć tutaj po szczegóły.
- Token to kawałek słowa, nie zawsze całe słowo
- Ile tokenów ma polski tekst
- Ile kosztują tokeny
- Czy polski naprawdę drożeje
- Limity czatów i komunikaty o błędach
- Jak policzyć tokeny samemu
- Najczęstsze pytania
Token to kawałek słowa, nie zawsze całe słowo
OpenAI definiuje token jako znak, kawałek słowa, całe słowo albo znak interpunkcyjny. Zanim twoje pytanie trafi do modelu, program zwany tokenizerem tnie tekst na takie porcje i zamienia każdą z nich w liczbę. Model nie widzi liter, widzi ciągi liczb, i na nich wykonuje całą swoją pracę. Anthropic w słowniku opisuje tokeny jako najmniejsze pojedyncze jednostki, z którymi pracuje model językowy, i zaznacza, że mogą odpowiadać słowom, podsłowom, pojedynczym znakom albo nawet bajtom.
Działa to trochę jak skróty w notatkach: wyrażenia, które pojawiają się często, dostają krótki znacznik, a rzadkie trzeba zapisać w całości. Tokenizer robi to samo na poziomie fragmentów słów, tylko że jego słownik liczy od stu do dwustu tysięcy pozycji zależnie od wersji i powstał z analizy ogromnych zbiorów tekstów. Stąd wziął się przykład z mojego pomiaru, o którym niżej: angielskie „day” to jeden token, polskie „dzień” dwa, a „źdźbło” aż pięć. To samo zjawisko opisuje osobny tekst o tym, czym jest LLM, bo tokenizacja jest jedną z pierwszych rzeczy, które dzieją się z tekstem wchodzącym do modelu.
Ile tokenów ma polski tekst
Dla angielskiego producenci podają gotowe przeliczniki. OpenAI w centrum pomocy pisze, że jeden token to około 4 znaki i około trzy czwarte słowa, czyli 100 tokenów odpowiada mniej więcej 75 słowom. Anthropic dla starszych modeli podaje około 3,5 znaka na token. Dla polskiego takich tabel nigdzie nie znalazłem, więc zrobiłem własny pomiar biblioteką tiktoken (nota o metodzie na końcu tekstu) na dziesięciu parach słów, jednym zdaniu i akapicie.
Wyniki dla pojedynczych słów w tokenizercie o200k_base, tym od najnowszych rodzin OpenAI, wyglądają tak:
| Słowo po polsku | Tokeny | Angielski odpowiednik | Tokeny |
|---|---|---|---|
| dzień | 2 | day | 1 |
| żółć | 3 | bile | 2 |
| pchnąć | 3 | push | 1 |
| źdźbło | 5 | blade | 1 |
| gęśle | 4 | fiddle | 2 |
| chrząszcz | 4 | beetle | 3 |
| wątróbka | 5 | liver | 2 |
| łabądź | 4 | swan | 2 |
| ćma | 2 | moth | 2 |
| rzęsy | 3 | eyelashes | 3 |
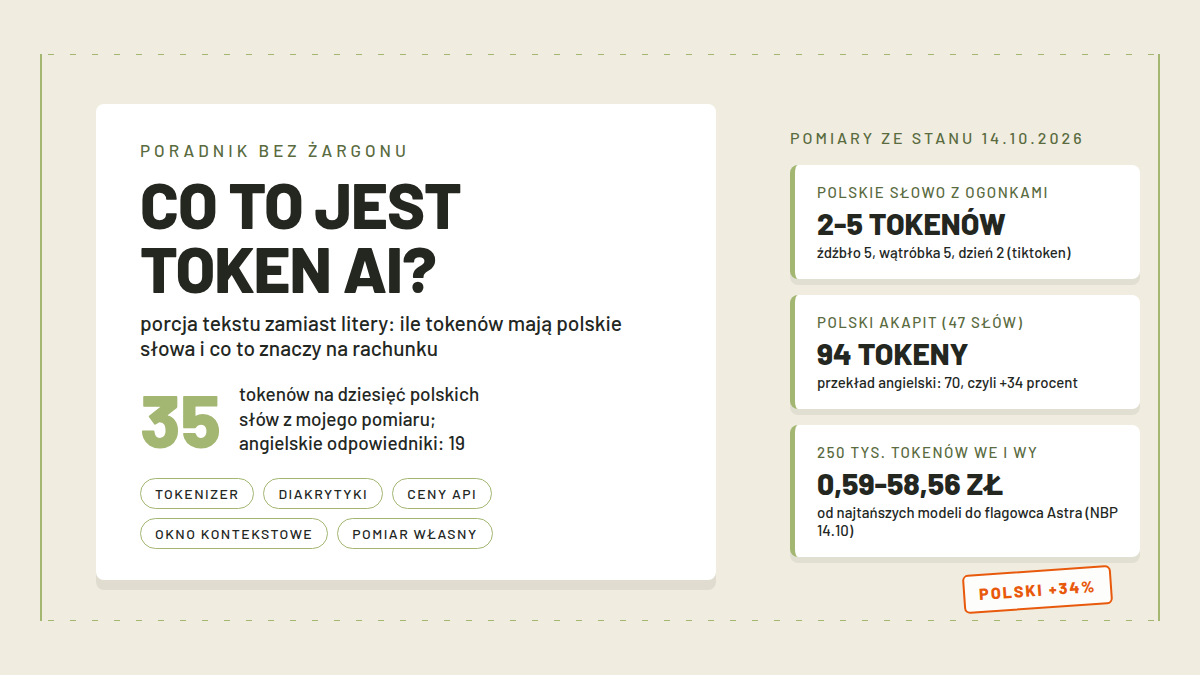
Na dziesięć polskich słów przypada 35 tokenów, na ich angielskie odpowiedniki 19. Mój akapit testowy miał 47 słów i 298 znaków, a w tokenizercie kosztował 94 tokeny; zdanie z 21 słowami, 54 tokeny. Przeliczając to na strony typowego dokumentu, strona z 2500 znakami tekstu po polsku to około 790 tokenów, więc setka stron to około 79 tys. tokenów. To użyteczna miara, gdy cennik mówi o milionach.
Ile kosztują tokeny
Producenci rozliczają API za każdy milion tokenów, osobno dla wejścia (to, co wysyłasz) i wyjścia (to, co model zwraca). Stawki odczytane z oficjalnych cenników 14.10.2026 przedstawiają się następująco:
| Model | Wejście (USD za 1 mln) | Wyjście (USD za 1 mln) | Uwagi |
|---|---|---|---|
| GPT-6 Luna | 0,10 | 0,50 | stawki dla zapytań do 272 tys. tokenów |
| Claude Haiku 5.5 | 0,10 | 0,50 | stawka przy prompcie do 100 tys. tokenów |
| Gemini 3.8 Flash | 0,75 | 3,75 | ceny intro do 31.12.2026, potem 1,50 i 7,50 |
| GPT-6.1 Sol | 2,00 | 10,00 | stawka dla zapytań do 272 tys. tokenów |
| Claude Sonnet 5.5 | 2,00 | 10,00 | cenowo na poziomie GPT-6.1 Sola |
| Gemini 4 Argon | 2,00 | 10,00 | ceny intro do 30.11.2026, potem 4 i 20 |
| GPT-6 Astra | 10,00 | 50,00 | flagowiec, po 272 tys. tokenów stawki rosną do 20 i 75 |
Zapisy typu „2,00/10,00 USD za 1 mln”, z którymi spotkasz się w dokumentacji API Claude, API Gemini czy przy opiniach o GPT-6 Astrze, oznaczają zawsze tę parę: wejście i wyjście. W złotówkach, przy kursie średnim NBP z 14.10.2026 (3,9042 zł za dolara), przetworzenie 250 tys. tokenów z równie długą odpowiedzią kosztuje przy GPT-6 Lunie i Claude Haiku 5.5 po 0,59 zł, przy Gemini 3.8 Flash 4,39 zł, przy GPT-6.1 Solu, Claude Sonnecie 5.5 i Gemini 4 Argonie po 11,71 zł, a przy GPT-6 Astrze 58,56 zł. Pojedyncze zapytanie na 500 tokenów z odpowiedzią na tysiąc to od 0,2 grosza przy najtańszych modelach przez 4,3 grosza w środku stawki po 21 groszy przy Astrze.
Różnice między modelami sięgają stu razy, więc wybór modelu do zadania kosztuje więcej niż jakikolwiek trik z tekstem. Do tego ceny intro bywają czasowe: Argon podrożeje o 100 procent po 30 listopada 2026, Flash po 31 grudnia, i jeśli trzymasz długą listę zadań w kolejce, ten termin ma znaczenie.
Czy polski naprawdę drożeje
Tak, i da się to pokazać na liczbach zamiast opinii. Tokenizery buduje się głównie na korpusach angielskich, więc polskie znaki i rozbudowana odmiana to rzadkie fragmenty, których słownik nie trzyma w całości, i tokenizer składa je z drobniejszych kawałków. Każde słowo zajmuje wtedy więcej tokenów, a skoro płacisz za tokeny, płacisz też więcej za tę samą treść.
Porównanie obu tokenizerów OpenAI na tych samych moich tekstach:
| Tekst | o200k_base (PL) | cl100k_base (PL) | Angielski odpowiednik (ten sam wynik w obu) |
|---|---|---|---|
| Zdanie, 21 słów, 142 znaki | 54 | 60 | 29 |
| Akapit, 47 słów, 298 znaków | 94 | 106 | 70 |
Akapit po polsku kosztuje 34 procent więcej tokenów niż jego angielski przekład w nowszym tokenizercie i 51 procent więcej w starszym. Zdanie, w którym diakrytyki i trudne zbitki gęstnieją, robi się prawie dwa razy droższe. Skala różnicy zależy więc od tekstu, ale kierunek jest stały.
Nowsze tokenizery radzą sobie z polskim lepiej: o200k_base uzyskał na moim akapicie 94 tokeny tam, gdzie starszy cl100k_base potrzebował 106. U Anthropic bywa odwrotnie, bo ich dokumentacja wprost pisze, że tokenizer wprowadzony z modelami od wersji 4.7 generuje o około 30 procent więcej tokenów na tym samym tekście niż poprzedni. Wniosek praktyczny: nie zakładaj po modelu, tylko sprawdź, bo od tego zależy rachunek. Na 250 tys. tokenów przetworzonego tekstu ta dopłata do polskości to ok. 64 tys. tokenów, czyli przy Haiku 5.5 ok. 2,5 grosza, przy Sonnecie 5.5 ok. 50 groszy, a przy Astrze ok. 2,50 zł za samo wejście.
Limity czatów i komunikaty o błędach
Okno kontekstowe, o którym piszę osobno, też liczone jest w tokenach i mieści zarówno twoje wiadomości, historię rozmowy, instrukcje systemowe, jak i odpowiedź modelu. Aktualne okna wyglądają tak: rodzina GPT-6 (Astra, Sol, Luna) dostaje 1,05 mln tokenów kontekstu i maksymalnie 128 tys. na wyjście, Claude Sonnet 5.5 i Haiku 5.5 mają po 1 mln tokenów i 128 tys. na wyjście, Gemini 4 Argon pracuje na 1 mln tokenów, a Gemini 3.8 Flash na 1 048 576 tokenów wejścia z wyjściem do 65 536. Przy moim akapitowym przeliczniku pół słowa na token milion tokenów odpowiada mniej więcej pół miliona słów po polsku, więc o wyjście poza okno nietrudno przy długich dokumentach wklejonych w całości.
Komunikaty błędów mówią wprost o tokenach. Anthropic zwraca błąd 400 z treścią „prompt is too long”, gdy samo wejście przekracza okno, a gdy wejście razem z zadeklarowanym limitem wyjścia nie mieści się w oknie, nowsze modele przerywają pracę z powodem model_context_window_exceeded. Pomoc OpenAI opisuje to ogólniej: okno kontekstowe ogranicza tokeny dostępne w żądaniu, modele mają też osobny limit wyjścia, a przy zbyt dużym wejściu zaleca skrócenie promptu, podział na mniejsze części albo wcześniejsze streszczenie. Limit wyjścia poznasz po tym, że odpowiedź urywa się w połowie zdania, i po parametrze max_tokens w API, który ten sufit ustawia.
Limitów czatów subskrypcyjnych (plany darmowe i płatne) żaden z trzech producentów nie publikuje w tokenach, więc ich równoważników nie podam, bo nie ma ich gdzie odczytać. Pewne jest jedno: dłuższe prompty i dłuższe odpowiedzi to więcej tokenów w tej samej liczbie wiadomości, więc dowolna pula zużycia kończy się szybciej niż przy krótkich wymianach.
Jak policzyć tokeny samemu
Najprościej użyć kalkulatora OpenAI pod adresem platform.openai.com/tokenizer. Strona jest darmowa i nie wymaga logowania: wklejasz tekst, a narzędzie pokazuje, na jakie porcje tokenizer go tnie, plus liczniki tokenów i znaków. Przy okazji zobaczysz na własne oczy, jak polskie słowa rozpadają się na kawałki, które w angielskim byłyby całymi słowami. Jedno zastrzeżenie: kalkulator operuje encodingami starszych rodzin modeli OpenAI, więc dla najnowszych wynik może się nieznacznie różnić od rachunku producenta.
Dla programistów ta sama biblioteka tiktoken (instalacja przez pip install tiktoken) liczy tokeny lokalnie w kilku linijkach pythona, a w świecie JavaScript istnieje odpowiednik @dqbd/tiktoken. Anthropic udostępnia darmowe zapytanie count_tokens, które zwraca szacunek zużycia przed wysłaniem wiadomości i przydaje się, gdy chcesz oszacować koszt większego przetworzenia.
Nota o teście
Pomiar wykonałem 14.10.2026 lokalnie, na własnym komputerze, bez wysyłania testowanych tekstów do żadnego API. Użyłem biblioteki tiktoken w wersji 0.14.0 (Python 3.10) z dwoma encodingami: o200k_base i cl100k_base. Materiał to dziesięć par słów polsko-angielskich, jedno zdanie (142 znaki, 21 słów) i akapit (298 znaków, 47 słów, cztery zdania); wersję angielską akapitu i zdania przetłumaczyłem sam wyłącznie po to, żeby mierzyć tę samą treść w dwóch językach. Tiktoken nie ma jeszcze przypisanego encodingu dla modeli z rodziny GPT-6, więc przyjąłem o200k_base, którego biblioteka używa dla rodziny GPT-5; wyników traktuj jako rzędy wielkości, a nie deklaracje producenta.
Najczęstsze pytania
Ile tokenów ma jedno słowo?
Po angielsku średnio około 1,3 tokena na słowo, bo jeden token odpowiada trzem czwartym słowa. Po polsku z mojego pomiaru wychodzi średnio około dwóch tokenów na słowo w akapicie, przy czym krótkie słowa funkcyjne typu „i” albo „że” mieszczą się w jednym, a trudne z diakrytykami zajmują cztery albo pięć.
Dlaczego polski kosztuje więcej tokenów niż angielski?
Słownik tokenizera powstaje z korpusów, w których angielski dominuje, więc polskie znaki i odmiana to rzadkie fragmenty cięte drobniej. Na moim akapicie różnica wyniosła 34 procent w nowszym tokenizercie i 51 procent w starszym.
Co znaczy komunikat o przekroczeniu limitu tokenów?
Że rozmowa albo zapytanie nie mieści się w oknie kontekstowym, albo odpowiedź dobija do limitu wyjścia. Pomaga nowa rozmowa, skrócenie wklejanych materiałów albo ich streszczenie przed wysłaniem, a w API także ustawienie parametru max_tokens.
Ile kosztuje jeden token?
Zawsze ułamek grosza: od 0,0000004 zł przy najtańszym wejściu (GPT-6 Luna i Claude Haiku 5.5, 0,10 USD za 1 mln) do 0,0002 zł przy najdroższym wyjściu (GPT-6 Astra, 50 USD za 1 mln), przy kursie NBP z 14.10.2026. Rachunek nabiera rozmiaru dopiero przy milionach tokenów.
Czy da się płacić mniej za tokeny?
Da się, głównie skracając to, co wysyłasz: streszczenie zamiast pełnego dokumentu, osobne rozmowy na osobne tematy, tańszy model do prostych zadań. Do tego dochodzi czekanie na koniec cen intro, bo stawki Gemini 4 Argon i 3.8 Flash są okresowe i po ich wygaśnięciu ten sam prompt kosztuje podwójnie albo więcej.
Źródła
- OpenAI (centrum pomocy), What are tokens and how to count them: https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- OpenAI, Tokenizer (narzędzie do podziału tekstu): https://platform.openai.com/tokenizer
- OpenAI, API pricing: https://developers.openai.com/api/docs/pricing
- OpenAI, Models (okna kontekstowe): https://developers.openai.com/api/docs/models
- Anthropic, Pricing: https://platform.claude.com/docs/en/about-claude/pricing
- Anthropic, Models overview: https://platform.claude.com/docs/en/about-claude/models/overview
- Anthropic, Glossary: https://platform.claude.com/docs/en/resources/glossary
- Anthropic, Context windows: https://platform.claude.com/docs/en/build-with-claude/context-windows
- Anthropic, Token counting: https://platform.claude.com/docs/en/build-with-claude/token-counting
- Google AI, Gemini API pricing: https://ai.google.dev/gemini-api/docs/pricing
- Google AI, Gemini models: https://ai.google.dev/gemini-api/docs/models
- NBP, kurs średni dolara amerykańskiego z 14.10.2026: https://api.nbp.pl/api/exchangerates/rates/a/usd/
- Własny pomiar biblioteką tiktoken 0.14.0 z 14.10.2026