Model multimodalny to model, który przyjmuje więcej niż tekst: obraz, dźwięk, a u Google także wideo i PDF, i coraz częściej coś takiego potrafi też zwrócić. Jeszcze niedawno czaty AI kojarzyły się z okienkiem na pisanie, dziś wrzucasz do niego zrzut ekranu, nagranie ze spotkania albo zdjęcie faktury i pytasz po polsku. Sprawdziłem w dokumentacjach OpenAI, Google i Anthropica (odczyty z 15.10.2026), co dokładnie przyjmują i zwracają GPT-6, Gemini 4 i Claude, ile to kosztuje przy poważniejszych zadaniach i gdzie te modele wciąż zawodzą. Dowiesz się też, co dostajesz w planach darmowych, a co producent wycina dopiero w płatnych. Jeśli dopiero wchodzisz w temat AI, dobrą bazą jest Podstawy AI, hub całej serii, a ten tekst traktuj jako rozdział o zmysłach.
- Co to znaczy, że model jest multimodalny?
- Jak model widzi obraz i słyszy dźwięk?
- Które modele naprawdę przyjmują obraz, dźwięk i wideo?
- Jakie zadania multimodalność zmienia na co dzień?
- Gdzie multimodalność się wali?
- Ile kosztuje multimodalność?
- Jak zacząć bez płacenia?
- Czy da się poznać, że obraz albo nagranie zrobiła AI?
- Najważniejsze informacje
- Najczęstsze pytania
Co to znaczy, że model jest multimodalny?
Modalność to po prostu kanał informacji: tekst, obraz, dźwięk, wideo. Model multimodalny obsługuje więcej niż jeden taki kanał, najczęściej jako wejście, czyli to co mu wrzucisz, a przy generatywnych modelach także jako wyjście. Słowo przyszło z łaciny (modus, sposób) i pierwotnie opisywało uczenie maszynowe łączące dane z różnych źródeł, więc nie jest to wymysł marketingu, choć marketing chętnie się go łapie.
W praktyce termin bywa rozciągany. Czysty model językowy, czyli LLM, operuje na tekście i na tym kończy; tłumaczymy go szerzej w tekście co to jest LLM. Producent może za to nazwać produkt multimodalnym wtedy, gdy pod spodem pracuje kilka wyspecjalizowanych modeli: jeden widzi obraz, drugi słyszy, trzeci mówi. Z perspektywy użytkownika różnica jest akademicka, ale z punktu widzenia tego, co naprawdę dostajesz w abonamencie, robi się istotna. Właśnie dlatego w dalszej części oddzielam modele, które same przyjmują obraz czy dźwięk, od funkcji doklejonych obok nich.
Jak model widzi obraz i słyszy dźwięk?
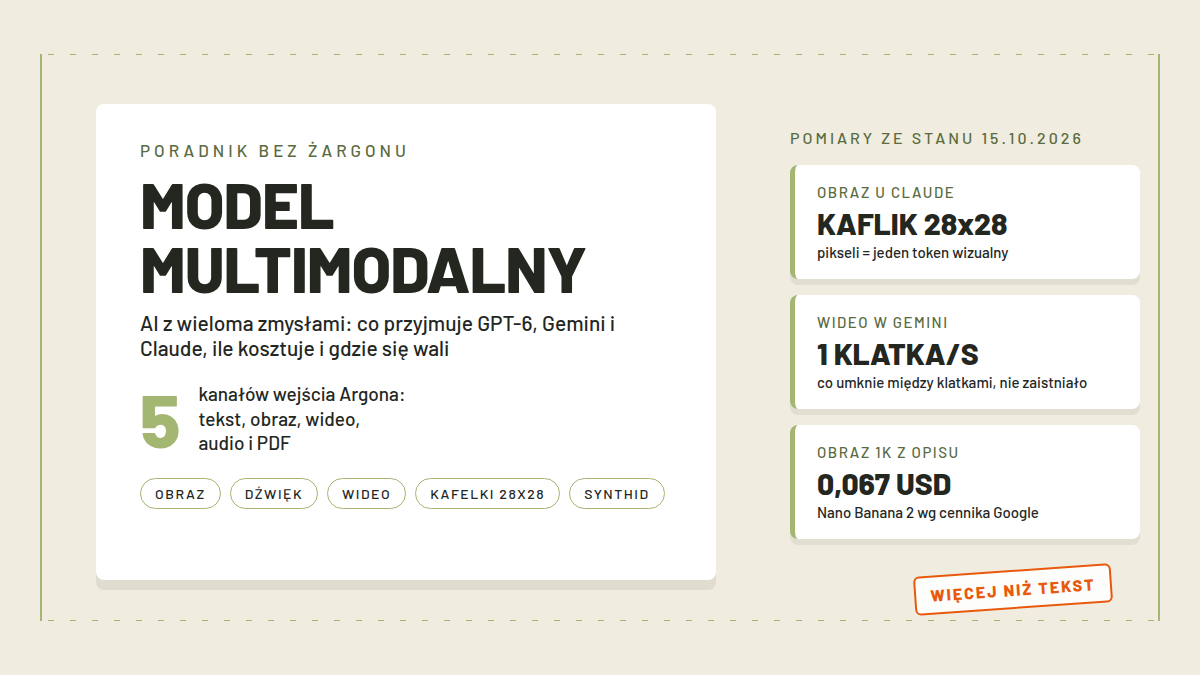
Model nie patrzy na zdjęcie tak jak człowiek. Obraz jest cięty na małe kafelki i każdy z nich zamieniany na liczby, na tokeny, czyli tę samą walutę, w której liczony jest tekst. Dokumentacja Anthropica opisuje to wprost: Claude widzi obraz w kafelkach 28×28 piksela, jeden taki kwadrat to jeden token wizualny, a koszt całego zdjęcia to szerokość podzielona przez 28 razy wysokość podzielona przez 28 (odczyt 15.10.2026). OpenAI w swoim przewodniku wizji też rozkłada obraz na kafelki 512 pikseli i dolicza do nich pulę tokenów bazowych. Skutek dla ciebie: wklejenie obrazu kosztuje, dosłownie, bo im większa grafika, tym więcej tokenów i tym wyższy rachunek w API.
Z dźwiękiem jest podobnie, tylko że próbkowanie działa w czasie. Gemini liczy audio w tempie 25 tokenów na sekundę nagrania, a wideo w trybie statycznym ogląda z częstotliwością jednej klatki na sekundę (dokumentacja Google, odczyt 15.10.2026). To ważne tłumaczenie na ludzki język: model nie przewija filmu od początku do końca jak człowiek z pilotem, tylko patrzy na wybrane klatki jak na stertę zdjęć ułożonych co sekundę. Co umknęło między klatkami, dla modelu nie zaistniało. Z tego wynika sporo ograniczeń, do których wracam w sekcji o słabościach.
Które modele naprawdę przyjmują obraz, dźwięk i wideo?
Stan na 15.10.2026 wg kart modeli wygląda tak: Gemini 4 Argon od Google przyjmuje najwięcej, bo tekst, obraz, wideo, audio i PDF, ale zwraca wyłącznie tekst. Rodzina GPT-6 od OpenAI (Astra, Sol, Luna) przyjmuje tekst i obraz, a wiersze audio i wideo mają w kartach oznaczone jako „Not supported”. Claude od Anthropica przyjmuje tekst i obraz, zwraca tekst, i w dokumentacji wprost napisano, że nie generuje obrazów.
| Rodzina (API) | Wejście | Wyjście |
|---|---|---|
| GPT-6 Astra, 6.1 Sol, 6 Luna | tekst, obraz | tekst |
| Gemini 4 Argon | tekst, obraz, wideo, audio, PDF | tekst |
| Claude (Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1) | tekst, obraz | tekst |
Zauważ, że „multimodalność” wyjściowa to zwykle osobne modele doklejone do tego, który rozmawia. U OpenAI głos prowadzi GPT-Realtime-1.5 opisywany jako „audio in, audio out”, mowa z tekstu to GPT-4o Mini TTS, a obrazy generuje GPT-Image-2.5 Sunburst. U Google obrazy robi Nano Banana 2.1, wideo Gemini Omni Flash i Veo, mowę Gemini 3.8 Flash TTS. Argon jest tu wyjątkowy, bo sam łyka wszystkie wejścia naraz. Moim zdaniem właśnie ta konstrukcja „jednego modelu z wieloma oczami” będzie w kolejnych latach głównym polem rywalizacji, bo upraszcza aplikacje i obniża liczbę zapytań.
Druga rzecz, o której karty mówią wprost: najnowszy model nie trafia od razu wszędzie. Argona nie ma w darmowym tierze API Google, ani w warstwie API planu Google AI Pro, a w aplikacji Gemini jest dopiero od planu Pro w górę (odczyty 15.10.2026). U OpenAI w planie Free ChatGPT rozmawiasz z Luną, a Astra jest zarezerwowana dla Plus i Pro. Multimodalność bywa więc również kwestią abonamentu, nie tylko techniki.
Jakie zadania multimodalność zmienia na co dzień?
Pierwsze to opisywanie i sprawdzanie tego, co widzisz na ekranie. Komunikat błędu, który nie chce się wyszukać w Google, ponieważ jest zbitką z różnych okien, wrzucasz jako zrzut i prosisz o wyjaśnienie. Dokumentacja wizji OpenAI opisuje takie użycie wprost: model opisuje obrazy, czyta widoczny tekst i odpowiada na pytania o obiekty, kształty i kolory (odczyt 15.10.2026). U Claude w dokumentacji pojawia się to samo plus analiza wykresów i wyciąganie danych z formularzy.
Drugie zadanie to dokumenty, które są w połowie obrazem. Faktura ze skanu, umowa jako PDF ze skanem podpisu, tabela sfotografowana z ekranu. Argon przyjmuje PDF jako wejście, więc nie musisz nic konwertować przed pytaniem. Trzecie to dźwięk: Gemini 3.5 Transcribe robi transkrypcję z rozpoznawaniem mówców i znacznikami czasowymi słów, czyli z nagrania spotkania dostajesz tekst z podziałem na to, kto co powiedział. Po stronie OpenAI ta sama praca kosztuje od 0,003 do 0,006 dolara za minutę nagrania w modelach transkrypcyjnych (cennik API, 15.10.2026).
Czwarte zadanie idzie w drugą stronę, z tekstu w zmysły. Obraz z opisu generuje Sunburst u OpenAI i Nano Banana u Google, mowę z tekstu modele TTS obu firm, a Veo i Omni Flash dorzucają wideo. To brzmi jak spis katalogowy, ale w codziennej pracy znaczy tyle, że jedno okno załatwia sprawę, do której dawniej potrzebowałeś osobnych serwisów. Po polsku odpowiedniki darmowe opisałem osobno, przy generowaniu obrazów w tekście obrazki AI za darmo i przy mowie w tekst na mowę za darmo. Zaznaczam uczciwie: powyższe przykłady opieram na opisach producentów, nie na moich testach, bo żadnego z tych modeli na własnych plikach nie odpalałem.
Gdzie multimodalność się wali?
Liczenie. Obie dokumentacje, OpenAI i Anthropic, piszą to samo językiem niemal identycznym: model podaje przybliżoną liczbę obiektów na zdjęciu i potrafi się pomylić, szczególnie przy wielu małych elementach (odczyty 15.10.2026). Zapytany o dwadzieścia śrubek na zdjęciu warsztatu zwróci liczbę pewnym tonem, a pewność nie jest gwarancją poprawności. Jeśli liczba ma się zgodzić z fakturą albo ze stanem magazynu, licz ręcznie albo programowo.
Drobny tekst i tekst obrócony. OpenAI każe powiększać napisy na obrazie, żeby model je przeczytał, i przyznaje, że obrócony albo do góry nogami tekst bywa błędnie odczytany. Anthropic dodaje halucynacje przy obrazach poniżej 200 pikseli. Google ma parametr media_resolution, który podbija rozdzielczość klatek właśnie po to, by czytać drobny tekst, co samo w sobie jest przyznaniem, że domyślnie bywa z tym słabo. Przy polskich napisach na zrzutach sprawa jest ciekawa: żadna z trzech dokumentacji nie wymienia polskiego wprost jako słabości. OpenAI wskazuje tekst w alfabetach niełacińskich, jak japoński czy koreański, a polskie znaki diakrytyczne są łacińskie, więc formalnie poza zapisaną wadą. Czy model zawsze dobrze przeczyta „żółć” na drobnym screenie, nie podano, więc traktuj takie odczyty jak wersję roboczą do sprawdzenia.
Wideo i kontekst specjalny. Jedna klatka na sekundę oznacza, że szybkie ruchy i cięcia montażowe umykają, co dokumentacja Gemini przyznaje wprost. W darmowym tierze API Google obejrzysz jedno wideo dziennie, a plik nie może przekroczyć 2 GB. Do tego dochodzą granice celowe, nie techniczne: Claude odmawia nazywania ludzi na zdjęciach, OpenAI blokuje CAPTCHA-e, oba producenty odradzają interpretację obrazów medycznych typu tomografia. Anthropic pisze też coś, co warto mieć w głowie przy deepfake’ach: Claude nie potrafi stwierdzić, czy obraz jest generowany przez AI, i może się mylić, gdy się go o to zapytasz.
Ile kosztuje multimodalność?
W API płaci się tokenami, a tokeny za obraz i dźwięk potrafią zaskoczyć. Flagowy Argon kosztuje 2 dolary za milion tokenów wejścia i 10 dolarów za wyjście, ale to cena promocyjna tylko do 30.11.2026, potem 4 i 20 dolarów (cennik Google, odczyt 15.10.2026). Po drugiej stronie skali Luna od OpenAI bierze 0,1 dolara za wejście i 0,5 za wyjście, więc wklejenie zdjęć do taniego modelu nie zrujnuje budżetu. Kilka orientacyjnych pozycji za konkretne zadania zestawiam poniżej.
| Zadanie w API | Model | Stawka (odczyt 15.10.2026) |
|---|---|---|
| Transkrypcja minuty nagrania | gpt-transcribe | 0,0045 USD |
| 10 sekund mowy z tekstu | Gemini 3.8 Flash TTS | 0,00225 USD |
| Obraz 1K z opisu | Nano Banana 2 | 0,067 USD |
| Sekunda wideo z dźwiękiem | Veo 3.1 (720p) | 0,40 USD, Fast 0,10 USD |
W planach konsumenckich obraz i dźwięk są zwykle wliczone, tylko cięte limitami. ChatGPT w planie Free ma „Limited image creation” i „Limited voice chats”, Go zwiększa te limity, a Pro obiecuje tworzenie obrazów bez limitu (cennik ChatGPT, odczyt 15.10.2026). Claude w planie Free za 0 dolarów daje do ręki modele Sonnet i Haiku razem z wizją, Pro kosztuje 17 dolarów miesięcznie przy płatności rocznej albo 20 przy miesięcznej, a Max zaczyna się od 100 dolarów. Plany Google AI (Plus, Pro, Ultra) różnią się dostępem do Argona i pulą generowania obrazu, muzyki i wideo. Kwot w złotówkach z kart cenników nie podam, bo w moim odczycie z 15.10.2026 kwoty renderowały się skryptem i pola pozostały puste, zamiast zgadywać piszę „nie podano”.
Jak zacząć bez płacenia?
Trzy ścieżki wejścia są realne. Pierwsza: darmowy ChatGPT, którego cennik z 15.10.2026 chwali się napisem „Unlimited text chats”, a obrazy, głos i przesyłanie plików wyraźnie ogranicza; pomoc OpenAI zastrzega przy tym, że limity użycia bywają i nie zawsze je publikuje. Szczegóły tego, co dokładnie odcięto i dlaczego, rozpisałem w tekście GPT-6 za darmo. Druga: darmowy Claude, który według cennika obejmuje modele z wizją, więc możesz wrzucać zrzuty ekranu bez płaconego abonamentu.
Trzecia ścieżka to darmowy tier API Google, wygodny, jeśli wolisz własne skrypty. Tam część modeli głosowych, w tym transkrypcja i Live, ma wpisane „Free of charge”, a wideo obkładasz limitem jednego nagrania dziennie. Argona w tym tierze nie ma, dlatego do własnych testów multimodalnych bierzesz tańsze modele Flash. Co dokładnie oferuje darmowy plan aplikacji Gemini na telefonie, w moim odczycie kart nie widać, więc nie podano i nie zgaduję. Na marginesie: darmowe tiry zmieniają się często, przed poważniejszym projektem sprawdź cennik na dzień użycia, nie na dzień czytania artykułów, także tego.
Czy da się poznać, że obraz albo nagranie zrobiła AI?
Częściowo tak, dzięki znakom wodnym. Google SynthID osadza niewidoczny ślad w obrazach, audio, tekście i wideo generowanych przez narzędzia tej firmy; ślad ma przetrwać kadrowanie, filtry, zmianę liczby klatek i kompresję, a wykrywa go technologia SynthID, w tym w Gemini, Szukajce i Chrome (strona DeepMind, odczyt 15.10.2026). To dobre narzędzie, ale o zasięgu jednego producenta. Brak znaku niczego nie dowodzi, bo nie każdy generator znakuje treści, a Claude jak wspomniałem wyżej nie wykrywa syntetycznych obrazów w ogóle.
Zielone światło mają więc tylko treści z potwierdzonym znakiem, resztę oceniaj po okolicznościach: źródło, jakość detali, kontekst publikacji. Po polsku napisałem o tym osobny poradnik jak sprawdzić, czy zdjęcie jest z AI, z narzędziami, które działają też na materiałach z innych firm. Do tego dochodzi granica polityczna, którą Anthropic ustawił swoim modelom: nie nazywają ludzi na zdjęciach. Dla prywatności to zaleta, dla dziennikarza śledczego przeszkoda, ale taka jest instrukcja obsługi.
Najważniejsze informacje
| Co | Stan wg dokumentacji | Odczyt |
|---|---|---|
| GPT-6 (Astra, Sol, Luna) | wejście: tekst i obraz, wyjście: tekst | 15.10.2026 |
| Gemini 4 Argon | wejście: tekst, obraz, wideo, audio, PDF | 15.10.2026 |
| Claude (4 modele) | wejście: tekst i obraz, wyjście: tekst | 15.10.2026 |
| Liczenie obiektów | wynik przybliżony, może być błędny | 15.10.2026 |
| Drobny tekst na obrazie | słaby punkt, powiększ przed wysłaniem | 15.10.2026 |
| Wideo w Gemini | 1 klatka na sekundę, darmowe API: 1 wideo dziennie | 15.10.2026 |
| Argon w API | 2 USD do 30.11.2026, potem 4 USD za 1M wejścia | 15.10.2026 |
| Free ChatGPT | teksty „unlimited” wg cennika, obrazy i głos „limited” | 15.10.2026 |
Najczęstsze pytania
Model multimodalny co to?
Model sztucznej inteligencji, który obsługuje więcej niż jeden kanał informacji, czyli poza tekstem także obraz, dźwięk, wideo albo PDF. Większość dziś sprzedawanych modeli przyjmuje te dane jako wejście, a zwraca tekst. Generowanie obrazu czy mowy realizują zwykle osobne modele od tego samego producenta.
Multimodalny model AI co to znaczy w praktyce?
Znaczy, że możesz wkleić zrzut ekranu, zdjęcie albo nagranie i zadać pytanie po polsku, a model odniesie się do treści tego pliku. Wg kart z 15.10.2026 GPT-6 i Claude przyjmują obrazy, a Gemini 4 Argon dodatkowo wideo, dźwięk i PDF. W praktyce oznacza to też mniejszą liczbę narzędzi, bo opis, transkrypcja i rozmowa odbywają się w jednym oknie.
Czy ChatGPT widzi obrazy?
Tak. Wg cennika ChatGPT (odczyt 15.10.2026) plan Free ma ograniczoną pulę obrazów i przesyłania plików, plany Go i wyżej podnoszą limity, a funkcja głosu z wideo wymaga już Go lub wyższego planu. Przez API obraz przyjmuje każda z modeli GPT-6, zwracając odpowiedź tekstem.
Czy Gemini jest multimodalny?
Tak i to w najszerszym zakresie wśród dużych rodzin. Gemini 4 Argon przyjmuje tekst, obraz, wideo, audio i PDF (karta modelu Google, odczyt 15.10.2026). Dostaniesz go w aplikacji od planu Google AI Pro w górę, natomiast w darmowym tierze API i warstwie API planu Pro jest niedostępny.
Czy AI generuje wideo za darmo?
Po stronie API nie, Veo 3.1 i Gemini Omni Flash mają wyłącznie ceny płatne, od 0,05 do 0,60 dolara za sekundę w zależności od wariantu i rozdzielczości (cennik Google, odczyt 15.10.2026). W planach konsumenckich darmowych tego nie potwierdziłem, karty cenników w moim odczycie nie pokazywały generowania wideo w planie Free, więc piszę wprost: nie podano. Plany płatne Google deklarują dostęp do generowania wideo w puli limitów.
Źródła
- Karta modeli OpenAI, opis rodziny GPT-6 i modalności, odczyt 15.10.2026: https://platform.openai.com/docs/models
- Karta modelu GPT-6 Astra, wiersz Modalities (audio i wideo: Not supported), odczyt 15.10.2026: https://platform.openai.com/docs/models/gpt-6-astra
- Cennik API OpenAI (transkrypcja, modele obrazów), odczyt 15.10.2026: https://platform.openai.com/docs/pricing
- Przewodnik Images and vision, sekcja Limitations, odczyt 15.10.2026: https://platform.openai.com/docs/guides/images-vision
- Karta modelu Gemini 4 Argon, wejścia i wyjścia, odczyt 15.10.2026: https://ai.google.dev/gemini-api/docs/models/gemini-4-argon
- Cennik Gemini API (Argon, Veo 3.1, TTS, Live, transkrypcja), odczyt 15.10.2026: https://ai.google.dev/gemini-api/docs/pricing
- Dokumentacja video understanding Gemini (1 FPS, tryb agentic, limity), odczyt 15.10.2026: https://ai.google.dev/gemini-api/docs/video-understanding
- Przegląd modeli Gemini (Nano Banana, Omni Flash, Transcribe, Embedding 2), odczyt 15.10.2026: https://ai.google.dev/gemini-api/docs/models
- Przegląd modeli Claude (wejścia, wyjścia, ceny API), odczyt 15.10.2026: https://platform.claude.com/docs/en/about-claude/models/overview
- Dokumentacja wizji Claude (kafelki 28×28, sekcja Limitations), odczyt 15.10.2026: https://platform.claude.com/docs/en/build-with-claude/vision
- Cennik ChatGPT (plan Free, Voice, Vision, Image generation), odczyt 15.10.2026: https://chatgpt.com/pricing
- Cennik Claude (plan Free, Pro, Max, dostępność modeli), odczyt 15.10.2026: https://claude.com/pricing
- Plany Google AI (Plus, Pro z Argonem, Ultra), odczyt 15.10.2026: https://one.google.com/about/google-ai-plans/
- Strona SynthID, znaki wodne w obrazach, audio, tekście i wideo, odczyt 15.10.2026: https://deepmind.google/science/synthid/