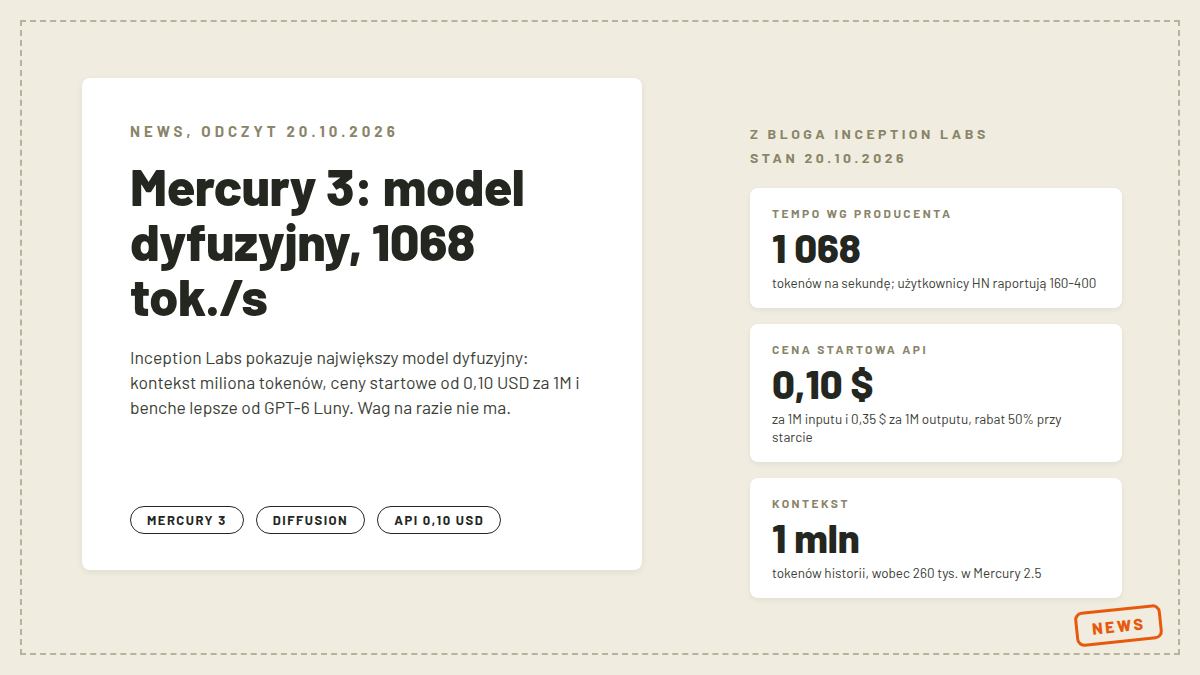
19 października 2026 startup Inception Labs opublikował Mercury 3, nową generację swoich modeli dyfuzyjnych. Deklaracje są mocne: według Inception Labs to „najzdolniejszy dyfuzyjny LLM wydany do tej pory”, lepszy na liście benchmarków od GPT-6 Luny i Claude Haiku 5.5, a do tego działający z prędkością 1068 tokenów na sekundę na NVIDIA. Model jest ponad 40 razy większy od Mercury 1 z lutego 2025 i ma kontekst miliona tokenów zamiast 260 tys. w Mercury 2.5.
Jeśli te liczby się potwierdzą, pierwszy komercyjny model dyfuzyjny realnie wchodzi na rynek szybkich i tanich modeli, gdzie do tej pory rządziła architektura autoregresyjna: tekst powstaje tam token po tokenie, od lewej do prawej.
W tym tekście: czym jest model dyfuzyjny, co pokazują benchmarki producenta, ile Mercury 3 kosztuje w złotówkach i dlaczego użytkownicy Hacker News radzą ostrożność.
- Najważniejsze informacje
- Czym jest model dyfuzyjny
- Co pokazują benchmarki wg Inception Labs
- Sceptycy z Hacker News
- Mercury 3 w Polsce: dostępność i ceny w złotówkach
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Premiera | 19 października 2026, wpis na blogu Inception Labs |
| Prędkość | 1068 tok./s na NVIDIA (deklaracja; na HN współzałożyciel mówi o Blackwellach) |
| Rozmiar | ponad 40 razy większy od Mercury 1, liczba parametrów niepodana |
| Kontekst | 1M tokenów (Mercury 2.5: 260K) |
| Ceny | 0,20 USD za 1M inputu i 0,70 USD za 1M outputu; na start rabat 50%: 0,10/0,35 USD |
| Kesz | tokeny z kesza 90% taniej od ceny inputu |
| Dostępność | API Inception, OpenRouter, Baseten, Vercel; zgodne z API OpenAI |
| Wagi | nieudostępnione; brak kart na Hugging Face |
Czym jest model dyfuzyjny
Modele dyfuzyjne zna każdy, kto generował obrazy w Stable Diffusion, Midjourney czy Sora. Dla tekstu to wciąż nowość: w lutym 2025 Inception Labs nazwało Mercury „pierwszą komercyjną rodziną dyfuzyjnych dużych modeli językowych” na świecie. Firmą kieruje Stefano Ermon, profesor Stanfordu zajmujący się modelami dyfuzyjnymi; w listopadzie 2025 TechCrunch pisał o rundzie seed 50 mln USD z Menlo Ventures.
Różnica wobec ChatGPT jest mechanizmowa. Model autoregresyjny pisze jak maszyna do pisania: każdy kolejny token wymaga przejścia przez całą sieć, więc czas i koszt rosną z długością odpowiedzi. Model dyfuzyjny zaczyna od wersji „posypanej szumem” i w kilku krokach doszlifowuje całą odpowiedź naraz, poprawiając wiele tokenów równolegle. Współzałożyciele firmy porównują to do pracy edytora poprawiającego gotowy szkic.
Dla modeli rozumujących, które zużywają coraz więcej tokenów na jedno zapytanie, ta różnica rośnie z każdym miesiącem. Co dokładnie dzieje się między promptem a odpowiedzią, opisaliśmy w tekście co to jest inferencja.
Co pokazują benchmarki wg Inception Labs
Tabela wyników u producenta to obraz; przepisałem ją z pliku PNG. Inception Labs zestawia Mercury 3 (wszystkie trzy modele w wariancie Medium) z GPT-6 Luną i Claude Haiku 5.5, czyli, jak pisze wprost, z „frontier speed-optimized models”: modelami zoptymalizowanymi pod prędkość, nie z najcięższymi flagowcami. Na polu prędkości wynik jest bezdyskusyjny: 1068 tok./s wobec około 130 u Luny i około 240 u Haiku, choć deklarowane tokeny na sekundę to nie to samo, co czas reakcji odczuwany przez użytkownika (pisaliśmy o tym w LLMSpeed).
Na polu jakości tabela wygląda tak: GDPval (Elo) 1237,2 wobec 1204,0 dla Luny i 1225,0 dla Haiku, GPQA Diamond 89,23 wobec 86,36 i 84,51, SWE-Bench Atlas 51,08 wobec 33,33 i 32,26, BrowseComp+ 55,18. To liczby producenta, bez niezależnej replikacji w dniu premiery.
Ciekawsze są wiersze, w których Mercury 3 przegrywa, bo producent też je publikuje. W AA-Omniscience-Public Luna ma 46,94 do 46,44. W długim kontekście Haiku wygrywa MRCR v2 (78,40 do 75,50), a Luna AA-LCR v1.1 (78,30 do 77,67). W DeepSWE v1 Haiku ma 51,62 wobec 46,31. Obraz jest więc wyrównany, z lekką przewagą Mercury 3.
Drugi wykres pokazuje skalowanie: pięć generacji od Mercury 1 mini (luty 2025) do Mercury 3 (październik 2026), średnia z 11 benchmarków wzrosła 3x przy ponad 40-krotnym wzroście parametrów. Uwaga techniczna: oś jakości jest liniowa, oś rozmiaru logarytmiczna, a komentujący na HN chwycili to jako efektowną, ale wygodną prezentację. Z sekcji partnerów dochodzi wynik z agentów przeglądarkowych: 50% z 50 żywych zadań nawigacyjnych Mind2Web, więcej niż GPT-6.1-Sol, przy tej samej liczbie kroków i podobnym wolumenie tokenów.
Sceptycy z Hacker News
Wątek „Mercury 3: Diffusion at scale” z 19 października ma 252 punkty i 91 komentarzy (odczyt 20.10). Głos rozstrzygający należy do współzałożyciela firmy, który podpisał się tylko imieniem („Volodymyr, Inception Co-Founder & Chief Scientist”). Z jego odpowiedzi wynikają trzy rzeczy: wag nie ma i na razie nie będą, rozmiar modelu pozostaje tajemnicą, a na pytanie o przepustowość przy większych batchach przyszła odpowiedź bez liczb („jesteśmy zadowoleni ze skalowania”).
O batchu przypomniał LarsDu88: badania Google pokazywały topnienie zysków szybkości dyfuzyjnych modeli przy dużych batchach na H100, czyli tam, gdzie serwer obsługuje wielu użytkowników naraz. W podwątku o Diffusion Gemma inny komentujący dodał, że dyfuzyjne modele korzystają z batchowania słabiej niż autoregresyjne: są tanie przy pojedynczym użytkowniku i droższe na skali. To ważny kontekst dla ceny 0,10 USD: jak zauważył LarsDu88, cena bywa ustawiana poniżej kosztu, zwłaszcza w firmie prywatnej.
Realne pomiary są niższe niż 1068: Escapado raportował około 160 tok./s w 45-minutowej sesji pod macOS, ilitirit 300-400 tok./s, a Simon Willison wygenerował swoją próbkę graficzną w 3337 ms i ocenił prędkość jako rozczarowującą. snake_doc porównał na OpenRouter i uznał, że DeepSeek v4.1 Flash wciąż wygrywa latencją i jakością, a czas do pierwszego tokenu u Mercury jest wysoki.
Nie wszyscy są podirytowani: Escapado zbudował działające narzędzie w kwadrans, UncleOxidant po teście na własnym repo przyznał, że był miło zaskoczony, a 2001zhaozhao policzył, że Haiku 5.5 powyżej 100 tys. tokenów robi się 5 razy droższy, a Mercury 3 trzyma cenę do miliona. Sam współzałożyciel przyznał w wątku, że model „nie zastąpi jeszcze Opusa ani Fable jako głównego silnika” w agentach kodujących, ale sprawdza się przy subagentach. Difuzyjne modele mają na razie najlepszy układ marketingowy: mało kto może je zweryfikować bez własnej karty kredytowej.
Mercury 3 w Polsce: dostępność i ceny w złotówkach
Dostępność z Polski jest pełna: API Inception (platform.inceptionlabs.ai, zgodne z API OpenAI, program startowy z 100 mln darmowych tokenów), chat na stronie producenta albo OpenRouter, gdzie pozycja inception/mercury-3 ma w katalogu dokładnie ceny startowe 0,10 USD za 1M inputu i 0,35 USD za 1M outputu przy kontekście 1M (odczyt 20.10). W komunikatach producenta wymieniane są jeszcze platformy Baseten i Vercel.
Po przeliczeniu kursem średnim NBP z 20 października 2026 (3,8959 zł) ceny startowe wychodzą około 0,39 zł za milion tokenów wejściowych i 1,36 zł za milion wyjściowych. Po wygaśnięciu rabatu 50% będzie to około 0,78 zł i 2,73 zł. Tokeny z kesza, czyli powtórzone fragmenty kontekstu w rozmowie albo w pętli agenta, kosztują 90% mniej od ceny inputu. Milion tokenów outputu to startowo 1,36 zł, co przy agentach robiących dziesiątki wywołań na zadanie robi różnicę w rachunku (o rachunku API wobec abonamentu pisaliśmy w analizie kosztów ChatGPT).
Kto realnie skorzysta: twórcy voicebotów i czatu wsparcia, aplikacje edukacyjne z natychmiastową informacją zwrotną, agenci przeglądarkowi i masowe klasyfikacje. Kto nie: wszyscy liczący na model lokalnie, bo wag po prostu nie ma i nie wiadomo, czy będą.
Najczęstsze pytania
Czym jest model dyfuzyjny?
To model, który generuje tekst nie token po tokenie, tylko w kilku krokach poprawiania całej odpowiedzi naraz, startując od wersji zapełnionej szumem. Dzięki temu generuje wiele tokenów równolegle i szybciej odpowiada, choć jego jakość długo odstawała od modeli autoregresyjnych.
Czy Mercury 3 jest za darmo?
Nie, ale jest program startowy z 100 mln darmowych tokenów na API i darmowy chat na stronie producenta. Docelowe ceny to 0,20 USD za 1M tokenów inputu i 0,70 USD za 1M outputu, na start o połowę mniej.
Czy Mercury 3 ma otwarte wagi?
Nie. Współzałożyciel Inception Labs odpowiedział na HN wprost, że wag na razie nie udostępnią. Na Hugging Face nie ma żadnej karty Mercury ani organizacji Inception Labs (odczyt 20.10).
Ile Mercury 3 kosztuje w PLN?
Według kursu średniego NBP z 20 października 2026 (3,8959 zł) ceny startowe to około 0,39 zł za 1M tokenów wejściowych i 1,36 zł za 1M wyjściowych. Po rabacie 0,78 zł i 2,73 zł.
Czy Mercury 3 jest naprawdę taki szybki?
1068 tok./s to deklaracja producenta z układów NVIDIA. Użytkownicy z wątku HN raportowali 160-400 tok./s we własnych sesjach przy wysokim czasie do pierwszego tokenu, więc realne wrażenie zależy od dostawcy i konfiguracji.
Jak duży jest Mercury 3?
Nie ogłoszono. Wiadomo tylko, że jest ponad 40 razy większy od Mercury 1, a producent odmówił podania liczby parametrów w wątku na HN.
Źródła
- Blog Inception Labs, „Diffusion at Scale: Introducing Mercury 3” (deklaracje benchmarków, ceny, kontekst 1M, partnerzy, data premiery 19.10; odczyt 2026-10-20): https://www.inceptionlabs.ai/blog/introducing-mercury-3
- Wykres „Mercury 3: Benchmark results vs. models in its class” z bloga producenta (pełna tabela vs GPT-6 Luna Medium i Claude Haiku 5.5 Medium, przepisana z obrazu PNG; odczyt 2026-10-20): https://framerusercontent.com/images/YO5OXn25zt3KJBJkUxO2kAwmS6o.png
- Wykres „Model Quality vs. Model Size” z bloga producenta (pięć generacji, 40x parametrów, 3x jakości, średnia z 11 benchmarków; odczyt 2026-10-20): https://framerusercontent.com/images/uA54aGA7yoIF8XSjD3KfiSp9efs.png
- Wątek „Mercury 3: Diffusion at scale” na Hacker News, 252 punkty, 91 komentarzy (odpowiedzi współzałożyciela o wagach i batchu; testy użytkowników 160-400 tok./s; odczyt 2026-10-20 przez API Algolii): https://news.ycombinator.com/item?id=50155245
- Katalog OpenRouter (pozycja inception/mercury-3: 0,10/0,35 USD, kontekst 1M; odczyt 2026-10-20): https://openrouter.ai/inception/mercury-3
- Kurs średni USD NBP, tabela A nr 204/A/NBP/2026, 3,8959 zł z 20.10.2026 (odczyt 2026-10-20): https://api.nbp.pl/api/exchangerates/rates/a/usd/?format=json
- Blog Inception Labs, „Introducing Mercury 2.5” (kontekst 260K, ceny 0,20/0,75 USD, 1107 tok./s; odczyt 2026-10-20): https://www.inceptionlabs.ai/blog/introducing-mercury-2-5
- Blog Inception Labs, „Introducing Mercury” z lutego 2025 (pierwsza komercyjna rodzina dLLM, Mercury Coder Mini 1109 tok./s na H100; odczyt 2026-10-20): https://www.inceptionlabs.ai/blog/introducing-mercury
- Artykuł TechCrunch o rundzie 50 mln USD z 6.11.2025, przedruk na blogu Inception (Stefano Ermon, Menlo Ventures; odczyt 2026-10-20): https://www.inceptionlabs.ai/blog/inception-raises-50-million-to-build-diffusion-models-for-code-and-text
- Hugging Face, wyniki wyszukiwania „mercury” i „inception” przez API (brak kart modeli Inception Labs; odczyt 2026-10-20): https://huggingface.co/api/models?search=mercury