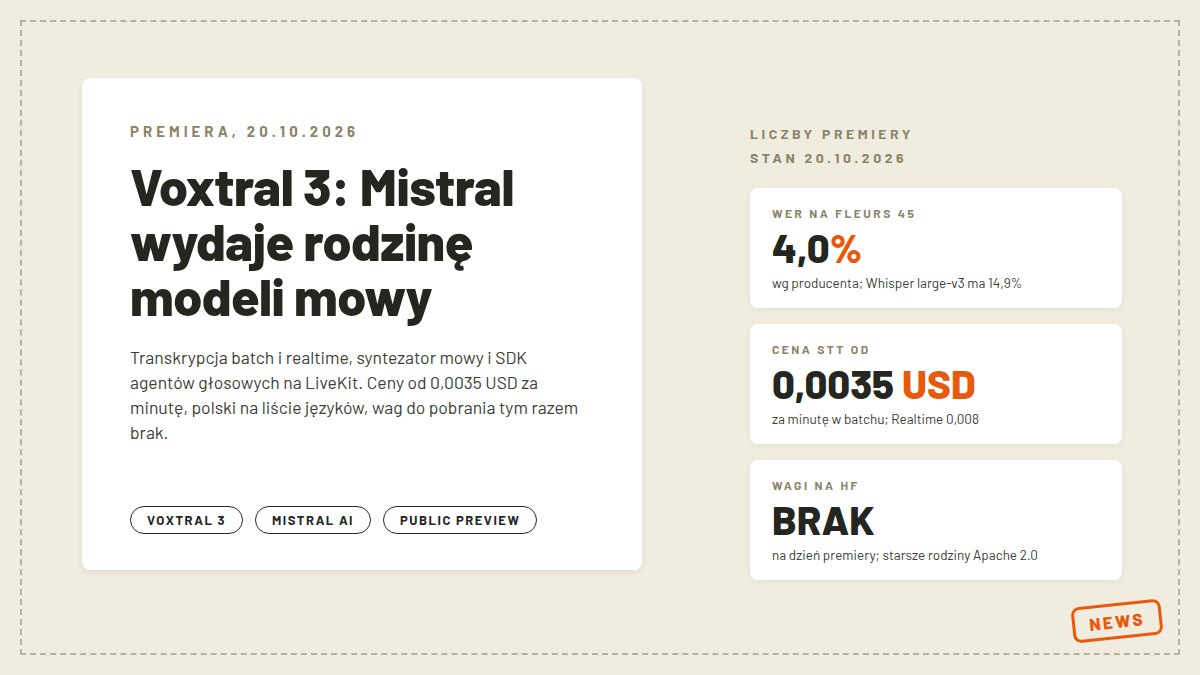
20 października Mistral AI wydał Voxtral 3, najnowszą generację swoich modeli mowy. To nie jeden model, tylko paczka: dwa modele transkrypcyjne (flagowy Small i 4-miliardowy Mini), wersja realtime z opóźnieniem poniżej 500 ms, syntezator mowy i zestaw narzędzi programistycznych do budowania agentów głosowych, które słuchają, myślą i odpowiadają w jednym potoku. Sprawdziłem ogłoszenie, karty modeli w dokumentacji i wątek na Hacker News, który w dwie godziny po publikacji zebrał ponad 350 punktów i ponad 90 komentarzy. Dla kogoś, kto zamienia mowę na tekst albo tekst na głos, liczą się trzy rzeczy: jakość ma być wyższa, ceny niskie, a polski jest na liście języków. Czwarte spostrzeżenie jest mniej przyjemne: wag do pobrania tym razem nie ma.
- Najważniejsze informacje
- Skąd się wzięła trójka
- Co dokładnie jest nowe
- Benchmarki: mocne, ale od producenta
- Ile to kosztuje i jak się dobrać
- Wagi: tym razem zamknięte, i to jest główna wiadomość dnia
- Voxtral 3 po polsku
- Najczęstsze pytania
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Premiera | 20 października 2026, status „Public Preview” w dokumentacji |
| Modele STT | Voxtral Small Transcribe 3 (flagowy), Voxtral Mini Transcribe 3 (4B parametry), Voxtral Mini Transcribe Realtime 3 |
| TTS | Voxtral Speech 3, 35+ języków, 50+ dialektów, klonowanie głosu od 30 minut nagrań |
| SDK agentów | Zbudowany na LiveKit: słuchanie, rozumowanie, wołanie narzędzi i mówienie w jednym potoku strumieniowym |
| Ceny STT | 0,0035 USD/min (Mini), 0,004 USD/min (Small), 0,008 USD/min (Realtime) |
| Cena TTS | 13 USD za 1 mln znaków, to samo API dla batch i realtime |
| Języki | Transkrypcja: 50 języków, w tym polski; TTS: 35+, presety głosów w 18 językach bez polskiego |
| Wagi i kontekst | Wag na Hugging Face brak na dzień publikacji; okno kontekstowe 32k (karty Mini i Small) |
Skąd się wzięła trójka
Mistral wszedł w mowę w lipcu 2025, kiedy pokazał Voxtrala jako „open source” modele do rozumienia mowy w dwóch rozmiarach, Mini 3B i Small 24B. Wagi trafiły na Hugging Face pod licencją Apache 2.0 i społeczność szybko zrobiła z nimi dziwy. Na przełomie stycznia i lutego 2026 przyszła fala druga: wagi Voxtral Mini 4B Realtime do transkrypcji na żywo trafiły na HF 21 stycznia, a Voxtral Transcribe 2 z lutego zebrał w wątku na Hacker News 1012 punktów. Realtime uruchomiono w czystym C na samym procesorze (implementacja antireza, 311 punktów na HN) i w przeglądarce w Ruście (401 punktów), a jeden z komentujących chwalił się komercyjną aplikacją na Windows, która na 4 GB VRAM przegania realny czas na laptopowym iGPU Ryzena 5 5600U. W marcu dołożyli Voxtral TTS z wagami na warunkach CC BY-NC 4.0, czyli nie do użytku komercyjnego.
To była rodzina otwarta, i na tym tle trójka zaskakuje. Premiera wpasowuje się w serię: kilka dni wcześniej wystartowała Timestral, prognozowa rodzina Mistrala, a wcześniej Mistral Large 4. Komentujący na HN podsumował to słowami, że Mistral ostatnio sypie wydaniami jak z rękawa i pytał, czy to tylko jego wrażenie. Nie jest, skoro przy okazji padła informacja o niedawnym zebraniu 3 mld dolarów finansowania.
Co dokładnie jest nowe
Cztery modele plus narzędzia. Small Transcribe 3 to flagowy model do zapisu mowy z diarizacją, czyli rozpoznawaniem, kto kiedy mówi, i z tzw. context biasing: dostajesz listę nazwisk, nazw produktów albo po prostu dowolny tekst, a model dopasowuje transkrypcję do tego słownika bez żadnego dostrajania. Mini Transcribe 3 robi to samo taniej i szybciej, a Realtime 3 pisze na żywo z opóźnieniem poniżej 500 ms w ponad 35 językach (karta modelu mówi nawet o 40+) i sam wykrywa, gdy rozmówca skończył myśl, łącząc sygnał akustyczny ze znaczeniem. To ostatnie brzmi jak szczegół, ale na tym w agentach głosowych wszystko się sypie: za wczesne ucinanie rozmówcy albo bezczynność przy każdej pauzie.
Voxtral Speech 3 syntetyzuje mowę w 35-plus językach i 50-plus dialektach, a jego głosy mają dobierać emocję, tempo i nacisk z kontekstu rozmowy, bez osobnych instrukcji. Wersja Pro potrafi skopiować charakterystykę mówcy z 30 minut nagrań. Drobiazg terminologiczny: ogłoszenie używa nazw „Voxtral Mini TTS 3” i „Voxtral Speech 3”, dokumentacja mówi o „Voxtral TTS 3”, chodzi o ten sam model.
Najciekawszy dla firm może być jednak zestaw SDK zbudowany na LiveKit. Potok wygląda tak: voxtral-mini-transcribe-realtime-3-0 słucha i wykrywa koniec wypowiedzi, ogólny model językowy, na przykład Mistral Small, rozumuje i woła narzędzia (wyszukiwarka, funkcje, wyszukiwanie po własnych systemach), a Speech 3 odpowiada głosem nastrojonym do rozmowy. Każda tura zamyka się poniżej sekundy, agent przerywa, gdy klient go ucina, i da się go podpiąć do telefonii przez SIP albo do przeglądarki przez WebRTC.
Benchmarki: mocne, ale od producenta
Mistral deklaruje, że Small Transcribe 3 jest aktualnie najlepszy w transkrypcji wielojęzycznej i „przebija Whispera, Scribe v2 i Gemini 3.5 Transcribe”. Na makrośredniej WER z benchmarku FLEURS w 45 językach Small ma 4,1% przy wymuszonej deklaracji języka i 4,0% przy auto-detekcji, podczas gdy Whisper large-v3 ma w tej samej tabeli 16,0% i 14,9%. W diarizacji (cpWER na zbiorach AMI i Switchboard) Small ma 18,4%, Mini 18,6%, punkt odniesienia Pyannote 19,0%, a poprzednia generacja Mini 30,9%, więc progres jest widoczny. Context biasing robi robotę: po podaniu modelowi słownika recall terminów na zbiorze Earnings-22 rośnie z 81,4% do 94,6%.
W realtimie liczby są ciekawe dla każdego, kto buduje agenta: Mini Realtime 3 osiąga 5,7% WER przy opóźnieniu 2400 ms i 7,4% przy 240 ms, gdzie GPT Live Transcribe ma 8,4%, a Scribe v2 Realtime 8,7%. Offline baseline tego samego Mini to 4,0%, a Gemini 3.5 Realtime Transcribe ma 4,2%, więc przewaga nad konkurencją w realtimie nie wygląda tak, jak w tabelach batchowych.
Dwa zastrzeżenia. Po pierwsze, wszystkie te liczby pochodzą od producenta; wykresy porównawcze TTS mają w podpisach datę wygenerowania 20 października i sędziego w postaci modelu gemini-3.8-flash, a niezależnych pomiarów na dzień publikacji nie znalazłem. Po drugie, komentarze na HN przypominają, że WER na FLEURS to czyste nagrania z jedną osobą przed mikrofonem. Jeden z dyskutujących przekornie broni Whispera: to model transkrypcyjny, a nie do dytowania, jedyny, który próbuje złapać wszystko z trudnego materiału typu monitoring, kosztem wyższego WER i halucynacji tam, gdzie nikt nie mówi. Inny narzekał po odsłuchaniu klipów porównawczych na stronie, że głosy z trójki brzmią bardziej sztucznie i generycznie niż te z wersji pierwszej, które jego zdaniem brzmiały jak prawdziwi ludzie. Ja modelu nie odsłuchiwałem, oceniać brzmienia nie będę.
Ile to kosztuje i jak się dobrać
Cennik jest prosty i w dolarach. Mini Transcribe 3 w batchu kosztuje 0,0035 USD/min, Small Transcribe 3 0,004 USD/min, Mini Transcribe Realtime 3 0,008 USD/min. Voxtral Speech 3 kosztuje 13 USD za milion znaków wejścia, batch i realtime przez to samo API. Model identyfikujesz w API przez voxtral-small-transcribe-3-0 dla flagowej transkrypcji, przez voxtral-mini-transcribe-3-0 dla Mini, przez voxtral-mini-transcribe-realtime-3-0 dla realtime oraz przez voxtral-mini-tts-3-0 dla syntezatora; transkrypcja idzie przez endpoint /v1/audio/transcriptions z obsługą znaczników czasu. Karty modeli w dokumentacji podają okno kontekstowe 32k dla Mini i Small, a maksymalnej długości pojedynczego pliku audio wprost nie podano. Wszystkie modele mają status „Public Preview”, a karty w dokumentacji noszą datę 20 października 2026, więc to nie jest jeszcze produkt uznany za stabilny.
Mistral serwuje API z endpointów europejskich, amerykańskich i globalnych, a brukselska publiczność doceni zapewne akcent na hosting w UE i „suwerenność danych”.
Wagi: tym razem zamknięte, i to jest główna wiadomość dnia
Tu jest sedno dla czytelników, którzy znają Voxtrala z lokalnych wdrożeń. Na dzień publikacji wagi nie ma nigdzie: organizacja mistralai na Hugging Face nie ma żadnego repozytorium z trójką (najnowsze pozycje to wariant arabski Realtime z 8 października i modele Timestral), ogłoszenie nie wymienia ani Hugging Face, ani licencji, a dokumentacja oznacza nowe modele etykietą „Premier” bez znacznika licencji, w odróżnieniu od starszych pozycji z wprost wpisanym Apache 2.0 i CC BY-NC 4.0. Deklarowane „self-deployment on your own infrastructure” znaczy tyle, że pełny stack u siebie postawisz po rozmowie ze sprzedażą, nie przez git clone.
Na Hacker News to wykryto w minutę. Najwyżej oceniony komentar brzmiał, że zamknięty model to ciąg dalszy historii, w której TTS i STT kiepsko się mają do lokalnych wdrożeń, a w odpowiedzi padło przewidzenie: gdyby były to otwarte wagi, byłyby na Hugging Face, a link byłby w ogłoszeniu. Kilkunastu pisało w tonie: zamknięte, nie dla nich, i przerzuciło się na polecanie sobie nawzajem lokalnych alternatyw. Zostaje stara rodzina: Mini 3B, Small 24B i Mini 4B Realtime, wszystkie z Apache 2.0 (samo Realtime ma ponad 2,2 mln pobrań), nadal dobre do transkrypcji u siebie, tylko bez nowych funkcji trójki. Gdyby Mistral wydał wagi później, ten fragment się zdezaktualizuje; na dziś werdykt brzmi: API, nie pobieranie.
Voxtral 3 po polsku
Z polskiej perspektywy najważniejsze jest jedno: język jest na liście. Polski figuruje w 45-językowej liście FLEURS dla modeli batch i w 35-językowej liście realtime, a sekcja TTS ma polskie demo audio, wypisane wprost w bibliotece języków. Natomiast gotowe presety głosów obejmują 18 języków i polskiego wśród nich brak (są m.in. angielski, niemiecki, francuski, hiszpański, rosyjski, koreański, norweski i wietnamski). W praktyce: transkrypcja po polsku tak, mowa syntetyczna po polsku tak, gotowy głos „po polsku” z presetu nie, trzeba własne nagranie albo inny język presetu.
Polskie media na wieczór 20 października milczały, przynajmniej według Google News, gdzie najnowsze teksty o Voxtralu dotyczyły wariantu arabskiego z 9 października. Jeśli potrzebujesz szerszego tła, jak takie modele wpasowują się w codzienną pracę z językami, spójrz na tekst o AI do tłumaczenia i transkrypcji.
Najczęstsze pytania
Czy Voxtral 3 jest darmowy?
Nie. To płatne API, a wag do pobrania nie ma. Darmowe i otwarte pozostają starsze generacje: Voxtral Mini 3B i Small 24B z 2025 oraz Mini 4B Realtime, wszystkie na Apache 2.0.
Voxtral czy Whisper: co wybrać?
Według tabel Mistrala Small Transcribe 3 ma 4,1% WER na FLEURS wobec 16,0% dla Whisper large-v3, ale to pomiar producenta na czystych nagraniach. Do trudnego materiału (szum, kilka osób, przypadkowe dźwięki) Whisper ma swoją niszę, a lokalnie nadal uruchomisz stare otwarte Voxtrale. Jeśli możesz, przetestuj oba na własnych nagraniach.
Czy Voxtral 3 obsługuje polski?
Tak, w transkrypcji: polski jest na liście 50 języków batch i 35 realtime. Syntezator ma polskie demo audio, ale presety głosów, czyli 18 języków, polskiego nie obejmują.
Czy Voxtral 3 można uruchomić lokalnie?
Na dzień publikacji nie, bo nie ma wag. Wdrożenie „na własnej infrastrukturze” wymaga rozmowy ze sprzedażą Mistrala. Lokalnie nadal działają starsze otwarte wersje, w tym implementacje w czystym C i w przeglądarce.
Ile kosztuje Voxtral 3?
Transkrypcja: 0,0035 USD za minutę (Mini, batch), 0,004 USD/min (Small), 0,008 USD/min (Realtime). Syntezator: 13 USD za 1 mln znaków. Cennika w złotówkach Mistral nie podaje, płatność jest w dolarach.
Czym różni się Voxtral 3 od Voxtral Transcribe 2?
Transcribe 2 był pojedynczym modelem transkrypcyjnym. Trójka to pełna rodzina: dwa modele STT, wersja realtime, syntezator mowy i SDK do agentów głosowych z wołaniem narzędzi i detekcją końca wypowiedzi. Do tego lepsze wyniki w diarizacji: Mini miał w poprzedniej generacji 30,9% cpWER, teraz 18,6%.
Źródła
- Ogłoszenie Voxtral 3 na blogu Mistral AI (cennik, benchmarki, lista języków), odczyt 20.10.2026: https://mistral.ai/news/voxtral-3/
- Karta modelu
voxtral-mini-transcribe-3-0w dokumentacji Mistral (data legalna 20.10.2026, Public Preview, kontekst 32k), odczyt 20.10.2026: https://docs.mistral.ai/models/voxtral-mini-transcribe-3-0/ - Karta modelu
voxtral-small-transcribe-3-0(flagowy STT, 32k, 0,004 USD/min), odczyt 20.10.2026: https://docs.mistral.ai/models/voxtral-small-transcribe-3-0/ - Karta modelu
voxtral-mini-transcribe-realtime-3-0(realtime, 0,008 USD/min), odczyt 20.10.2026: https://docs.mistral.ai/models/voxtral-mini-transcribe-realtime-3-0/ - Lista modeli Mistral z licencjami starszych generacji (Apache 2.0, CC BY-NC 4.0), odczyt 20.10.2026: https://docs.mistral.ai/getting-started/models/
- Wątek „Voxtral 3” na Hacker News, 354 punkty i ponad 90 komentarzy przy odczycie 20.10.2026 ok. 20:10 CEST: https://news.ycombinator.com/item?id=50168396
- Lista modeli organizacji mistralai na Hugging Face, brak repozytoriów Voxtral 3 przy odczycie 20.10.2026: https://huggingface.co/mistralai
- Karta Voxtral-Mini-4B-Realtime-2602 (Apache 2.0, 13 języków, 2,2 mln pobrań), odczyt 20.10.2026: https://huggingface.co/mistralai/Voxtral-Mini-4B-Realtime-2602
- Karta Voxtral-Small-24B-2507 (Apache 2.0, lipiec 2025), odczyt 20.10.2026: https://huggingface.co/mistralai/Voxtral-Small-24B-2507
- Wątek Voxtral Transcribe 2 na Hacker News (1012 punktów, luty 2026, metryki z Algolii), odczyt 20.10.2026: https://news.ycombinator.com/item?id=46886735
- Wątek implementacji Voxtral Realtime 4B w czystym C (antirez, 311 punktów, tytuł i metryki z Algolii), odczyt 20.10.2026: https://news.ycombinator.com/item?id=46954049
- Google News PL, zapytanie „voxtral”, brak polskich doniesień o trójce przy odczycie 20.10.2026 wieczorem: https://news.google.com/rss/search?q=voxtral&hl=pl&gl=PL&ceid=PL:pl