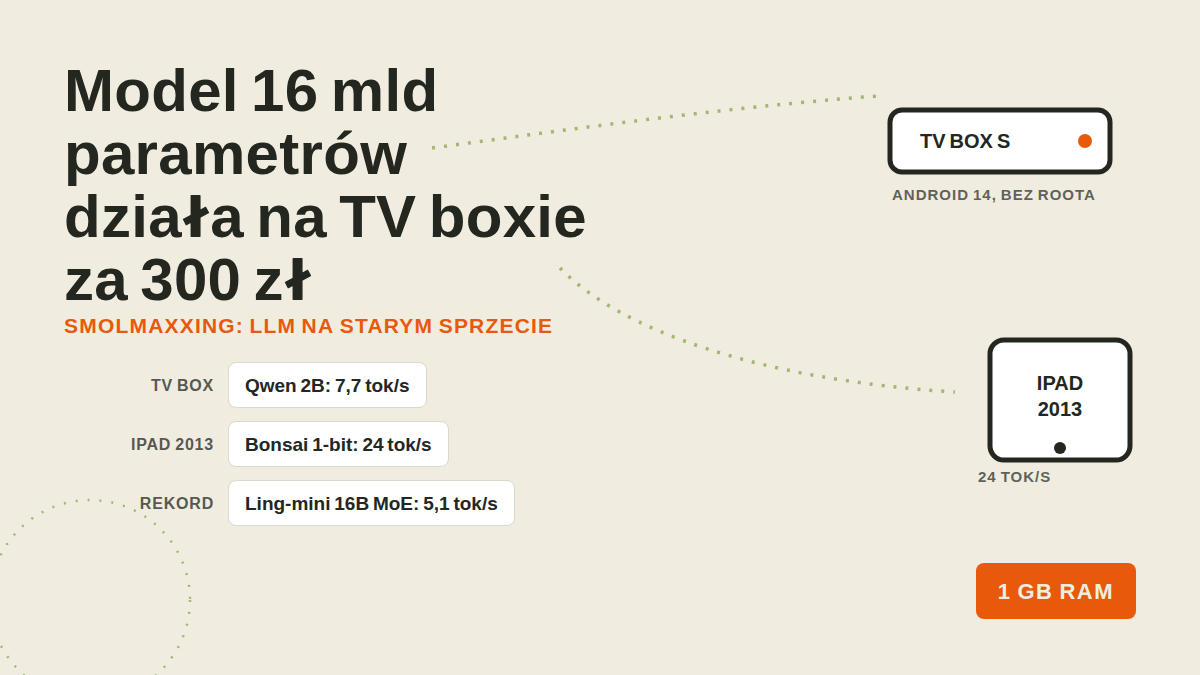
Na Hacker News od 12 listopada krąży projekt o nazwie smolmaxxing: łatka na llama.cpp plus zestaw gotowych plików modeli, które działają na telewizyjnym boxie Xiaomi za poniżej 300 zł i na iPadzie Air z 2013 roku. Wątek zebrał do 13 listopada 355 punktów i 127 komentarzy, a rekord projektu to model Ling-mini-2.0 z 16,3 mld parametrów, generujący na boxie 5,1 tokenu na sekundę przy około 1 GB użytecznej pamięci RAM. Sekret nie polega na cudownej kwantyzacji, tylko na tym, że większa część modelu nigdy nie siedzi w pamięci: eksperci warstwy Mixture-of-Experts są czytane wprost z flasha, który daje 278 MB na sekundę.
Autorem jest Mohammed Rashad z erywańskiego studia Hyperion AI i wszystkie 42 commity w repozytorium podpisuje on sam. Ostatni ma w stopce współautora Claude Opus 5.5, o czym Rashad mówi w dyskusji otwarcie: „yes claude is doing that, and I’m directing it”, czyli „tak, robi to Claude, a ja nim kieruję”. Projekt liczy sobie dziewięć dni, więc to raczej inżynierskie demo niż narzędzie do pracy; sam autor przyznaje, że bez dostrajania do konkretnej domeny małe modele „can’t really do much”. Nie testowałem żadnego z tych urządzeń, bo nie mam ich pod ręką: wszystkie liczby w tym tekście pochodzą z repozytorium i wątku HN, z odczytami z 13 listopada.
- Najważniejsze informacje
- Co to jest smolmaxxing i skąd ta nazwa
- Na czym to działa
- Jak zmieścić model 16 mld parametrów w 1 GB RAM
- Jakie modele pobrać
- Czy to jest użyteczne
- Smolmaxxing w Polsce
Najważniejsze informacje
| Co | Szczegóły |
|---|---|
| Projekt | smolmaxxing, repozytorium hyperionaidev/smolmaxxing, licencja MIT, utworzony 4.11.2026; wątek HN 355 pkt (odczyt 13.11) |
| Największy wynik | Ling-mini-2.0 (MoE, 16,3 mld parametrów, 1,4 mld aktywnych): 5,1 tok/s na TV boxie, 2,6-4,5 tok/s na iPadzie z 2013 |
| Codzienny model | TV box: Qwen3.5-2B, 7,7 tok/s; iPad: Bonsai-1.7B w 1 bicie, 24-26 tok/s |
| Sprzęt | Xiaomi TV Box S 3 gen (Android 14 bez roota, ok. 1 GB użytecznego RAM); iPad Air 1 gen (iOS 12.5.7 z jailbreakiem, ok. 700 MB) |
| Pliki modeli | 8 repozytoriów na Hugging Face, od 248 MB do 5,5 GB; wymagają łatki, stock llama.cpp ich nie ładuje |
| Użyteczność | według autora „just for novelty and fun” bez dostrajania domenowego; testy jakości tylko po angielsku |
| Polska | prasa PL zero notek (Google News, odczyt 13.11); TV Box S bywa poniżej 300 zł (rtvManiaK 11.11) |
Co to jest smolmaxxing i skąd ta nazwa
Nazwa korzysta z internetowego wzorca „-maxxing”, czyli wypychania jednej cechy do granic: tu maksymalizuje się zdolność odpalania LLM-ów na jak najmniejszym sprzęcie. Pierwszy komentarz pod wątkiem od razu przywołał brudną historię tej końcówki (fora incel), na co autor odpowiedział krótko: „it was a fun name… but good point”. W praktyce smolmaxxing to trzy elementy: łatka na llama.cpp 0.8.0 dla Androida, osobna łatka dla iOS 12 i osiem repozytoriów z przerobionymi plikami GGUF na Hugging Face. Zmodyfikowanych plików stockowy llama.cpp nie załaduje, więc sam plik modelu nie wystarcza, trzeba jeszcze zbudować silnik z łatką. Całość stoi na licencji MIT, a obok kodu leży dokument 160 eksperymentów, 107 z TV boxa i reszta z iPada, każdy z własnym pomiarem i numerem.
Współpraca z Claude’em nie jest ukrywana, tylko rozliczana. Rashad opisuje model jako „brute forcing machine”, która dostawała od niego wskazówki zawężające przestrzeń poszukiwań, i liczy pracę w eksperymentach: „107 plus jakieś 50″. To odwrotność zwyczaju z wielu repozytoriów pisanych z pomocą agentów, gdzie wkład AI zostaje zamazany; tutaj człowiek i model mają rozdzielone role wprost, a autorem każdej zmiany w historii git pozostaje człowiek.
Na czym to działa
Dwa urządzenia z dwóch zupełnie różnych światów, jeden zestaw łatek.
| Xiaomi TV Box S (3 gen) | iPad Air (2013) | |
|---|---|---|
| Chip | Amlogic S7D, 4× Cortex-A55 2,5 GHz | Apple A7, 2 rdzenie, NEON bez dotprod |
| RAM | 1,9 GB (użyteczne ok. 1 GB, w trybie headless do ok. 1,3 GB) | 1 GB (użyteczne ok. 700 MB) |
| System | Android 14 bez roota, narzędzia przez adb | iOS 12.5.7 z jailbreakiem Amethyst |
| Codzienny model | Qwen3.5-2B: 7,7 tok/s | Bonsai-1.7B (1-bit): 24-26 tok/s |
| Największy model | Ling-mini-2.0 (16B MoE): 5,1 tok/s | Ling-mini-2.0: 2,6-4,5 tok/s |
Box działa na czystym Androidzie 14 bez roota: narzędzia wchodzą przez adb jako zwykły użytkownik systemu, a serwer z czatem nasłuchuje na lokalnym adresie. iPad wymaga jailbreaku, bo iOS 12 limituje proces na około 1,7 GB mapowanej przestrzeni adresowej i bez przerobienia pliku nie da się nawet otworzyć 5,5 GB modelu; autor przepisał go tak, że eksperci stoją na końcu pliku i czyta je przez pread, po kawałku.
Jak zmieścić model 16 mld parametrów w 1 GB RAM
Trzon pomysłu to stronicowanie ekspertów. Model MoE trzyma w każdej warstwie dziesiątki ekspertów, a na każdy token używa kilku, więc smolmaxxing składa tensory ekspertów na pustej pamięci anonimowej, a po routingu warstwy dogrywa brakujące równoległymi odczytami O_DIRECT prosto na docelowe adresy. W RAM zostaje pula najczęściej używanych ekspertów (przy Moon-Beam-8B: 43 z 128 na warstwę), jeden chybiony odczyt z flasha kosztuje około 6 ms. Do tego dochodzi routing świadomy cache: router dostaje bonus za eksperta, który już siedzi w RAM, więc odsetek chybieniów spada z 13% do około 2%, kosztem pewnej jakości odpowiedzi. Pomysł pochodzi z pracy naukowej z końca 2024 roku (arXiv 2412.00099), a autor dodaje drugą gałkę w postaci zmniejszonej liczby ekspertów na token.
Fizyka i tak stawia sufit. Flash boxa czyta sekwencyjnie 278 MB/s, więc model strimujący X megabajtów na token nigdy nie przekroczy 278/X tokenu na sekundę; to właśnie to, a nie moc procesora, wyznacza granicę dla wszystkiego powyżej klasy 2B. Preładowanie z podglądem routera warstwy wyższej, które łapie około 60% chybieniów zanim będą potrzebne, i spekulacja MTP ratują część tego budżetu: Moon-Beam-8B przyspieszył z 4,4 do 7,2 tok/s.
Pamięć i procesor dostosowują resztę. Repack jąder Q2_K pod instrukcje dotprod podbił generację o 41%, 1-bitowa tablica LUT w stylu T-MAC podniosła Bonsai-8B z 3,77 do 5,1-5,4 tok/s, a przycięta głowa językowa (49-66 tysięcy wierszy zamiast 151-248 tysięcy, słownictwo z angielskiego, kodu i siedmiu języków) dała Qwenowi 0.8B skok z 7,5 do 16,8 tok/s przy koszcie około 1% tokenów EN. Tryb headless, który zatrzymuje launcher, usługi Google i wygaszacz (ten ostatni zjadał 17% rdzenia), sam z siebie podniósł Bonsai-8B z 1,2 do 3,6 tok/s, zanim ruszyły jakiekolwiek kernale.
Najciekawsza lekcja nie dotyczy prędkości. Autor zapisał w dokumentacji, że „perplexity nie widzi pętli”: model z dwubitowymi ekspertami miał dobre wyniki perypleksji i wpadał w pętle w 12 z 13 długich odpowiedzi. Kara za powtórzenia 1,15 co 256 tokenów zbiła degeneracje do 1 na 13. To gotowa przestroga dla każdego, kto ocenia małe modele wyłącznie benchmarkiem.
Jakie modele pobrać
Gotowce stoją w organizacji hyperionaidev na Hugging Face, a liczebność pobrań (74-202 na repozytorium) mówi, że masowo nikt ich jeszcze nie ciągnie. Pięć, które realnie odpalono:
| Model | Rozmiar pliku | Wynik |
|---|---|---|
| Bonsai-1.7B (1-bit, Prism ML) | 248,3 MB | iPad codziennie: 24-26 tok/s |
| Qwen3.5-0.8B (przycięta głowa) | 474 MB | 16,8 tok/s na TV |
| Qwen3.5-2B (przycięta głowa) | 1181,5 MB | TV codziennie: 7,7 tok/s |
| Moon-Beam-8B-A1B (MoE, tablinum) | 2753,2 MB | 7,2 tok/s na TV |
| Ling-mini-2.0 (MoE 16B, Ant Group) | 5487 MB (TV), 5549,9 MB (iPad) | 5,1 tok/s (TV), 2,6-4,5 (iPad) |
Ling-mini-2.0 od inclusionAI, spółki grupy Ant, ma licencję MIT i według karty modelu daje jakość porównywalną z gęstym modelem 7-8B. Rodzina Bonsai od Prism ML jest trenowana od początku pod 1 bit albo ternary i według lekcji autora to właśnie takie modele „utrzymują” ekstremne kwantyzacje, kiedy zwykłe się sypią. Pamiętać trzeba o jednym: to nie są zwykłe pliki GGUF, stock llama.cpp odmówi ich załadowania, więc do pobrania dochodzi budowa silnika z łatką.
Czy to jest użyteczne
Najciekawsza odpowiedź pada ze strony samego autora. „As of now, it’s just for novelty and fun”, napisał w wątku, „bez poważnego dostrajania do danych domenowych małe modele nie potrafią dużo”; dodał, że w dokumentach firmowych dostrojone modele 1-2B robią wąskie zadania bardzo dobrze, a celem projektu jest poznanie granic małych maszyn, żeby techniki skalowały się na laptopy. Komentatorzy są ostrzejsi: „too dumb to use with tools”, a pytanie o naleśnika kończy się „rubbish”; inny przypomina, że „speed means nothing if it gets stuck in doom loops”, podpinając pod to zarzut, że Qwen w rozmiarze 2B nie jest dobrym małym modelem. Oba zarzuty sprowadzają się do jednego: tokenu na sekundę nie czyta nikt, czyta się odpowiedź.
Druga linia krytyki dotyczy autorstwa. „It appears that it’s not you doing that but claude doing that”, zauważył jeden z komentatorów; autor nie zaprzeczył, podał liczbę eksperymentów i zaznaczył, że niczego nie sprzedaje. Gabucino, autor PicoLM (GPT-2 na iBooku PowerPC z 1 GB RAM), przyszedł z technicznym głosem: stare CPU zabija brak instrukcji mnożenia macierzy, a iPad „nie ma matmul, ale są triki”. Granice materiału też trzeba widzieć: pomiarów jest dokładnie dwa, jeden box i jeden tablet, niezależnej replikacji brak, a wszystkie testy jakości są po angielsku. Dyskusja ma zresztą już swoją klamrę: kiedyś pytano „can it run Doom”, teraz pyta „will it run Qwen”, a autor zapowiada kolejny etap, modele mowy działające offline.
Smolmaxxing w Polsce
Polskie media tematu nie zauważyły: Google News po polsku na frazy „smolmaxxing”, „llm na tv boxie” i „llm na starym ipadzie” zwraca 13 listopada zero notek, a najbliższy pokrewny materiał to tekst PurePC z końca 2024 roku o LLM uruchomionym na Windows 98. Sprzęt jest przy tym w Polsce realnie dostępny: nagłówek rtvManiaK z 11 listopada zachęca „Nie wymieniaj telewizora! Xiaomi z Google TV poniżej 300 zł”, więc bariera wejścia jest bliższa cenie słuchawek niż komputera. Podpowiedzi Google nie znają rodziny „LLM na starym sprzęcie”, żyją tylko ogólne „lokalne ai” i „lokalny llm”, które opisujemy w hubie o lokalnym AI; temat jest przed falą, nie w jej środku.
Dwie przestrogi praktyczne z dokumentacji. Interfejs www serwera nie ma logowania i README każe go „nie wystawiać w sieci, której nie ufasz”, więc czat na TV boxie zostaje w sieci domowej albo za VPN-em. Jailbreak iPada nie przeżywa restartu i wymaga zmiany domyślnych haseł root i mobile; to już nie eksperyment, tylko higiena. O polskim języku źródła milczą: przycięta głowa wybiera słownictwo z angielskiego, kodu i siedmiu języków, a polskiego w tej liście może zabraknąć, testów po polsku autor nie robił. Jeśli temat brzmi znajomo, to dlatego, że od strony praktycznej opisujemy go od dawna: od modeli na słabym komputerze, przez BitNet na ESP32, po DeepSeeka na czystym CPU bez karty graficznej.
Źródła
- smolmaxxing: repozytorium (licencja MIT, odczyt 13.11.2026)
- smolmaxxing: jak to działa (odczyt 13.11.2026)
- smolmaxxing: lekcje (odczyt 13.11.2026)
- smolmaxxing: modele i pliki (odczyt 13.11.2026)
- smolmaxxing: iPad Air (odczyt 13.11.2026)
- Dyskusja na Hacker News (355 punktów, 127 komentarzy, odczyt 13.11.2026)
- GitHub API: commity (42 commity, odczyt 13.11.2026)
- Hyperion AI: strona produktu (odczyt 13.11.2026)
- Hugging Face: organizacja hyperionaidev (odczyt API 13.11.2026)
- Hugging Face: Prism ML, modele Bonsai (odczyt API 13.11.2026)
- Hugging Face: Ling-mini-2.0 (odczyt 13.11.2026)
- Google News RSS PL (odczyt 13.11.2026: „smolmaxxing”, „llm na tv boxie”, „llm na starym ipadzie” bez notek)